

前一天已經完成 PostgreSQL 的角色切換,但應用程式若直接連向 pg01,Primary 移到 pg02 或 pg03 後就要人工修改連線位置。今天在服務與後端之間加入代理層,讓 Nginx 將 HTTP 請求分配給 Web 後端,HAProxy 則依 Patroni 回報的角色,把 PostgreSQL 新連線送往目前的 Primary 或 Replica。
正文先說明負載平衡與高可用性解決的不同問題,再從通訊端與連線開始,依序說明 Nginx、HAProxy、資料庫讀寫分離、健康檢查、TLS 終止點與連線重建。最後的 Lab 會建立兩台相同的代理節點,驗證 Web 後端分流、資料庫讀寫入口與計畫性切換期間的連線恢復。
本文閱讀方式
- 完整理解技術與底層原理:依序閱讀全文。
- 掌握完成部署所需的基本概念:優先閱讀標有「⭐」的章節。
- 快速了解當天的部署內容:閱讀文末的 Lab/實作章節。
- 跟著系列建立完整系統:依照 GitHub 詳細部署文件 的天數順序操作。
今天會在 proxy01、proxy02 建立相同的 Nginx 與 HAProxy。兩套代理服務面向不同後端:Nginx 處理 Web HTTP,HAProxy 處理 PostgreSQL TCP 連線。
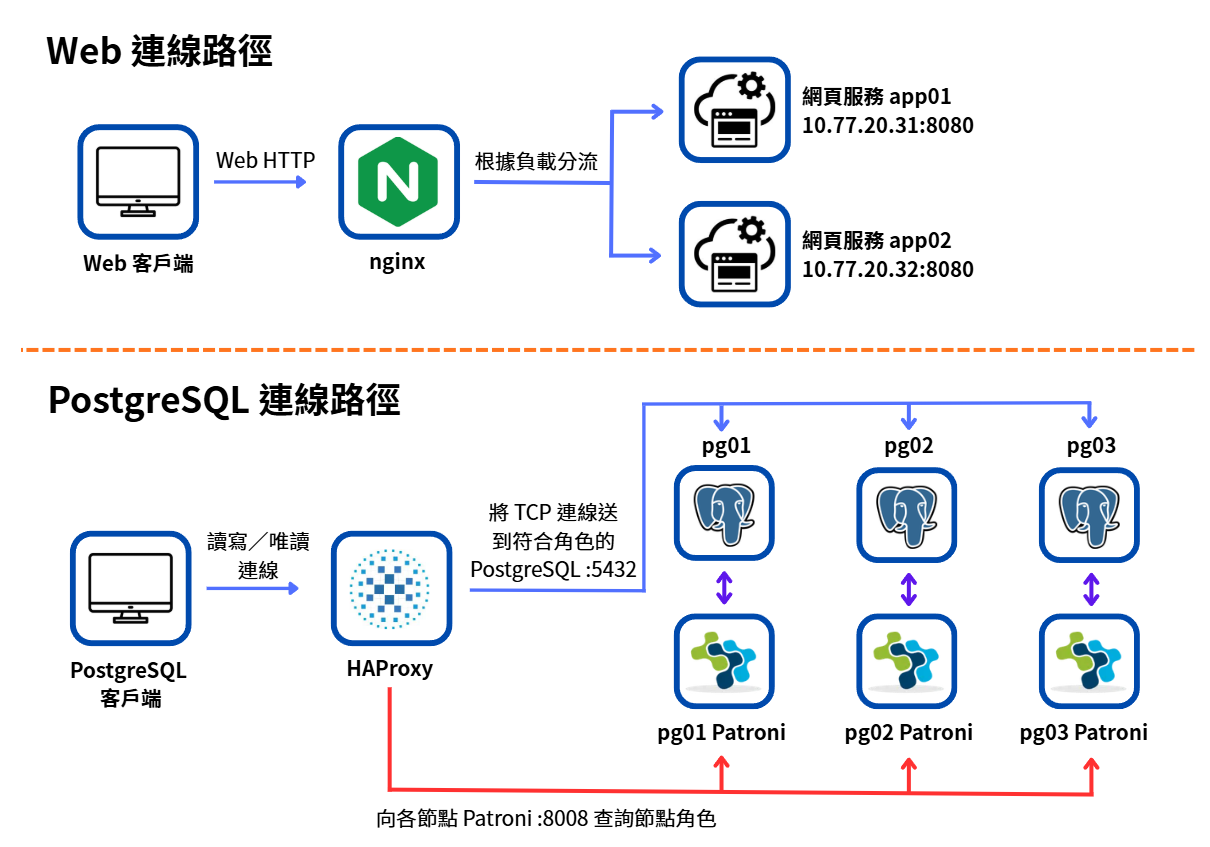
圖(一)Nginx 將 Web 請求分配給應用程式,HAProxy 依 Patroni 角色結果轉送 PostgreSQL 連線
今天先分別驗證兩台代理節點都能完成這兩條路徑。固定服務名稱與代理節點接管會在入口高可用完成後加入。
負載平衡(Load Balancing)是在多台合格的後端(Backend)之間,依輪詢、連線數、權重或其他條件分配新的請求或連線。用戶端只需要連到同一個服務入口,負載平衡器會選擇實際處理工作的節點。
單台服務同時受到運算能力、記憶體、連線數與維護時間限制。加入多台 Backend 後,負載平衡可以帶來三項直接效果:
負載平衡與高可用性(High Availability,HA)關注的問題不同。負載平衡回答如何分配流量。高可用性回答某個元件故障後,整條服務路徑如何繼續提供服務。多台 Backend 能降低後端服務的單點風險,但單台負載平衡器會成為入口的單點。因此今天先讓兩台 Proxy 都具備相同能力,後續再替入口加入自動接管。
服務程序會在指定的 IP 與連接埠建立監聽通訊端(Listening Socket)。用戶端完成 TCP 三向交握後,得到一條連到代理的前端連線。代理選出後端,再建立另一條連線到實際服務。兩段連線具有各自的來源、目的、逾時與生命週期。
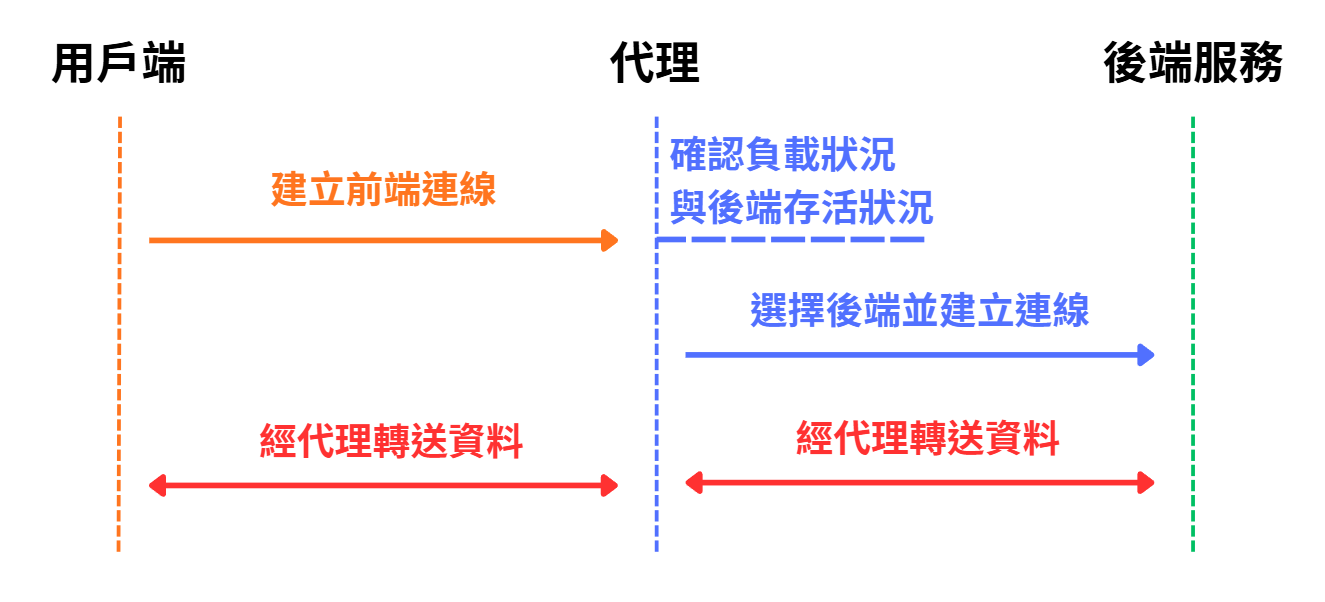
圖(二)代理接收前端連線後,另外建立通往後端服務的連線
代理能用哪些資訊做決定,取決於它處理的協定:
| 處理方式 | 能判讀的資訊 | 本次用途 |
|---|---|---|
| HTTP 反向代理 | Host、URI、標頭(Header)、方法(Method)與狀態碼 | Nginx 將 Web 請求送往 app01 或 app02 |
| TCP 代理 | 來源與目的位址、連接埠及連線狀態 | HAProxy 轉送 PostgreSQL 連線 |
| 外部角色檢查 | Patroni REST API 的 HTTP 狀態碼 | HAProxy 判斷哪台是 Primary 或合格 Replica |
Nginx 能理解 HTTP,因此可以依不同網站或路徑選路。HAProxy 本次以 TCP 模式轉送 PostgreSQL,不解析 SQL。它另外查詢 Patroni,將資料庫角色轉成可供選路的健康狀態。
圖(三)Nginx 在本篇負責接收 HTTP 請求並將流量分配給 Web Backend
Nginx 是網頁伺服器(Web Server),也能作為反向代理、內容快取與 HTTP 負載平衡器。直接提供靜態檔案時,內容由 Nginx 自己回應。作為反向代理時,Nginx 對用戶端表現為服務端,再將請求交給後方的應用程式。用戶端固定連到代理入口,再由 Nginx 選擇 app01 或 app02。
反向代理位於服務端前方,因此適合集中處理網站名稱與 URI 選路、TLS、Header、存取紀錄(Access Log)、逾時和流量分配。本日讓 app01、app02 提供相同的 Web 服務,兩台都是可同時接收請求的 Backend。Nginx 使用 least_conn 將新請求送往目前作用中連線較少的節點。公開網域與 HTTPS 會在外部入口建立後再加入。
Nginx 由主程序(Master Process)讀取設定並管理工作程序(Worker Process),實際請求主要由 Worker 處理。重新載入成功時,新 Worker 會使用新設定接收連線,舊 Worker 則完成既有請求後結束。因此變更流程會先執行 nginx -t,確認語法成立後再重新載入(Reload),避免錯誤設定取代目前可用的服務。
Nginx 作為反向代理(Reverse Proxy)時,先由 listen 接收連線,再以 server_name 選擇虛擬伺服器、用 location 比對 URI,最後由 proxy_pass 將請求送進指定的 upstream。
| 設定項目 | 對應作用 |
|---|---|
listen |
指定接收連線的位址與連接埠 |
server_name |
依請求的網站名稱選擇虛擬伺服器 |
location |
比對請求的 URI |
proxy_pass |
將請求交給指定的 upstream |
least_conn |
從 upstream 選擇目前作用中連線較少的 Web 後端 |
server |
定義 app01、app02 等實際 Web 後端位址 |
Nginx 預設使用輪詢(Round Robin)依序選擇後端。least_conn 會選擇目前作用中連線較少的後端。ip_hash 則傾向讓相同來源位址回到同一台後端。本次 Web 請求的處理時間可能不同,因此使用 least_conn,但它只比較連線數量,不會直接判斷 CPU、記憶體或後端回應速度。
最小設定可以直接對照這條選路流程:
其中 10.77.20.31:8080 與 10.77.20.32:8080 分別是 app01、app02 執行 iron-app 的 HTTP 位址。Nginx 會在這兩個 Web 後端之間分配請求。後面的 HAProxy 章節再說明資料庫連線如何沿著另一條路徑抵達 PostgreSQL。
# 定義兩台應用程式組成的 Web 後端池
upstream iron_backends {
    # 新連線優先交給目前作用中連線較少的節點
    least_conn;

    # 5 秒內累積 2 次失敗時,暫時避開該後端 5 秒
    server 10.77.20.31:8080 max_fails=2 fail_timeout=5s;
    server 10.77.20.32:8080 max_fails=2 fail_timeout=5s;
}

server {
    # 接收送往 web.lab.home 的 HTTP 請求
    listen 80;
    server_name web.lab.home;

    location / {
        # 將所有 URI 交給上方的 iron_backends 後端池
        proxy_pass http://iron_backends;

        # 保留原始網站名稱、來源位址與連線協定供後端判讀
        proxy_set_header Host $host;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
    }
}
upstream 建立可選擇的 Web 後端集合,server 區塊定義接收請求的網站,location 與 proxy_pass 則把符合的 URI 交給該集合。這段只呈現核心關係,完整的連線與讀取逾時依實作文件設定。
proxy_set_header 決定後端收到哪些原始請求資訊。常見設定會保留 Host,並透過 X-Real-IP、X-Forwarded-For 與 X-Forwarded-Proto 傳遞用戶端位址和原始協定。後端只有在請求確實來自受信任代理時,才能使用這些 Header 進行紀錄或安全判斷。
Nginx 開源版的基本 upstream 使用被動健康檢查(Passive Health Check)。真實請求發生連線錯誤或逾時後,max_fails 與 fail_timeout 才會讓 Nginx 暫時避開該後端。沒有請求時,這套機制也沒有新的結果可以判斷。
proxy_next_upstream 可以在特定錯誤下改選其他後端。GET 等冪等請求較適合自動重試。POST、PATCH 等可能改變資料的請求若已送達後端,重送可能造成重複操作。Nginx 預設不會在請求已送出後,把非冪等方法傳給下一台,應用程式需要使用交易識別碼或冪等設計處理結果不明的情況。
負載平衡負責選擇後端。應用程式狀態需要另外共享。登入工作階段、上傳中的檔案或暫存資料若只保存在單一 Web 節點,下一個請求改由另一台處理時可能遺失狀態。可水平擴充的 Web 服務通常會將必要狀態放到共享資料庫、物件儲存或其他外部服務。
圖(四)HAProxy 在本篇負責依 Patroni 角色結果轉送 PostgreSQL 連線
HAProxy 是支援 TCP 與 HTTP 的反向代理和軟體負載平衡器。它從監聽入口接收前端連線,持續檢查 Backend,並依規則與健康狀態選出伺服器,再建立後端連線轉送資料。每筆新連線都可以重新選擇 Backend。已建立的單一連線則維持在同一台伺服器。
HAProxy 的 HTTP 模式可以解析 HTTP 訊息,並依 URL、Header 或 Cookie 選路。TCP 模式則把上層協定視為位元組流,選定後端後讓整條連線維持在同一台伺服器。本日使用 TCP 模式轉送 PostgreSQL,讓 TLS 由資料庫節點處理,HAProxy 不需解析 SQL 或持有資料庫私鑰。
Nginx 與 HAProxy 都具備負載平衡能力,差別來自本系列交給它們的任務:
| 比較項目 | Nginx | HAProxy |
|---|---|---|
| 本篇主要角色 | Web 反向代理與 HTTP 負載平衡 | PostgreSQL 高可用連線入口 |
| 判斷依據 | HTTP 網站、URI、連線數與 Backend 回應 | TCP 連線與 Patroni 回報的資料庫角色 |
| 可用 Backend | app01、app02 可以同時接收請求 | DB-RW 只選目前 Primary。DB-RO 選合格 Replica |
| Backend 改變後 | 後續 HTTP 請求改送其他 Web 節點 | 新資料庫連線改送符合角色的節點 |
因此,Nginx 在本篇著重分散 Web 工作量。HAProxy 著重維持資料庫連線的角色正確性,讓 Primary 切換後的新連線找到新的寫入節點。HAProxy 也會在多台合格 Replica 之間分配 DB-RO 連線。這兩項能力處理的是 Backend 選擇,Proxy 節點本身的高可用則由兩台 Proxy 與固定入口共同完成。
HAProxy 設定通常分成三層:
PostgreSQL 的 Primary 與 Replica 都會監聽 TCP 5432。成功建立 TCP 連線只能證明 PostgreSQL 接受連線,還無法回答該節點目前是否具有寫入角色。Patroni REST API 將角色轉成 HTTP 狀態:
| Patroni 端點 | HTTP 200 的條件 | 適合加入的入口 |
|---|---|---|
/primary 或 /read-write |
PostgreSQL 正常、節點是 Primary,且持有領導鎖 | DB-RW |
/replica |
PostgreSQL 正常、節點是 Replica,且未設定 noloadbalance |
DB-RO |
/replica?lag=64MB |
除了符合 Replica 條件,複寫延遲也低於設定的 64 MB 門檻 | 限制延遲的 DB-RO |
本次 HAProxy 將資料流量送到 PostgreSQL 的 5432,健康檢查則送到同一台主機的 Patroni 8008。資料位址與檢查位址必須指向相同節點:
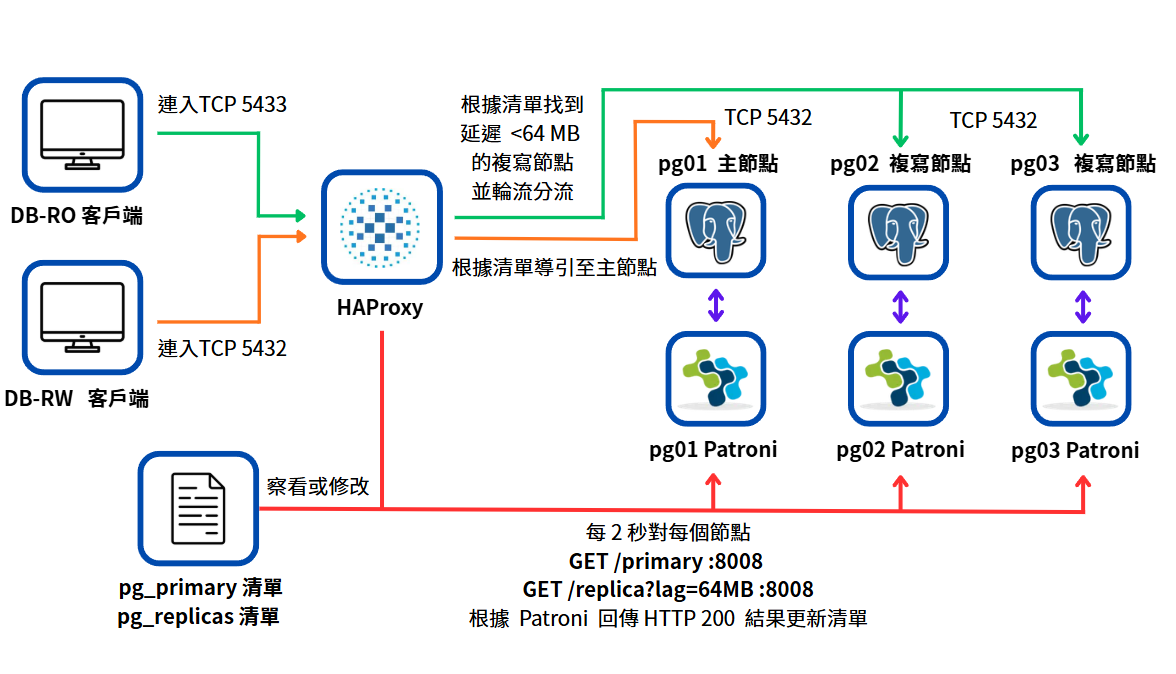
圖(五)HAProxy 先以 Patroni 健康檢查維護後端清單,再將 SQL 連線轉送到符合角色的 PostgreSQL 節點
健康檢查與 SQL 連線是兩條獨立路徑。HAProxy 不會解析 SQL 內容,也不會在每次用戶端連線時才呼叫 Patroni。它會依週期性 HTTP 檢查維護 Backend 的可用狀態,再替新進入的 TCP 連線選擇合格節點。本日以同一台代理節點的 TCP 5432 與 5433 區分讀寫、唯讀入口。建立不同位址的 DB-RW 與 DB-RO VIP 後,兩個入口可以各自使用 TCP 5432。
DB-RO 的選擇分成兩個步驟:Patroni 先以角色、noloadbalance 與 64 MB 複寫延遲門檻篩選合格 Replica,HAProxy 再以 Round Robin 將新連線輪流分配給清單中的節點。延遲門檻用來決定候選資格,不會讓 HAProxy 從中挑選延遲最低的 Replica。
最小設定中的 server 位址指向 PostgreSQL 5432,check port 8008 只改變健康檢查連線的目的連接埠:
# 建立資料庫讀寫入口,接收送往 proxy01 節點 IP 的 PostgreSQL 連線
frontend pg_rw_node
    bind 10.77.20.21:5432

    # 將新連線交給符合 Primary 條件的後端清單
    default_backend pg_primary

# 定義只有目前 Primary 才能加入的後端清單
backend pg_primary
    # 向每台節點的 Patroni REST API 查詢 Primary 角色
    option httpchk GET /primary

    # 只有 HTTP 200 才把該節點視為合格的 Primary
    http-check expect status 200

    # 每 2 秒檢查一次。連續失敗或成功 2 次才改變狀態
    # 節點轉為 DOWN 時,關閉既有連線,讓用戶端重新連線並選擇新 Primary
    default-server inter 2s fall 2 rise 2 on-marked-down shutdown-sessions

    # SQL 資料送往 PostgreSQL 5432,角色檢查則送往同一節點的 Patroni 8008
    server pg01 10.77.30.11:5432 check port 8008
    server pg02 10.77.30.12:5432 check port 8008
    server pg03 10.77.30.13:5432 check port 8008

# 建立資料庫唯讀入口,接收送往 proxy01 節點 IP 的 PostgreSQL 連線
frontend pg_ro_node
    bind 10.77.20.21:5433

    # 將新連線交給符合 Replica 與延遲條件的後端清單
    default_backend pg_replicas

# 定義可承接唯讀連線的 Replica 清單
backend pg_replicas
    # 在所有合格 Replica 之間輪流分配新連線
    balance roundrobin

    # 節點必須是 Replica,且複寫延遲低於 64 MB
    option httpchk GET /replica?lag=64MB
    http-check expect status 200
    default-server inter 2s fall 2 rise 2

    # SQL 資料送往 PostgreSQL 5432,資格檢查送往 Patroni 8008
    server pg01 10.77.30.11:5432 check port 8008
    server pg02 10.77.30.12:5432 check port 8008
    server pg03 10.77.30.13:5432 check port 8008
以 pg01 為例,HAProxy 會向 10.77.30.11:8008/primary 執行 HTTP 檢查。只有回傳 200 時,才把新資料庫連線轉送到同一台主機的 10.77.30.11:5432。因此檢查位址和資料位址必須屬於同一個 PostgreSQL 節點。
inter 決定檢查間隔,fall 要求連續失敗幾次才標記為不可用,rise 則要求連續成功幾次才重新加入。這些參數共同控制抖動容忍度與切換速度,實際感知時間還會受到檢查開始位置及 timeout check 影響,因此應透過故障實驗量測。
PostgreSQL 實體串流複寫會把 Primary 產生的 WAL 傳給 Replica。Primary 接受讀寫交易。啟用熱待命(Hot Standby)的 Replica 在持續重播 WAL 時,可以接受唯讀查詢。這種架構先維持單一寫入來源,再把適合的讀取工作分配給 Replica。
應用程式因此需要兩個穩定入口,清楚表達這次連線預期執行的工作:
Web 入口  → Nginx   → 健康的 Web 後端
DB-RW    → HAProxy → 目前的 Primary
DB-RO    → HAProxy → 延遲符合門檻的 Replica
表(六)Web、資料庫讀寫與資料庫唯讀入口具有不同的後端資格
DB-RW 將需要 INSERT、UPDATE、DELETE 與最新資料的操作送到目前 Primary。DB-RO 則把報表、查詢頁面或其他可接受短暫延遲的唯讀工作分配給 Replica。讀取量明顯高於寫入量時,這種分工可以利用 Replica 的運算與連線容量,減少唯讀查詢和 Primary 上的寫入交易競爭資源。
讀寫分離同時帶來新的資料一致性條件。非同步複寫的 Replica 可能稍微落後,因此剛在 DB-RW 完成的交易,立刻從 DB-RO 查詢時可能尚未出現。需要讀後即見(Read-after-write)一致性的流程,應繼續讀取 Primary,或由應用程式明確等待複寫進度。長時間唯讀查詢也可能和 Replica 重播 WAL 發生衝突,需要依服務需求調整查詢、延遲門檻與 PostgreSQL 參數。
資料庫高可用與讀寫分離會使用同一批 Replica,但目的不同:高可用讓其中一台在 Primary 故障後接手寫入角色。讀寫分離則在正常運作期間使用 Replica 分擔唯讀流量。寫入量為主、要求每次讀取都立即看到最新結果,或尚未建立讀寫路由的系統,可以先讓所有應用連到 DB-RW,再依實際負載決定是否啟用 DB-RO。
所有 Replica 都超過延遲門檻時,本次 DB-RO 入口會快速回報沒有可用後端。若服務需求允許在這種情況下改讀 Primary,可以另外使用 Patroni 的 /read-only 端點建立包含 Primary 的讀取入口。這是服務契約的選擇,不應在同一個 DB-RO 名稱下臨時改變。
本次由三層機制共同限制操作範圍:路由把唯讀連線送到 Replica,PostgreSQL 復原狀態拒絕一般寫入,app_ro 再以唯讀交易設定及較小的資料表權限限制操作。
HAProxy 在建立新連線時選擇 Backend。已經連到舊 Primary 的 PostgreSQL 工作階段會維持原本的 TCP 連線,其中的交易、暫存資料與工作階段設定(Session Setting)也留在該連線。
本次設定在 Primary Backend 使用 on-marked-down shutdown-sessions。當角色檢查把舊 Primary 標記為 DOWN,HAProxy 會關閉通往該伺服器的既有連線。用戶端或連線池收到錯誤後建立新連線,HAProxy 才會將它送往新的 Primary。
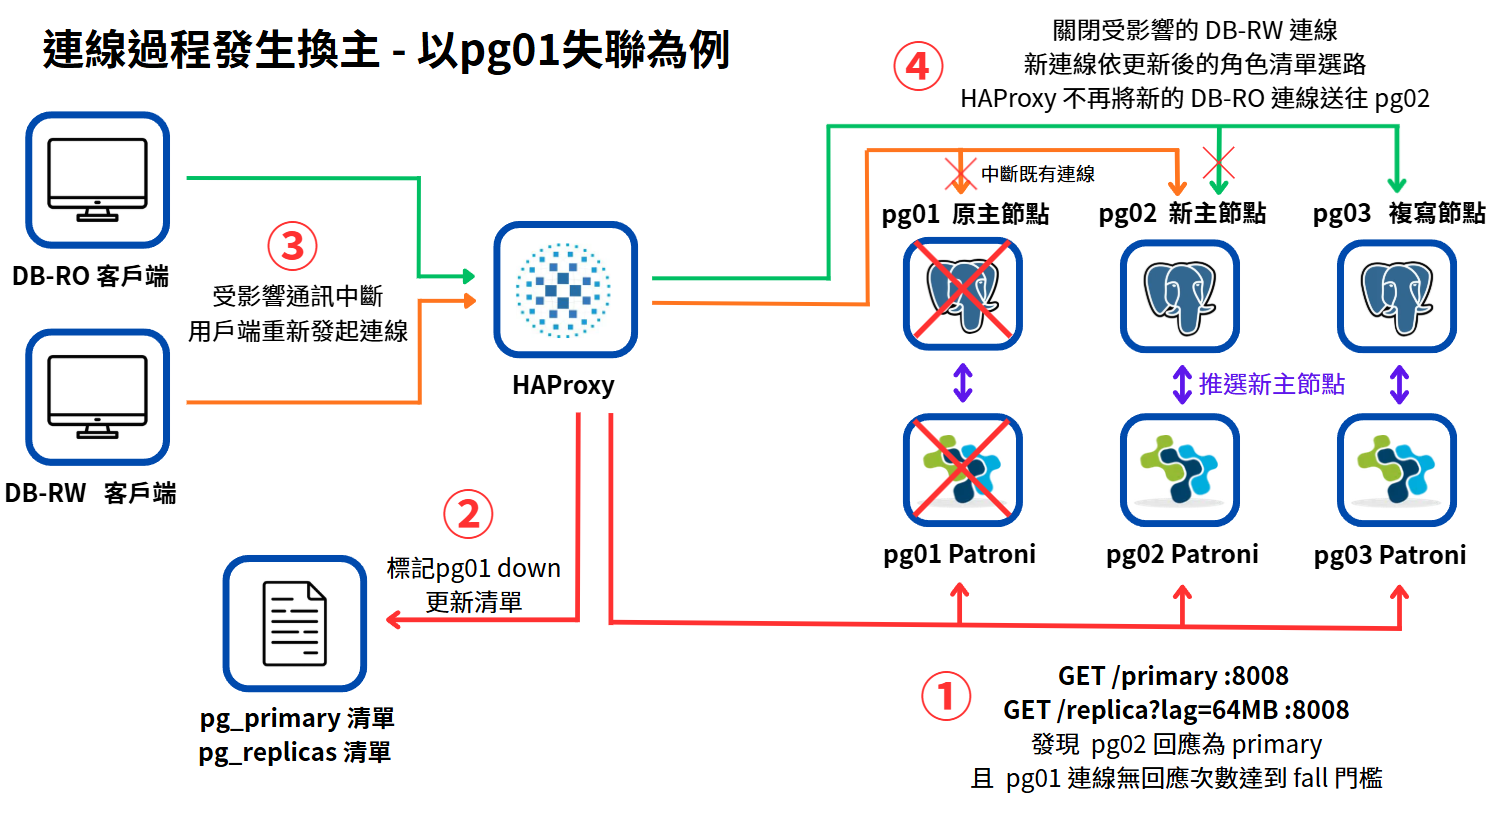
圖(七)舊 Primary 離開讀寫 Backend 後,HAProxy 關閉通往該節點的 DB-RW 連線,新連線再依更新後的角色清單選路
本次只有 pg_primary 設定 on-marked-down shutdown-sessions,因此 HAProxy 會主動關閉通往舊 Primary 的 DB-RW 連線。pg02 升任 Primary 後會退出 pg_replicas,新的 DB-RO 連線會從當下符合 Replica 條件的節點中重新選擇。pg_replicas 會保留既有 DB-RO 連線,直到用戶端主動關閉或連線因其他原因中斷。
未完成交易會隨連線中斷而回復。另一種需要處理的情況是資料庫已完成 COMMIT,但用戶端還沒收到成功結果。應用程式若直接重送,可能執行同一筆業務兩次。合理的連線逾時、退避重連、連線池回收與冪等鍵,都是代理之外需要完成的應用程式責任。
TLS 終止代表某個元件持有私鑰、完成 TLS 握手並取得明文內容。憑證與信任鏈的原理已在 Day19 說明,這裡只確認代理路徑中的終止位置。
| 路徑 | 代理方式 | TLS 終止位置 | 代理能否讀取應用內容 |
|---|---|---|---|
| Web | Nginx HTTP 反向代理 | 本日先使用內部 HTTP。啟用 HTTPS 後由 Nginx 終止 Origin TLS | 可以讀取 HTTP |
| PostgreSQL | HAProxy TCP 模式 | PostgreSQL 節點 | HAProxy 只轉送加密後的位元組流 |
本日資料庫連線暫時以 sslmode=require 要求使用 TLS,但尚未以固定服務名稱完成主機名稱驗證。HAProxy 維持 TCP 轉送,因此 PostgreSQL 憑證與私鑰保存在資料庫節點,HAProxy 不需要取得資料庫私鑰。固定服務名稱建立後,連線會改用 verify-full,同時驗證 CA 信任鏈與憑證中的主機名稱。
proxy01 與 proxy02 會安裝相同的 Nginx、HAProxy 與後端清單。今天使用兩台代理各自的節點 IP 進行測試,確認任一台都能獨立完成 Web、DB-RW 與 DB-RO 路徑。後續再以 Keepalived 和虛擬 IP 將兩台代理組成固定入口,驗證代理節點故障後的入口接管。
設定變更前應先執行語法檢查:
sudo nginx -t
sudo haproxy -c -f /etc/haproxy/haproxy.cfg
語法通過後再重新載入或重新啟動服務,並從實際用戶端路徑驗證。兩台代理的設定內容、版本與變更紀錄也要保持一致,避免入口移動後套用不同的後端或逾時政策。
正文已經說明 HTTP 與 TCP 代理的差異、Patroni 角色檢查及切換後的連線重建。本次 Lab 建立 proxy01、proxy02、app02 與 client01,沿用既有的 app01 與 PostgreSQL 叢集。先確認每一段服務都成立,再透過代理節點 IP 進行 Web 後端停止與 PostgreSQL 計畫性切換。
GitHub 詳細實作文件:Day 25|為 Web 與資料庫建立服務入口:Nginx 負載平衡、TLS 邊界與 HAProxy 讀寫分流
額外量測實作:Day 25|量測代理與應用程式中斷時間
完整文件包含 VM、應用程式角色、HBA、OPNsense 規則、Nginx、HAProxy 與測試指令。正文只整理能驗證核心概念的操作與證據。
兩台代理使用相同設定,因此正文以 proxy01 示範完整的 DB-RW、DB-RO 資料路徑,再以 proxy02 的服務狀態、Web 請求與角色感知 Backend 確認第二台代理具備相同設定能力。
app_owner、app_rw、app_ro 與測試資料表,將兩台 Proxy 來源加入 Patroni 管理的 HBA。/health 回傳實際主機名稱。先確認 proxy01、proxy02 的 Nginx 與 HAProxy 都處於 active,再確認 Web 請求能抵達 app01 或 app02,且兩台代理都能取得一致的 PostgreSQL 角色檢查結果。後面的 DB-RW 與 DB-RO 測試再從 client01 實際建立資料庫連線,確認資料路徑抵達正確角色。
HAProxy Runtime Statistics 應顯示 pg_primary 只有目前 Primary 為 UP / L7OK / 200,pg_replicas 則只有符合延遲條件的 Replica 為 UP / L7OK / 200。
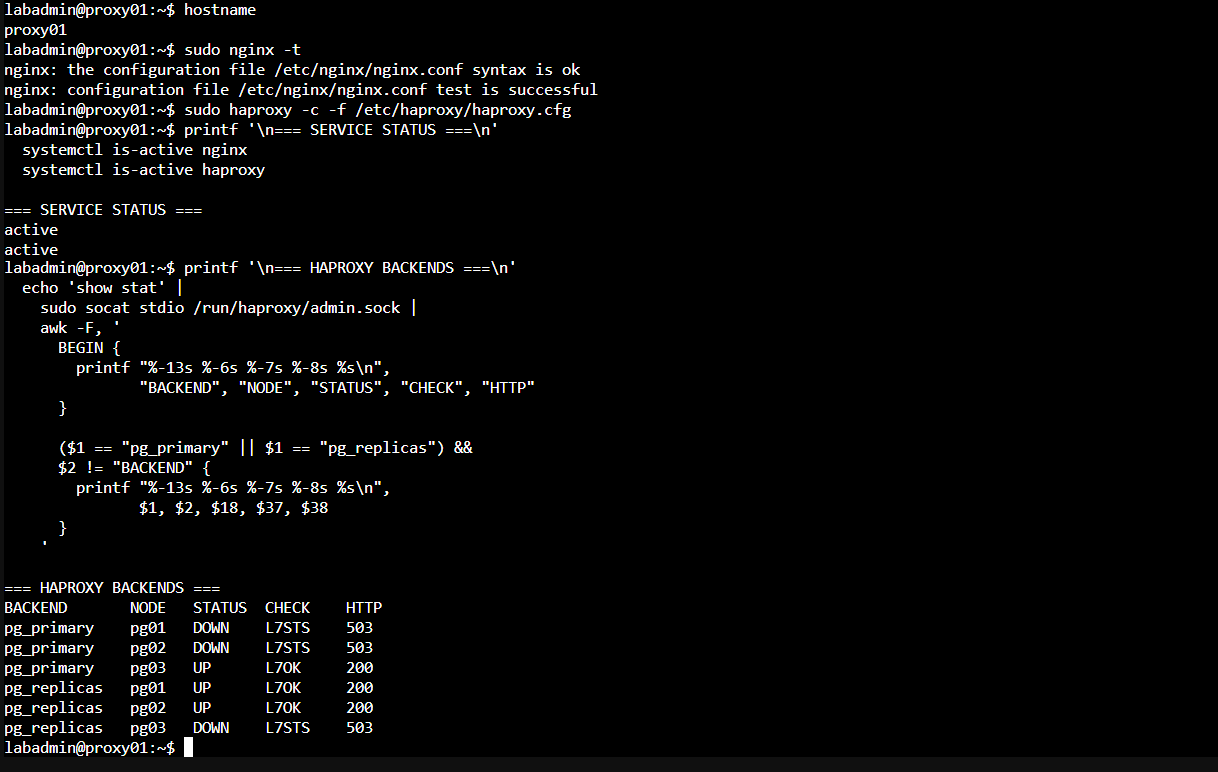
圖(八)proxy01 的 Nginx、HAProxy、監聽入口與角色感知 Backend 均正常運作
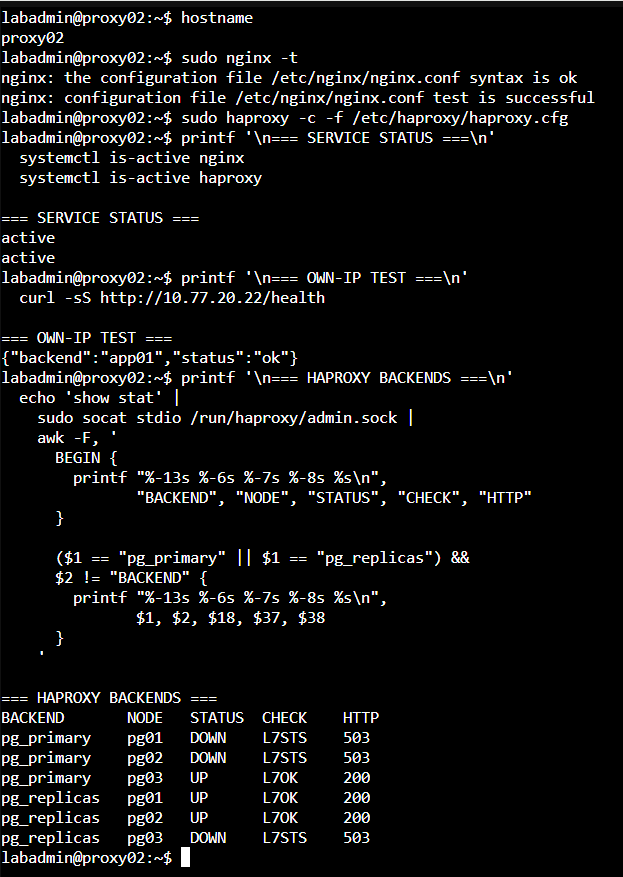
圖(九)proxy02 的 Web 請求與 PostgreSQL 角色感知 Backend 均正常
在 client01 連續請求 proxy01,先確認回應中的 backend 會出現 app01 與 app02。停止 app01 的 iron-app 後繼續送出請求,Nginx 應將後續可成功處理的請求交給 app02。恢復 app01 後,它會再次參與分流。
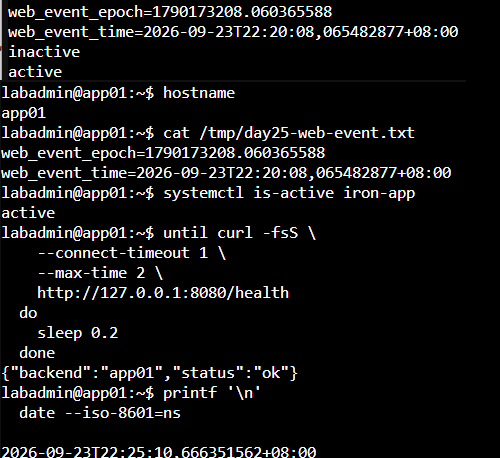
圖(十)app01 的 Web Backend 於記錄時間內停止並恢復
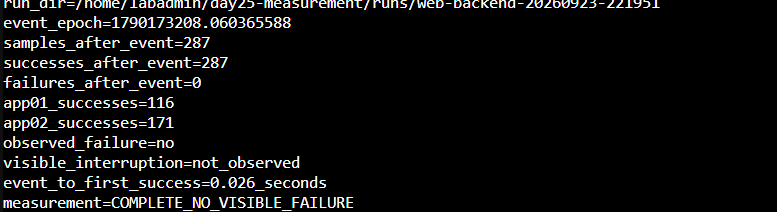
圖(十一)app01 停止期間由 app02 持續回應,且本次未觀察到失敗請求
事件後共取得 287 筆樣本,全部成功,其中 app01 回應 116 筆、app02 回應 171 筆。app01 恢復後也再次出現在回應中。這項結果驗證本次 Nginx upstream、被動失敗判定與 Web Backend 恢復流程。它不包含 proxy01 本身故障後的入口接管。
三台 PostgreSQL 都正常監聽 5432 時,從 Proxy 對三台執行 TCP 測試應全部成功。同一時間,HAProxy 的 pg_primary Backend 只會讓 Patroni /primary 回傳 HTTP 200 的節點保持 UP,其餘節點在這個 Backend 顯示 DOWN / L7STS / 503。
pg_replicas 的結果正好相反:Primary 不符合 /replica?lag=64MB,只有合格 Replica 保持 UP。
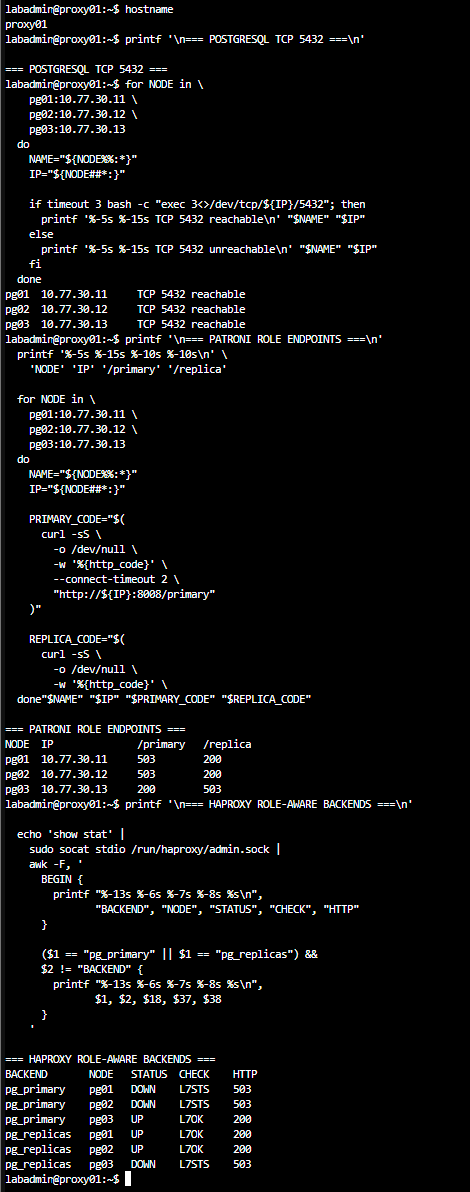
圖(十二)三台 PostgreSQL 均可連線,但 HAProxy 依 Patroni 回報的角色選擇 Backend
這組對照證明 TCP 連通性只能確認服務接受連線,Patroni 角色端點才能替 HAProxy 加入 Primary、Replica 與複寫延遲條件。
從 client01 連到 DB-RW,使用 app_rw 寫入 app.failover_probe,記錄實際 PostgreSQL 主機與 Recovery 狀態。再連到 DB-RO,使用 app_ro 讀取剛才的資料並嘗試寫入。
預期 DB-RW 位於 Primary 且寫入成功。DB-RO 位於 Replica 並可讀取已完成複寫的資料,寫入則由 PostgreSQL 復原狀態或帳號權限拒絕。若最新資料尚未出現,應同時記錄 Replica 的複寫延遲,保留讀後即見差異。
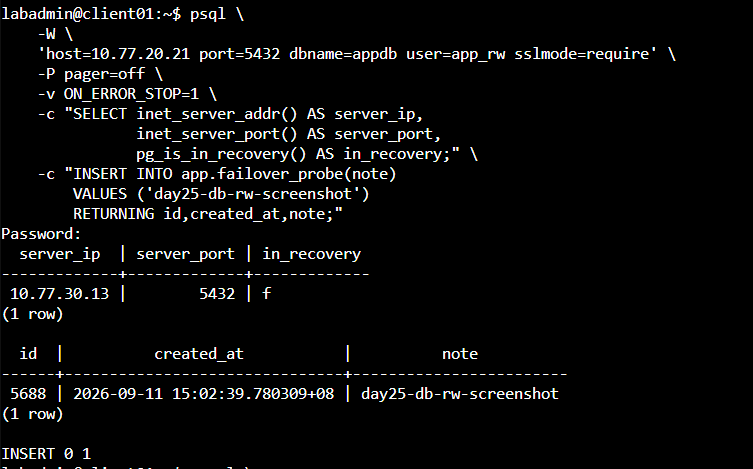
圖(十三)DB-RW 連線抵達 Primary,並成功寫入測試資料
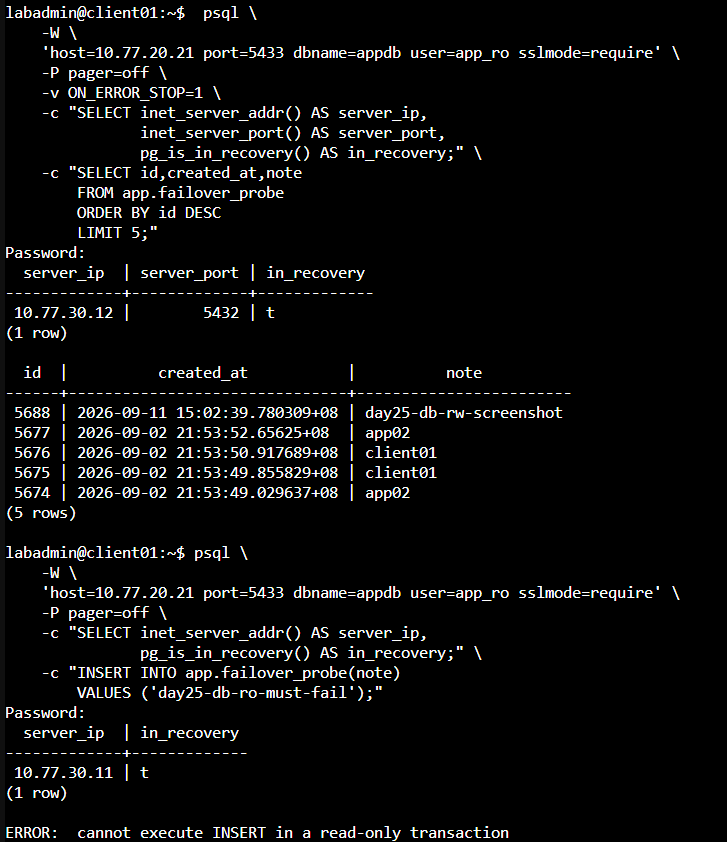
圖(十四)DB-RO 連線抵達 Replica,可讀取資料並拒絕寫入交易
前面的功能驗證與這次切換測試取自不同時間點:功能驗證時 Primary 是 pg03,開始計畫性切換前則是 pg01。每張圖都應依當下的 Patroni 角色分別判讀。
測試先記錄 Patroni 切換前後的叢集狀態,再由 proxy01 同時輪詢舊 Primary、新 Primary 的 /primary 端點與 HAProxy Runtime Statistics。切換前 pg01 是 Primary,切換後由 pg02 接手,三台 PostgreSQL 最後都維持 running 或 streaming。
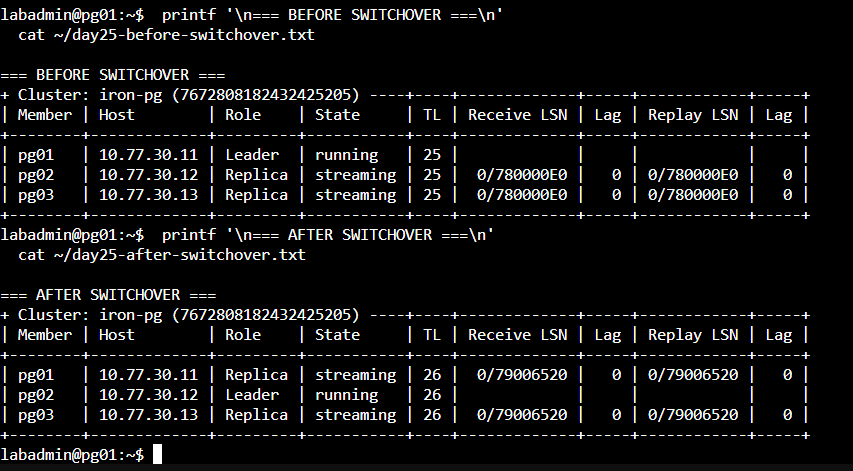
圖(十五)計畫性切換將 Primary 由 pg01 移至 pg02,兩台 Replica 維持串流狀態
角色端點改變後,HAProxy 先保留舊 Backend 的狀態,直到連續健康檢查達到 fall、rise 門檻,才把 pg_primary 的 UP 移至 pg02。此後建立的新資料庫連線會選擇 pg02。
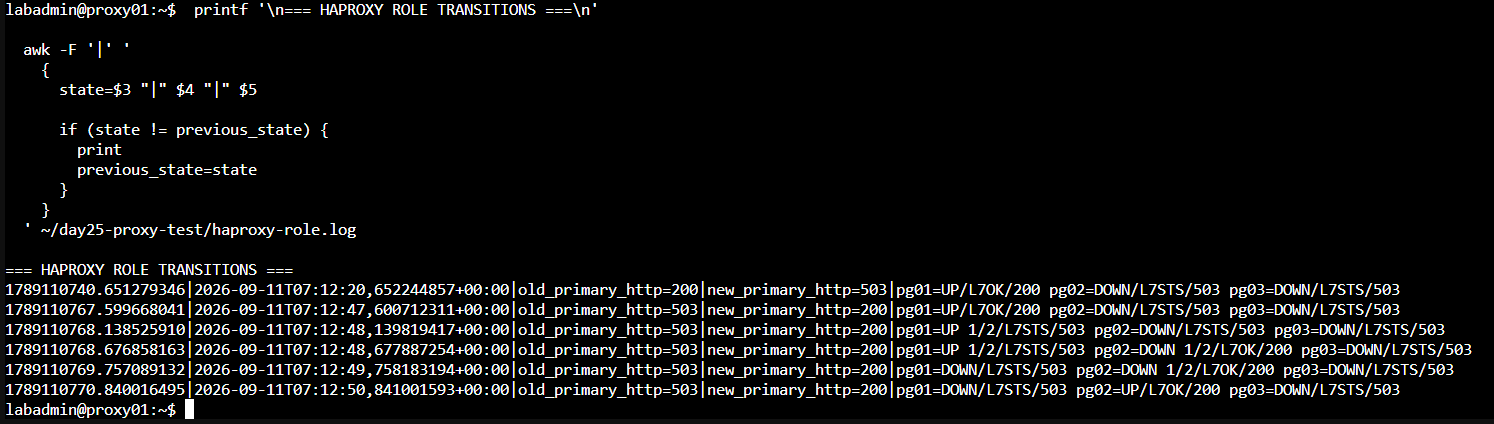
圖(十六)Patroni 角色先改變,HAProxy 再依健康檢查門檻更新 Primary Backend
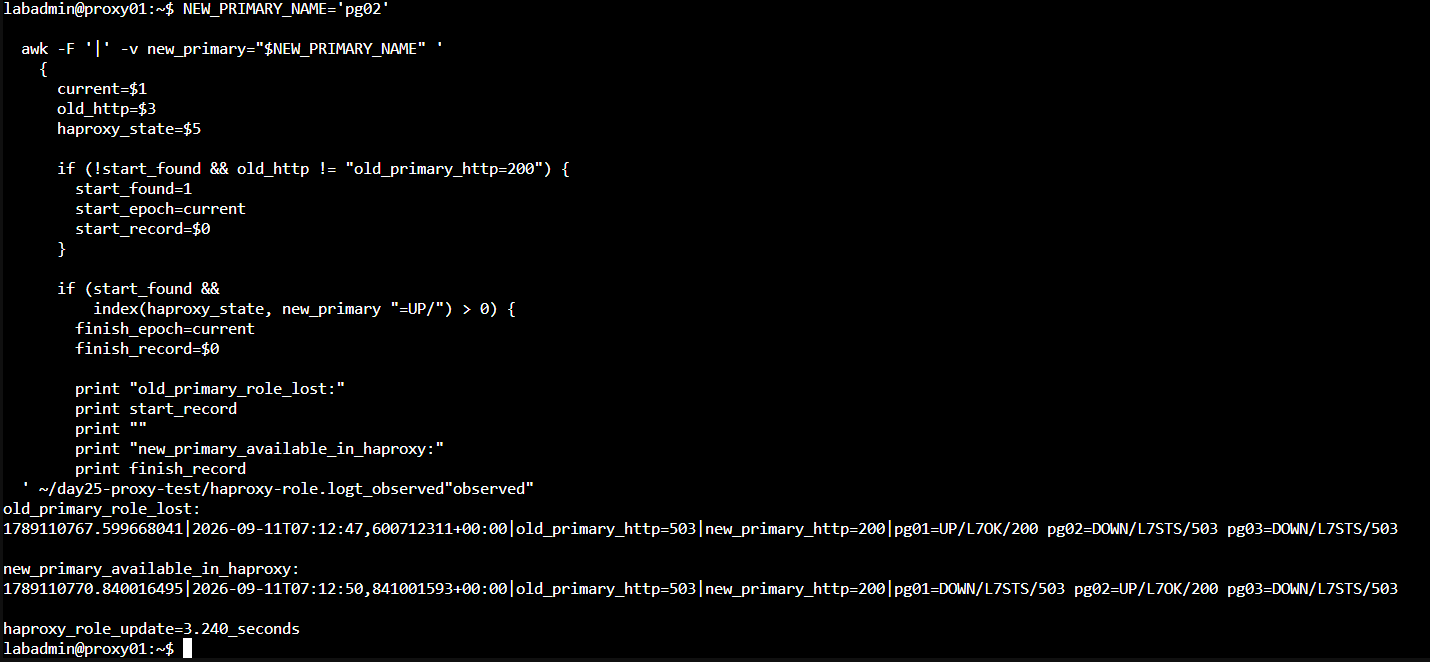
圖(十七)從舊 Primary 失去角色到新 Primary 在 HAProxy 成為 UP 共 3.240 秒
最後由 client01 重新連到 proxy01 的 DB-RW。查詢結果顯示實際資料庫位址是 pg02 的 10.77.30.12、pg_is_in_recovery() = false,後續 INSERT 也成功完成,補齊新連線與實際資料操作的驗證。
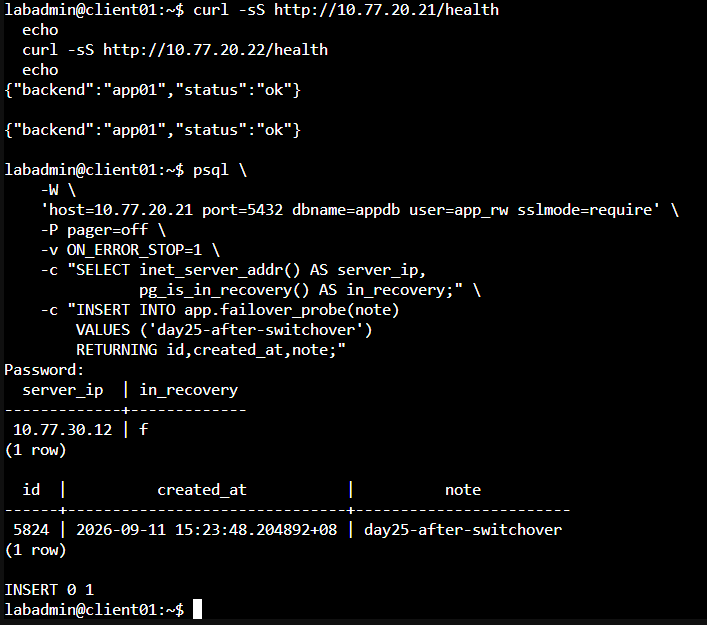
圖(十八)計畫性切換後,DB-RW 新連線抵達 pg02 並成功寫入資料
為了量測使用者實際看到的影響,client01 以 0.2 秒間隔持續呼叫 /health 或 /write。發生失敗後,以連續三次成功中的第一筆作為穩定恢復點。Web 測試的 287 筆樣本全部成功,因此記錄為本次未觀察到可見中斷,不能換算成零秒。
接著再次執行計畫性切換。這次切換前 pg02 是 Leader,pg01 與 pg03 均為 streaming、Lag 0。Patroni 成功將 Primary 切換至 pg01。
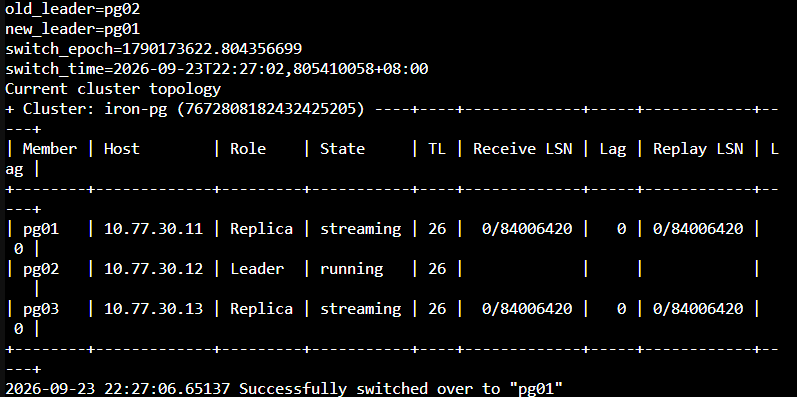
圖(十九)量測在 pg02 為 Leader 時開始,Patroni 成功將 Primary 切換至 pg01
client01 在切換期間共取得 457 筆 /write 樣本,其中 448 筆成功、9 筆失敗。第一個失敗出現在 1790173624.180291653,穩定恢復點為 1790173630.334234476,同一台 client01 計算出的可見中斷為 6.154 秒。畫面中的 event_to_stable_recovery=7.530_seconds 是 PostgreSQL 節點記錄切換事件到 client01 穩定寫入的跨主機參考值。本文以 client01 單機量測的 6.154 秒作為應用程式可寫中斷。
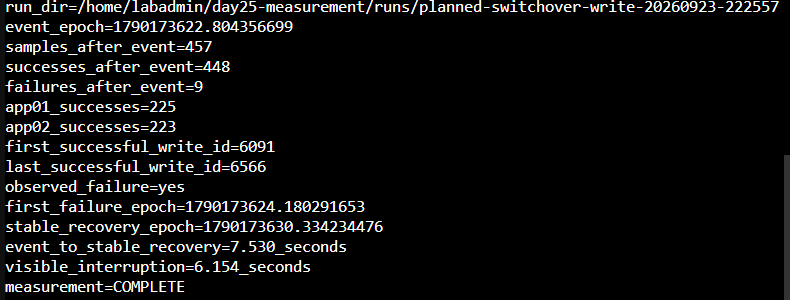
圖(二十)計畫性切換期間出現 9 次寫入失敗,第一個失敗到穩定恢復為 6.154 秒
| 量測項目 | 起點 | 終點 | 本次結果 |
|---|---|---|---|
| HAProxy 角色更新 | 原 Primary 的 /primary 開始回傳 503 |
新 Primary 在 pg_primary 成為 UP |
3.240 秒 |
| 應用程式可寫中斷 | 第一個 /write 失敗 |
新 Primary 上連續三次 /write 成功中的第一筆 |
6.154 秒 |
| 單一 Web Backend 停止時的服務中斷 | 第一個 Web 請求失敗。本次未出現 | 發生失敗後連續三次成功。本次不適用 | 287 筆樣本均成功,本次未觀察到可見中斷 |
三項結果來自分開執行的測試,分別回答 HAProxy 角色清單何時更新、應用程式寫入何時恢復,以及單一 Web Backend 停止時使用者是否看見中斷,不應互相相減或視為同一條時間線。
今天的入口使用 proxy01 或 proxy02 的節點 IP,因此這些結果不包含 Proxy 節點故障、虛擬 IP 接管、DNS、公開 TLS 或外部用戶端路徑。完整服務 RTO 要等固定入口完成後再從用戶端重新量測。
| 類型 | 主要證據 | 可以得到的結論 |
|---|---|---|
| 驗證一:代理節點 | 兩台服務狀態、語法檢查、Web 請求與 Backend 狀態 | proxy01、proxy02 的代理服務與角色檢查均正常 |
| 驗證二:Web 分流 | 後端名稱、停止與恢復結果 | Nginx 能在本次設定中避開停止的 Web Backend |
| 證明一:角色檢查 | 5432 連通性與 HAProxy Backend 狀態對照 | TCP 可達與 PostgreSQL 角色是兩種不同條件 |
| 驗證三:RW/RO | Recovery 狀態、INSERT、SELECT 與拒絕結果 | 本次兩個資料庫入口符合預定操作範圍 |
| 驗證四:角色切換 | Patroni、HAProxy 與切換後的 DB-RW 寫入 | HAProxy 更新 Primary 路徑,新連線可在 pg02 完成寫入 |
| 量測 | Patroni 端點與 HAProxy 時間戳 | 本次 HAProxy 角色更新時間為 3.240 秒 |
| 量測 | client01 的連續 /write 結果 |
計畫性切換期間的應用程式可寫中斷為 6.154 秒 |
rise、fall 與檢查間隔。下一篇是 Day 26|讓代理節點故障後自動接管:Keepalived、VRRP 與三組高可用 VIP。兩台 Proxy 已經具備相同服務能力,接著會用虛擬 IP 建立 Web、DB-RW 與 DB-RO 的固定入口,並驗證 Proxy 節點故障後的接管路徑。


 iThome鐵人賽
 看影片追技術