

前一天已經讓 Nginx 依健康狀態選擇 Web 後端,也讓 HAProxy 依 Patroni 回報的 PostgreSQL 角色分流讀寫連線。用戶端固定連向 proxy01 時,這台代理節點故障便會中斷服務入口,後方健康的服務也無法被使用。
今天要替兩台代理節點建立可移動的固定入口。Keepalived 會透過虛擬路由器備援協定(Virtual Router Redundancy Protocol,VRRP)協調虛擬 IP(Virtual IP,VIP)的持有者,讓 Web、資料庫讀寫與唯讀服務都能沿用固定名稱與位址。
本文閱讀方式
- 完整理解技術與底層原理:依序閱讀全文。
- 掌握完成部署所需的基本概念:優先閱讀標有「⭐」的章節。
- 快速了解當天的部署內容:閱讀文末的 Lab/實作章節。
- 跟著系列建立完整系統:依照 GitHub 詳細部署文件 的天數順序操作。
圖(一)Keepalived 專案標誌
Keepalived 是執行於 Linux 的高可用性與負載平衡管理程式。它本身包含多套可以獨立運作的框架,主要解決兩類問題:由哪一台節點持有服務入口,以及一個入口如何把連線分配給多台後端。
| Keepalived 能力 | 底層機制 | 管理對象 | 主要目的 |
|---|---|---|---|
| 高可用性 | VRRP | 多台入口節點與 VIP | 原持有者故障後,由另一台節點接管相同 IP |
| 負載平衡 | LVS/IPVS | 虛擬服務(Virtual Server)與後端伺服器(Real Server)池 | 將進入 VIP 與連接埠的連線分配給健康後端 |
Keepalived 的設定集中於 /etc/keepalived/keepalived.conf。其中 vrrp_instance 定義一組 VIP 的備援關係。virtual_server 與 real_server 則定義 LVS 的服務入口與後端池,兩種能力可以分開啟用。
虛擬路由器備援協定(Virtual Router Redundancy Protocol,VRRP)是用來提供第一跳閘道備援的標準網路協定。多台節點使用相同的虛擬路由器識別碼與 VIP 組成一個虛擬路由器,再透過優先權與通告選出目前的持有者。VRRP 訊息直接使用 IP Protocol 112 傳送,不使用 TCP 或 UDP 連接埠。
正常狀態由主用節點(MASTER)持有 VIP 並定期發送通告(Advertisement),備援節點(BACKUP)持續接收通告並等待接管。MASTER 失聯或有效優先權降低後,BACKUP 重新收斂角色並取得 VIP。以下沿用設定檔與日誌中的 MASTER、BACKUP 名稱。
Keepalived 在 Linux 上實作 VRRP 狀態機,負責選舉並將 VIP 加入或移出網路介面。VRRP 處理入口位址的歸屬。抵達 VIP 的 HTTP 與資料庫連線,則由該節點上的 Nginx 或 HAProxy 接收並選擇後端。
Keepalived 可以只使用 VRRP 管理 VIP,也可以額外搭配 LVS/IPVS 提供第四層負載平衡。是否啟用這項能力取決於設定內容:只有 vrrp_instance 時,Keepalived 負責入口高可用性。加入 virtual_server 與 real_server 後,Keepalived 才會建立並維護 IPVS 負載平衡規則。
Linux 虛擬伺服器(Linux Virtual Server,LVS)是以 Linux 建立第四層負載平衡的技術架構。IP Virtual Server(IPVS)則是 Linux 核心中的負載平衡子系統,依 VIP:Port、傳輸協定與排程演算法選擇後端並轉送封包。LVS 將執行 IPVS、接收用戶端連線並選擇後端的主機稱為 Director。
Keepalived 可以依健康檢查維護 IPVS 的 Virtual Server 與 Real Server 規則。ipvsadm 則能建立或查看相同規則。三者的關係如下:
| 名稱 | 所在位置 | 角色 |
|---|---|---|
| LVS | 整體技術與架構名稱 | 組合 VIP、Director、IPVS 與 Real Server,形成第四層負載平衡 |
| IPVS | Linux 核心 | 維護 Virtual Server、連線狀態與 Real Server,執行排程及封包轉送 |
Keepalived/ipvsadm |
使用者空間 | 建立、維護或查看 IPVS 規則 |
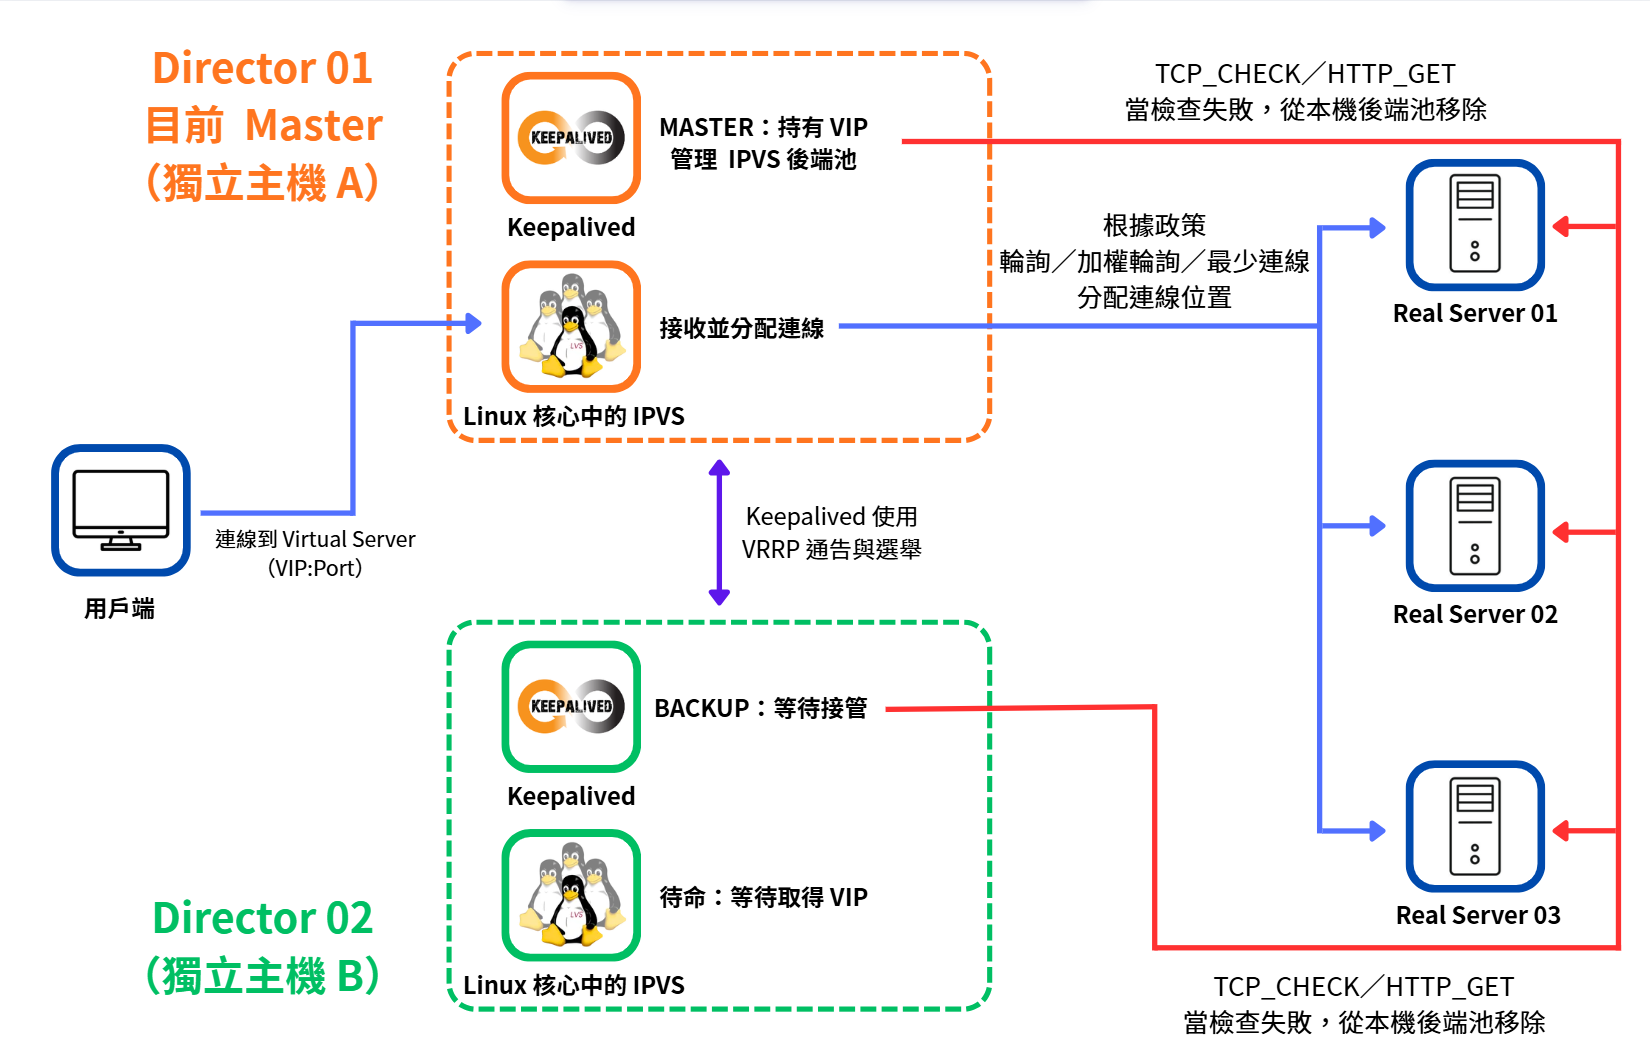
圖(二)VRRP 維持 Director 入口可用性,IPVS 在 Linux 核心分配後端連線
兩台 Director 可以預先載入相同的 IPVS 規則。圖中的待命表示 Director 02 尚未持有 VIP。兩台主機透過 VRRP 組成高可用入口,由目前持有 VIP 的 Director 接收流量,再由本機 IPVS 選擇 Real Server。
Keepalived 的健康檢查會依所在區塊產生不同效果:
| 設定位置 | 檢查失敗後的動作 |
|---|---|
vrrp_script 搭配 track_script |
本次以負權重降低 VRRP 執行個體的有效優先權,促使其他健康節點接管。預設零權重則會使執行個體進入故障狀態(FAULT) |
real_server 底下的 TCP_CHECK、HTTP_GET |
將後端加入或移出 IPVS 後端池,VIP 可以留在原 Director |
本次實作 Keepalived 只啟用 VRRP,不啟用 LVS/IPVS。
設定由 vrrp_instance、vrrp_script 與 track_script 組成。Web 負載平衡與 PostgreSQL 角色分流分別由 Nginx、HAProxy 處理。LVS/IPVS 用來說明 Keepalived 的完整能力,不加入本日資料路徑。
本日資料路徑如下。兩台代理節點都執行 Keepalived、Nginx 與 HAProxy。Keepalived 協調 VIP 歸屬,服務流量直接進入持有 VIP 的代理節點:
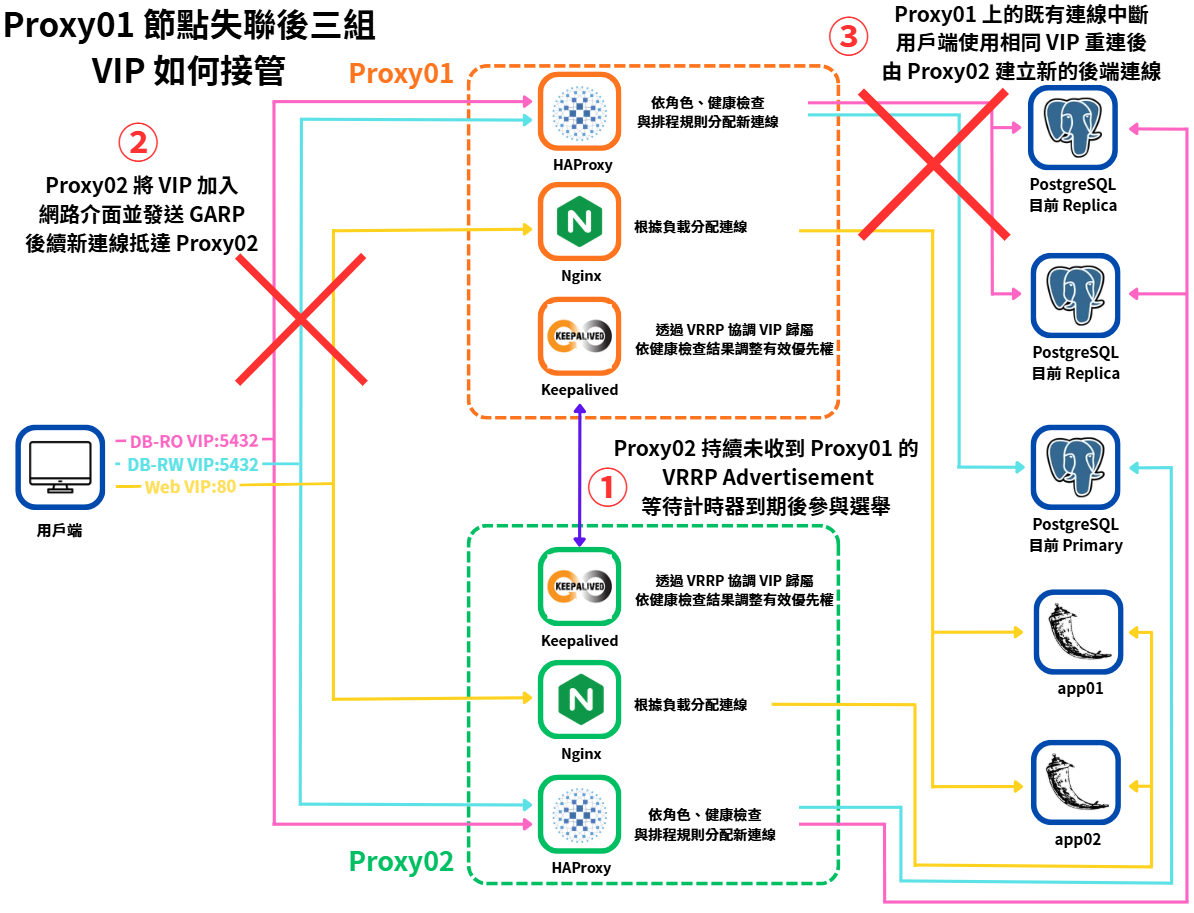
圖(三)proxy01 失聯後,Keepalived 接管三組 VIP,新連線再由 Nginx 與 HAProxy 分別送往 Web 後端與正確的資料庫角色
用戶端只需要記住:
web.lab.home   → 10.77.20.10
db-rw.lab.home → 10.77.20.11
db-ro.lab.home → 10.77.20.12
DNS 負責把服務名稱解析成 VIP。Keepalived 再決定哪台代理節點持有這個 IP。故障切換因此發生在 DNS 解析之下,DNS 記錄不必隨代理節點切換而修改。
同一 IPv4 子網路中的用戶端要傳送封包前,會透過位址解析協定(Address Resolution Protocol,ARP)取得目的 IP 對應的 MAC 位址,並把結果暫存在鄰居快取。一般 IP 長期屬於同一張網路介面。VIP 則會由目前的 VRRP MASTER 加到自己的介面上。
本次 client01 與三組 VIP 都位於 VLAN 20,所以它會直接查詢 VIP 的 MAC 位址。設定未啟用 use_vmac,因此接管時會改用新持有者介面的 MAC:
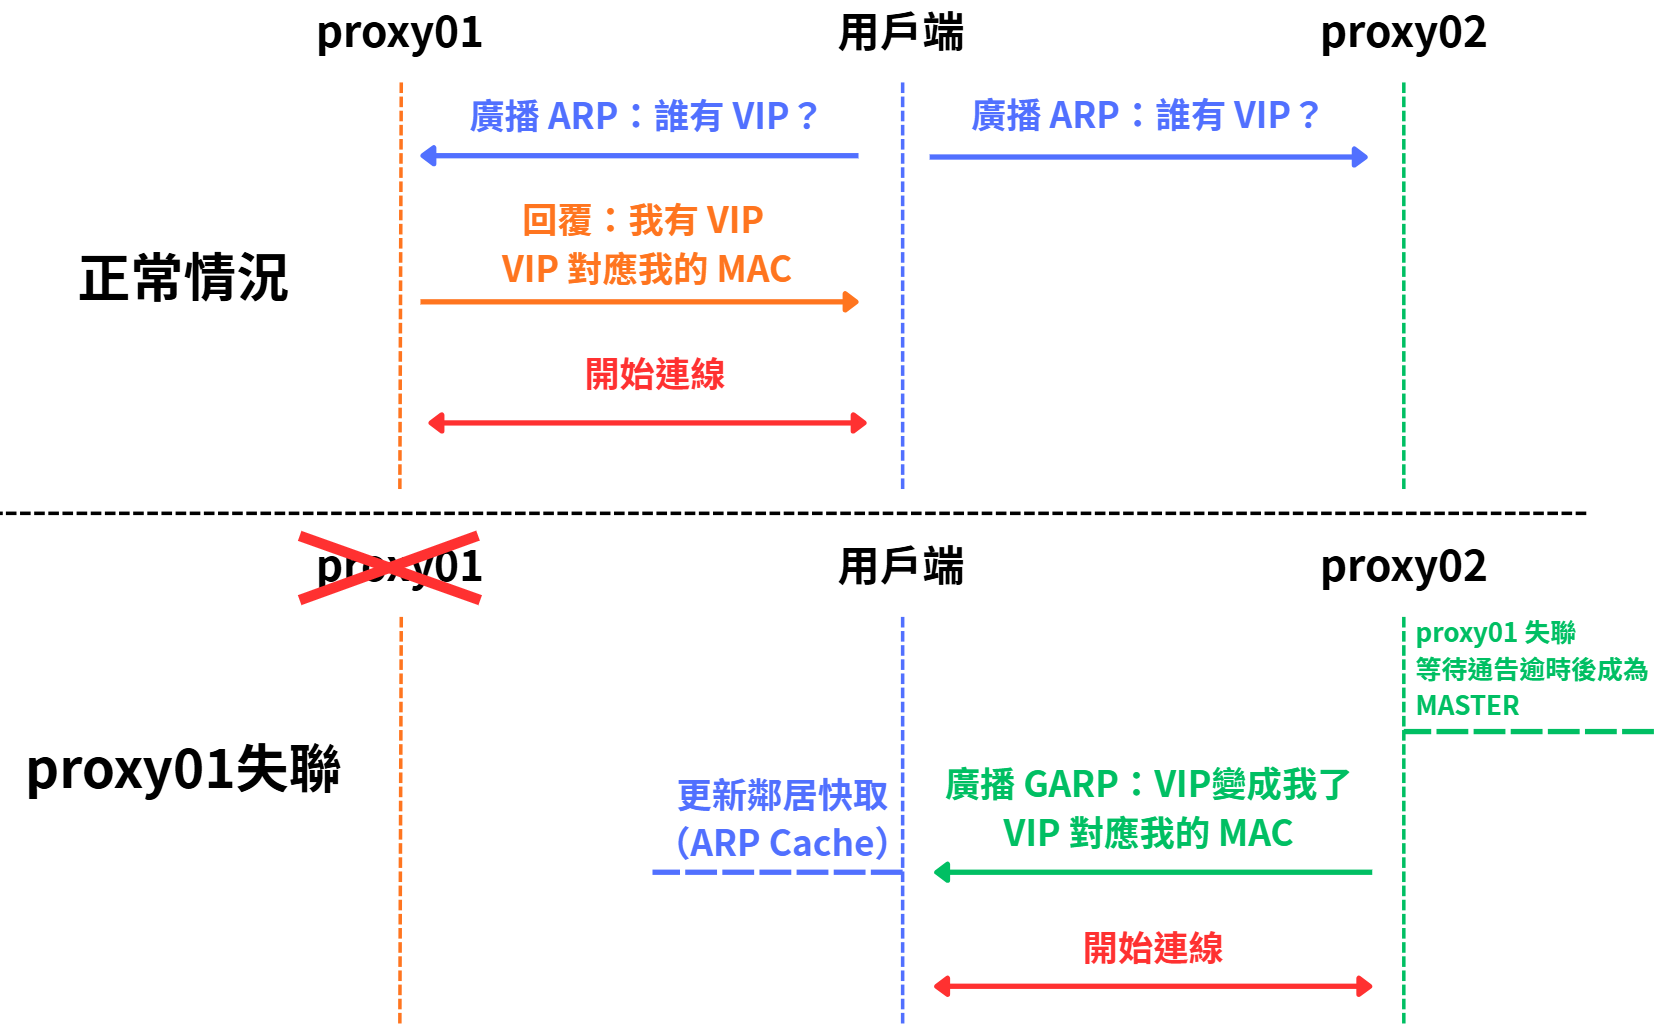
圖(四)VIP 接管後由 GARP 更新用戶端的鄰居快取
GARP 更新鄰居快取中的 VIP 與 MAC 位址對應。路由表負責判斷目的網段及下一跳。
無償 ARP(Gratuitous ARP,GARP)不必等待用戶端先提出查詢,新的持有者可以主動公告 VIP 的新位置。經過路由器或 VPN 進入服務網路的用戶端不會直接查詢 VIP。它先把封包交給自己的閘道,再由服務網路的閘道解析 VIP。兩種路徑都需要服務網路中的鄰居資訊正確更新。
如果虛擬交換器、實體交換器或 Port Security 阻止相同 IP 在節點間移動,Keepalived 即使進入 MASTER,實際封包也可能到不了新的持有者。因此要同時檢查 VIP、VRRP、GARP、鄰居快取與服務請求。
一組獨立參與選舉、管理 VIP 的備援設定稱為 VRRP 執行個體(VRRP Instance)。兩台節點上相互對應的設定使用相同虛擬路由器識別碼(Virtual Router ID,VRID)。MASTER 定期發送通告,BACKUP 收到後更新等待計時器。
| 設定 | 作用 | 本次設定 |
|---|---|---|
interface |
承載 VRRP 與 VIP 的介面 | eth0 |
virtual_router_id |
識別同一組 VRRP 執行個體 | Web 20、DB-RW 21、DB-RO 22 |
priority |
選舉優先權,數值較高者優先 | proxy01 150、proxy02 100 |
advert_int |
MASTER 傳送通告的間隔 | 1 秒 |
unicast_peer |
明確指定 VRRP 對端 | proxy01 與 proxy02 互指 |
virtual_ipaddress |
此執行個體管理的 VIP | .10、.11、.12 |
VRID 的有效範圍為 1 到 255,同一第二層網路中不同 VRRP 群組應避免使用相同 VRID。本次採用單播(Unicast)方式,將通告直接送到指定對端。防火牆須允許 IP 協定編號 112,兩端的來源位址、對端位址、介面與 VRID 也必須互相對應。eth0 則須依實際介面名稱調整。
兩台都設定 state BACKUP,代表服務啟動時先等待既有 MASTER 的通告。持續收不到有效通告時,等待計時器到期的節點會成為 MASTER。實作先啟動 proxy01,流程如下:
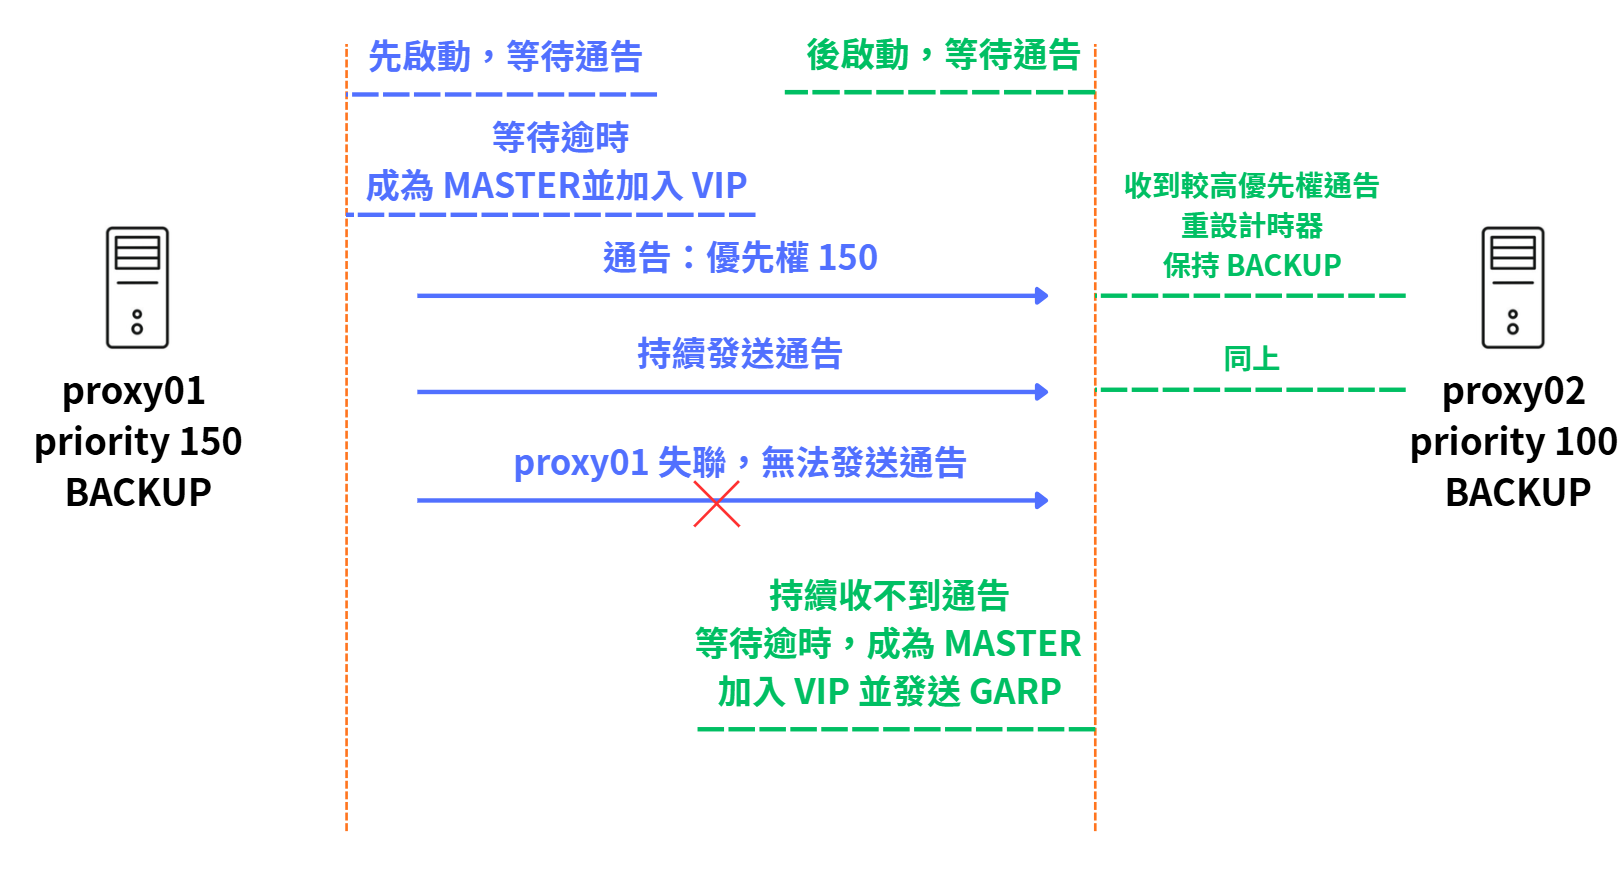
圖(五)兩台代理節點透過 VRRP 收斂成一個 VIP 持有者
BACKUP 主要接收通告,選舉透過優先權與計時器收斂。實作使用 IPv4 且未指定版本,依 Keepalived 預設採 VRRPv2。其失聯等待時間可依 RFC 3768 表示為:
失聯等待時間 = 3 × 通告間隔 + 優先權偏移時間
優先權偏移時間 = (256 − BACKUP 優先權) / 256 秒
以通告間隔 1 秒、BACKUP 優先權 100 計算,從最後一次有效通告起約等待 3.609 秒。這只涵蓋通告失聯的判定。完整服務恢復還包含健康檢查、位址接管與用戶端重試。正常停止 MASTER 時,可透過優先權 0 的通告通知交接,接手時間也會與突然失聯不同。
只看功能需求時,使用 HAProxy+Keepalived 就能完成這套入口:HAProxy 同時代理 HTTP 與 PostgreSQL,Keepalived 則讓 VIP 在兩台代理節點之間接管。本系列拆成三個元件,是希望讓讀者分別實作三種常見技術:Nginx 的 HTTP 反向代理、HAProxy 依應用狀態選擇 TCP 後端,以及 Keepalived 的 VRRP 入口高可用性。
這種安排也讓每一層的判斷更容易觀察。Nginx 處理 Web 路由、標頭與後端選擇。HAProxy 依 Patroni 狀態選擇 PostgreSQL 角色。Keepalived 只根據本機代理服務決定 VIP 歸屬:
| 元件 | 觀察與選擇的對象 | 主要處理的故障 |
|---|---|---|
| Nginx | app01、app02 | 單一 Web 後端故障 |
| HAProxy | Patroni API 回報的 PostgreSQL 角色 | Primary 切換、Replica 健康與延遲 |
| Keepalived | proxy01、proxy02 的本機代理服務 | 代理程序或代理節點故障 |
Nginx 與 HAProxy 的能力有一部分重疊:HAProxy 也能代理 HTTP,Nginx 的 Stream 模組也能轉送 TCP。選型重點是讓健康條件、設定語意與故障範圍保持清楚:
| 方案 | 可以處理的工作 | 在本系列中的取捨 |
|---|---|---|
| 全部交給 Nginx | HTTP 反向代理與 TCP Stream 代理 | PostgreSQL 需要另外設計 Patroni 角色、Replica 延遲與讀寫入口的判斷,代理節點間也需要 VIP 接管機制 |
| HAProxy+Keepalived | HAProxy 同時處理 HTTP、TCP 負載平衡與健康檢查,Keepalived 負責 VIP 接管 | 技術上完整可行,元件較少。本系列為了分別示範 HTTP 反向代理、PostgreSQL 角色分流與 VRRP,保留 Nginx 處理 Web |
| 改用 IPVS | 在 Linux 核心依 VIP:Port 執行高效率的第四層連線分配 |
HTTP 路徑與標頭需要第七層代理。Patroni 角色與延遲條件也要轉換成 IPVS 後端池政策,Director 的入口高可用性則由 VRRP 提供 |
| Nginx+HAProxy+Keepalived | 分別處理 Web、資料庫角色與 VIP | 健康檢查能對準各自服務,Web、DB 與整台代理節點的故障範圍也能分開驗證 |
因此,本次組合同時服務教學廣度與職責分工。實際環境可以統一使用 HAProxy+Keepalived,或重新設計 Nginx Stream/IPVS。選型時需一併完成 PostgreSQL 角色判斷、代理入口接管與相同層級的驗證。
例如 app01 停止時,只要 proxy01 的 Nginx 還能把請求送往 app02,Web VIP 可以留在 proxy01。PostgreSQL 發生 Primary 切換時,HAProxy 會依 Patroni 健康檢查更新合格後端,DB-RW VIP 也可以留在原代理節點。
後端切換優先由代理處理。VIP 是否移動,則取決於 Keepalived 追蹤的檢查結果。
Linux 的 net.ipv4.ip_nonlocal_bind=1 允許 HAProxy 在本機尚未持有 DB VIP 時先建立監聽端點(Listener)。如此一來,BACKUP 可以預先啟動 HAProxy,取得 VIP 後接受新連線。這個參數負責放寬位址綁定限制。服務可用性需由健康檢查與用戶端請求確認。
Keepalived 透過 vrrp_script 定期執行檢查,再由 track_script 將結果納入指定 VRRP Instance 的有效優先權,讓選舉反映代理服務的健康狀態。
本次使用兩個 Shell 腳本,再分別由 vrrp_script 名稱 chk_nginx 與 chk_haproxy 呼叫:
check-nginx:確認 Nginx 的 systemd 狀態,並向該代理節點自己的 /health 發出 HTTP 請求。check-haproxy:確認 HAProxy 的 systemd 狀態,並透過本機管理通道(Runtime Socket)讀取 Stopping: 0,確認程序未進入停止狀態。實作以 Unix Socket /run/haproxy/admin.sock 存取。/health 會由 Nginx 轉送到 Web 後端,所以也會受後端故障或延遲影響。如果兩台代理共用的後端全部失敗,移動 VIP 也無法修復後端。HAProxy 腳本只檢查本機程序。資料庫角色與可連線性由 HAProxy 後端檢查及用戶端 SQL 驗證。
兩個檢查都每 2 秒執行一次,單次最多等待 2 秒。連續失敗或成功 2 次才改變健康狀態,用來過濾一次短暫波動。失敗後會從有效優先權扣除 80,因此 proxy01 會從 150 降至 70,低於健康 proxy02 的 100,再由 proxy02 接管相應 VIP。完整參數會在下一節的最小設定中呈現。
健康腳本的範圍要對準 VIP 所代表的本機能力。檢查外部 DNS 或過多遠端服務,可能把遠端短暫延遲誤判成代理故障。只檢查程序名稱,又可能忽略設定錯誤或 Listener 無法接受請求。
負權重是降低選舉優先權。如果兩台代理節點的同一項服務都失敗,兩邊可能同時降低優先權,其中一台會繼續持有 VIP。因此看到 VIP 存在只能證明入口位址有持有者,還要從用戶端執行 HTTP 或 SQL 才能證明服務可用。
以下擷取 proxy01 的 Web VIP 設定,呈現本日最重要的關係。vrrp_script 定義檢查方式,track_script 再把檢查結果交給 WEB_VIP 執行個體:
vrrp_script chk_nginx {
    script "/usr/local/sbin/check-nginx"  # 執行本機 Nginx 與 /health 檢查
    interval 2                             # 每 2 秒排程一次
    timeout 2                              # 單次最多等待 2 秒
    fall 2                                 # 連續 2 次失敗才判定失敗
    rise 2                                 # 連續 2 次成功才恢復健康
    weight -80                             # 失敗時從有效優先權扣除 80
}

vrrp_instance WEB_VIP {
    state BACKUP
    interface eth0
    virtual_router_id 20                  # 兩端相同,識別同一組 Web VIP
    priority 150                          # proxy01 為 150。proxy02 為 100
    advert_int 1

    unicast_src_ip 10.77.20.21            # 本機代理節點位址
    unicast_peer {
        10.77.20.22                        # 對端代理節點位址
    }

    virtual_ipaddress {
        10.77.20.10/24 dev eth0            # web.lab.home 使用的 VIP
    }

    track_script {
        chk_nginx                          # 將檢查結果納入本組選舉
    }
}
proxy02 使用相同 VRID 與 VIP,並將本機位址、對端位址及優先權分別改為 10.77.20.22、10.77.20.21 與 100。DB-RW、DB-RO 採相同結構,改用各自的 VRID、VIP,並共同追蹤 chk_haproxy。完整設定及兩台節點的差異請依實作文件操作。
三組 VIP 使用不同 VRID 與 vrrp_instance,讓 Web 與資料庫代理服務各自反映本機健康狀態:
| 服務名稱 | VIP | 監聽端點 | 健康條件 | 本次移動方式 |
|---|---|---|---|---|
web.lab.home |
10.77.20.10 |
TCP 80 | 本機 Nginx 與 /health |
可單獨移動 |
db-rw.lab.home |
10.77.20.11 |
TCP 5432 | 本機 HAProxy | 與 DB-RO 受同一故障觸發 |
db-ro.lab.home |
10.77.20.12 |
TCP 5432 | 本機 HAProxy | 與 DB-RW 受同一故障觸發 |
DB-RW 與 DB-RO 共同追蹤 chk_haproxy,它會呼叫 /usr/local/sbin/check-haproxy。HAProxy 程序停止時,兩組 DB VIP 都會觸發接管,但各自選舉,完成時間可能略有差異。Nginx 停止時則只影響 Web VIP。注意 DB-RO VIP 使用 TCP 5432,代理節點本身的唯讀測試入口才是 TCP 5433。
| 故障事件 | Keepalived 的預期動作 | 由其他元件處理 |
|---|---|---|
| app01 停止 | Web VIP 留在原代理節點 | Nginx 改送 app02 |
| PostgreSQL Primary 切換 | DB VIP 留在原代理節點 | HAProxy 更新 DB-RW 後端 |
| proxy01 的 Nginx 停止 | Web VIP 移到 proxy02 | DB 入口維持 |
| proxy01 的 HAProxy 停止 | DB-RW、DB-RO VIP 移到 proxy02 | Web 入口維持 |
| proxy01 整台停止 | 三組 VIP 都移到 proxy02 | proxy02 接手代理入口 |
如果希望多個 VRRP Instance 共同轉換狀態,Keepalived 也提供 vrrp_sync_group。本次要觀察 Web 與資料庫代理故障的不同範圍,因此讓三組 VIP 分別選舉。
代理節點故障後,恢復流程依序經過:
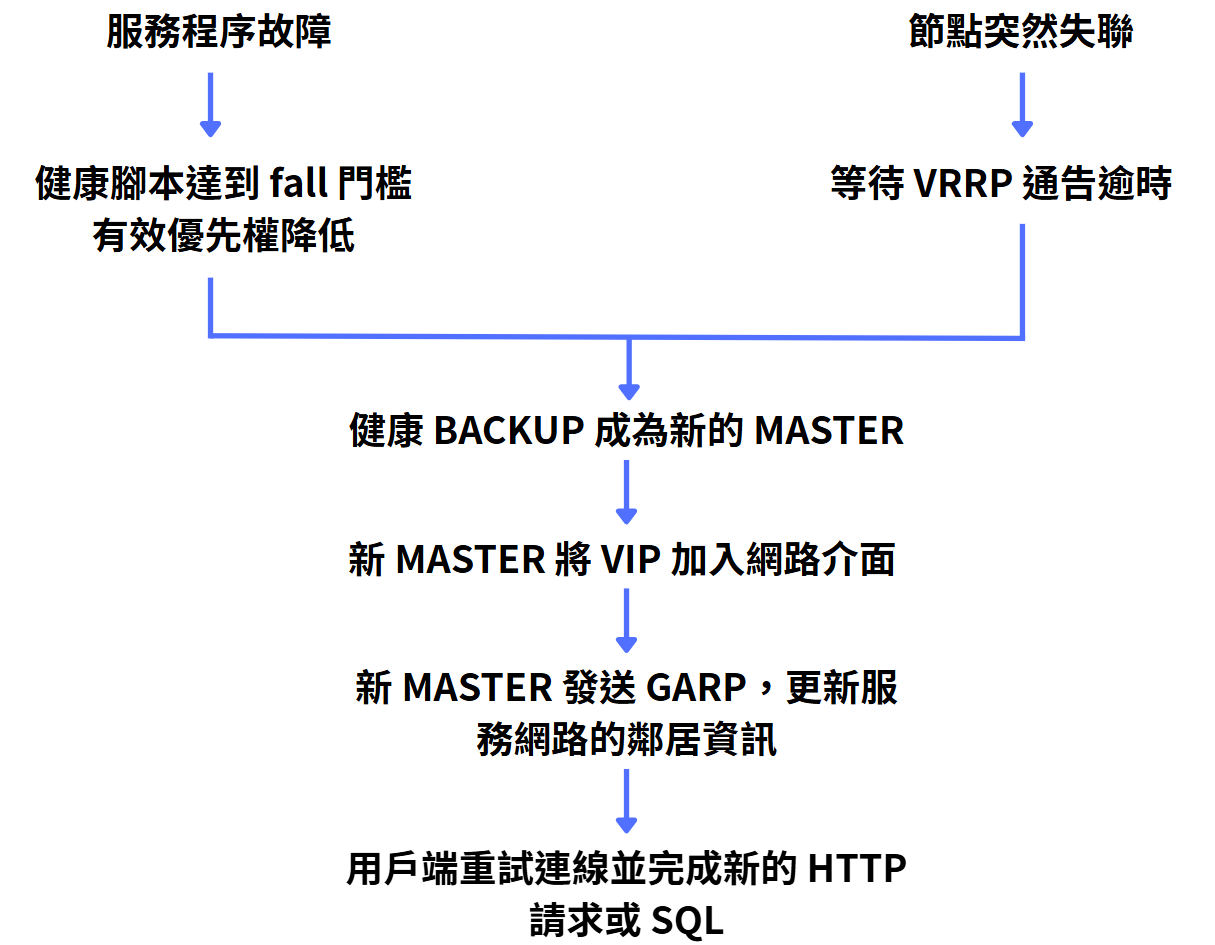
圖(六)從故障偵測到用戶端服務恢復的完整接管路徑
Keepalived 移動的是 IP,Nginx 或 HAProxy 已建立的 TCP 連線狀態不會同步到另一台代理節點。故障當下的既有 HTTP 或 PostgreSQL 連線可能中斷。具備重試機制的用戶端會透過同一個服務名稱重新連向新的持有者。
本次保留預設搶占(Preemption)行為。較高優先權的 proxy01 恢復並重新通過健康檢查後,會再次取得 VIP,形成第二次接管。這能讓服務回到偏好的拓樸,也會產生一次額外連線波動。重視穩定性多於固定主節點的環境,可評估 nopreempt 並配合變更流程決定何時回切。
正常收斂後,同一組 VIP 應由一台代理節點持有。若兩台之間的 Unicast VRRP 被網路規則阻擋,兩邊都可能看不到對方的 Advertisement,並各自判定自己應成為 MASTER。
此時即使 PostgreSQL 只有一台 Primary,同一 VIP 也可能由兩個 MAC 位址回覆,造成 ARP 映射反覆改變與連線不穩。這是代理入口層的分裂腦(Split Brain)。
判讀時要把下列證據放在同一條時間線:
ip address 顯示的 VIP 持有情況。兩台長時間同時持有相同 VIP 時,應先停止其中一台 Keepalived,再檢查介面、VRID、Unicast Peer 與 IP Protocol 112 的通訊路徑。
Keepalived Log 的狀態切換時間只涵蓋控制面。ip address 看到 VIP 只涵蓋位址接管。使用者真正關心的是請求何時重新成功,因此本次從用戶端持續執行三種探測:
/health,確認 HTTP 狀態及回應內容。db-rw.lab.home 查詢 pg_is_in_recovery(),預期得到 f。db-ro.lab.home 查詢 pg_is_in_recovery(),預期得到 t。實作手冊的迴圈是每次請求完成後等待 1 秒,實際採樣間隔還包含請求耗時。SQL 角色查詢能驗證連線與角色。若要量測寫入服務恢復,應改用能確認提交成功的測試交易。
建議以第一次服務探測失敗為中斷起點,以切換後連續三次成功回應為恢復點:
服務中斷時間
= 切換後連續三次成功中的第一次成功時間 - 第一次失敗時間
連續三次成功可以降低單一偶發回覆造成的誤判。先訂定 RTO,再以相同探測條件下的實測結果比較。
這項量測需要額外保存每次請求的開始與完成時間、成功或失敗結果,並設定完整請求逾時。主實作手冊的一秒畫面迴圈適合觀察接管。本篇再用 0.2 秒探測與自動分析腳本計算中斷秒數。
另外記錄故障注入時間,可以拆出兩個角度:
| 指標 | 起點 | 終點 | 用途 |
|---|---|---|---|
| 故障到恢復 | 執行停止服務或關機 | 切換後第一次穩定成功 | 觀察完整接管流程 |
| 可見中斷 | 第一次失敗 | 切換後第一次穩定成功 | 觀察用戶端實際影響 |
本次在 proxy01、proxy02 安裝 Keepalived,建立 Web、DB-RW、DB-RO 三組 VIP。完成正常基準後,依序停止 proxy01 的 Nginx、HAProxy,再關閉整台 proxy01,從 client01 持續觀察三種服務並記錄恢復時間。
GitHub 實作文件:Keepalived 與三組 VIP 詳細部署步驟
實作順序如下:
ip_nonlocal_bind。先確認兩台 Keepalived 設定通過檢查,而且 Nginx、HAProxy、Keepalived 都處於 active。穩定收斂後,proxy01 應持有 .10、.11、.12,proxy02 不應持有其中任何一個 VIP。
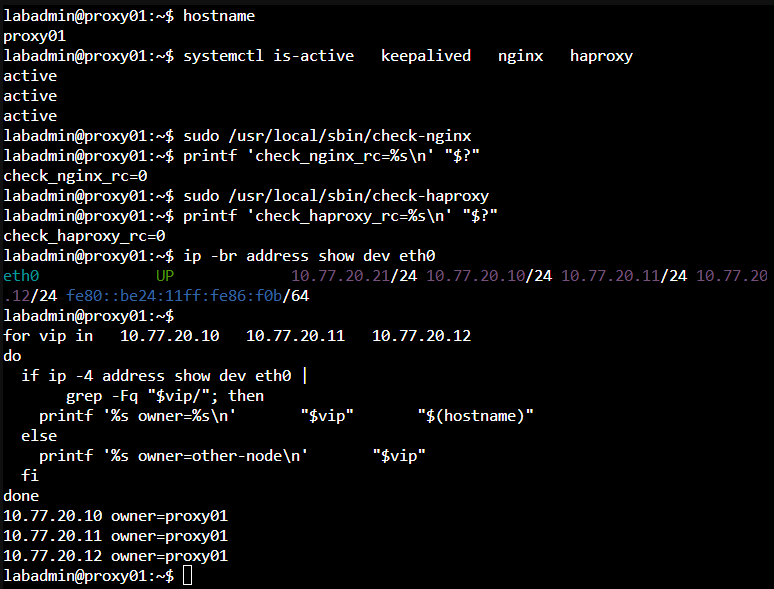
圖(七之一)proxy01 的三個服務與健康腳本皆正常,並持有三組 VIP
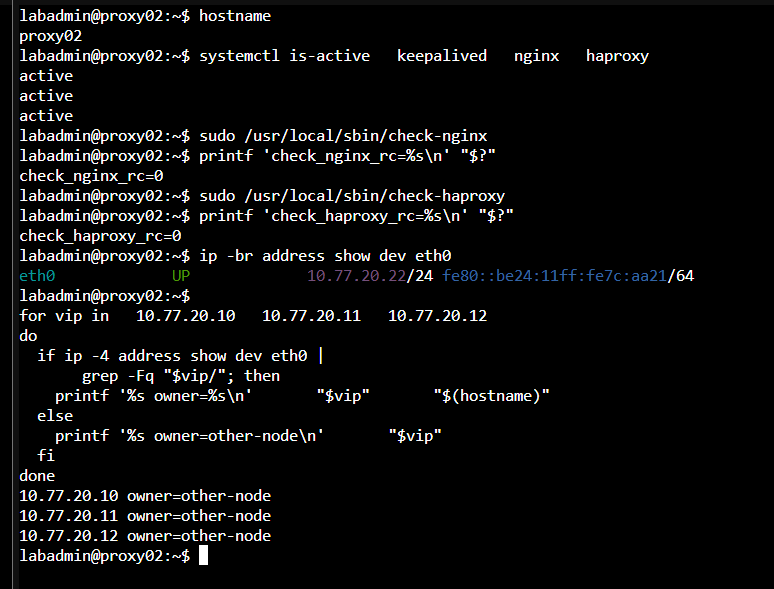
圖(七之二)proxy02 的三個服務與健康腳本皆正常,穩定狀態下未持有 VIP
這項結果驗證優先權與三組 VRRP Instance 已按本次規格收斂。它也建立後續故障測試的正常基準。
在 proxy02 擷取 IP 協定編號 112 與 ARP 封包,再正常停止 proxy01 的 Keepalived。預期可看到原 MASTER 發送優先權 0 的交接通告,接著由 proxy02 成為 MASTER 並送出 GARP。若測試突然斷電或通訊中斷,則觀察收不到通告後的逾時接管。兩種結果須分開記錄。
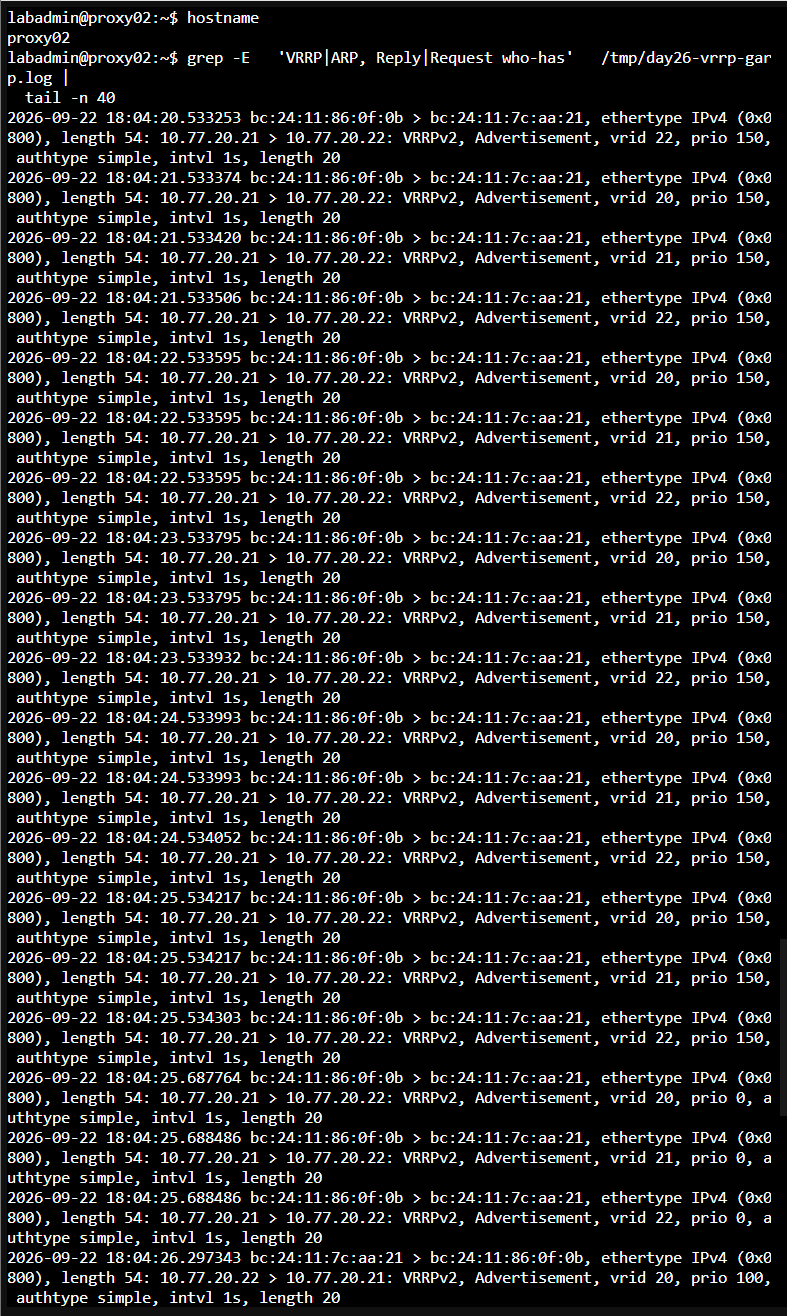
圖(八之一)proxy01 正常停止 Keepalived 時送出優先權 0 的 VRRP Advertisement,proxy02 隨後開始以優先權 100 通告
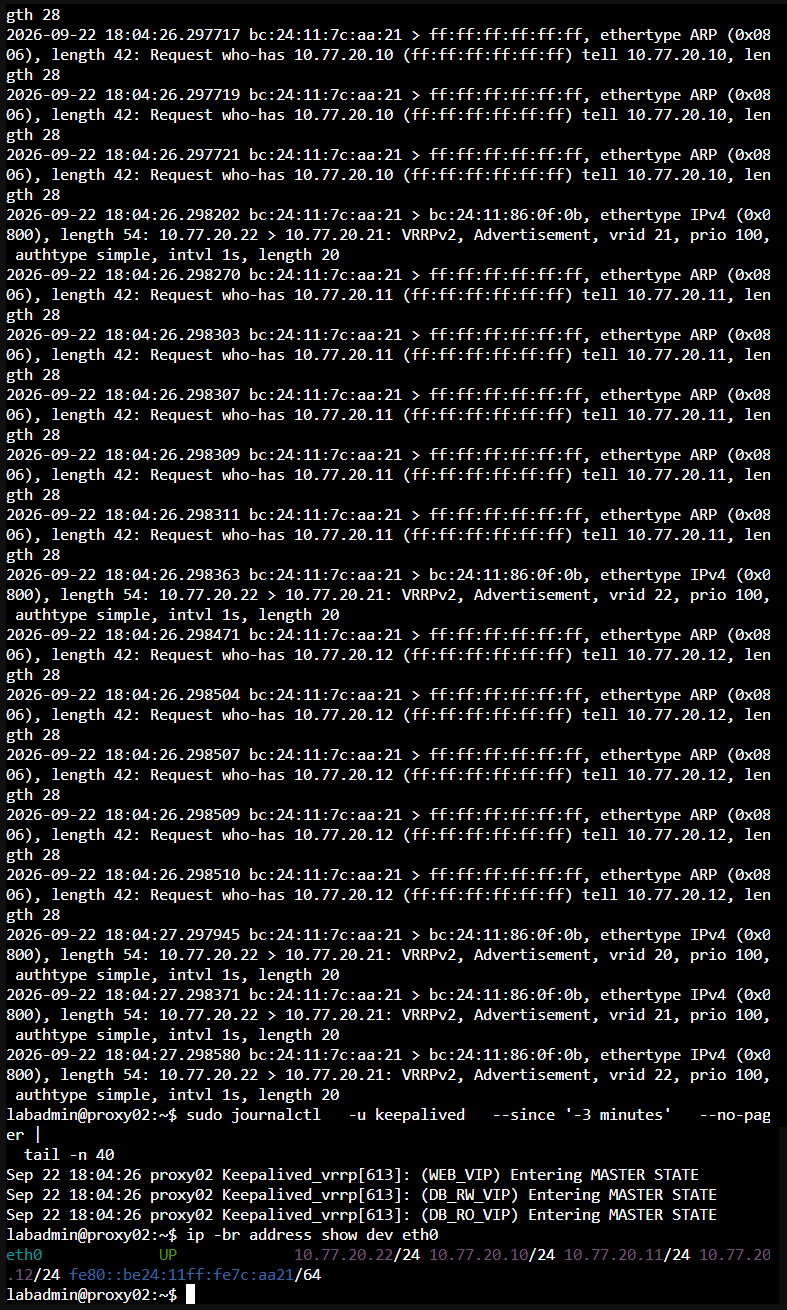
圖(八之二)proxy02 成為三組 VRRP Instance 的 MASTER,送出三組 VIP 的 GARP 並取得位址
兩張圖顯示的是 18:04:25 至 18:04:27 的同一份封包與日誌紀錄。
這組證據說明 VIP 接管同時涉及控制面的 VRRP 選舉與資料路徑所需的鄰居更新,並可與圖(四)、圖(六)的流程互相核對。
先從 client01 持續測試三個入口,再停止 proxy01 的 Nginx。預期 Web VIP 移到 proxy02 並恢復服務,兩組 DB VIP 留在 proxy01,DB 探測持續成功。Web 探測是否捕捉到失敗,取決於切換耗時與採樣時機,應照實保留結果。
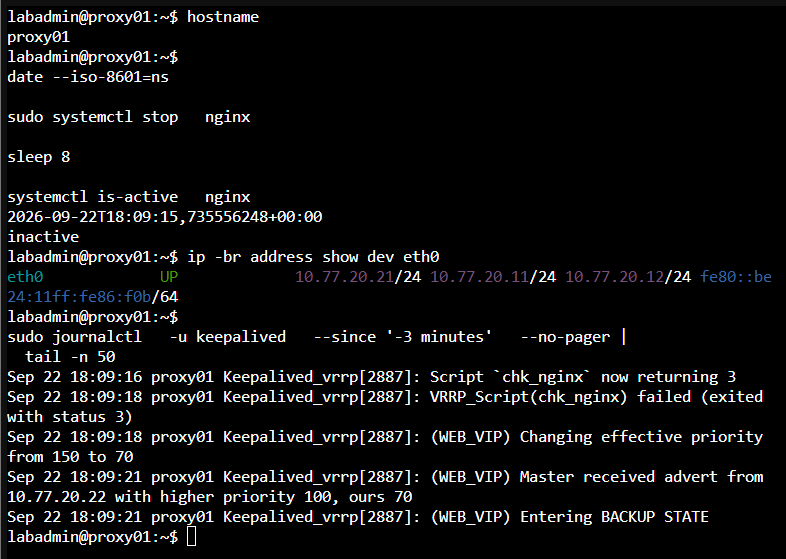
圖(九之一)proxy01 的 Nginx 健康檢查失敗後降低 Web VRRP Instance 的有效優先權,兩組 DB VIP 留在原節點
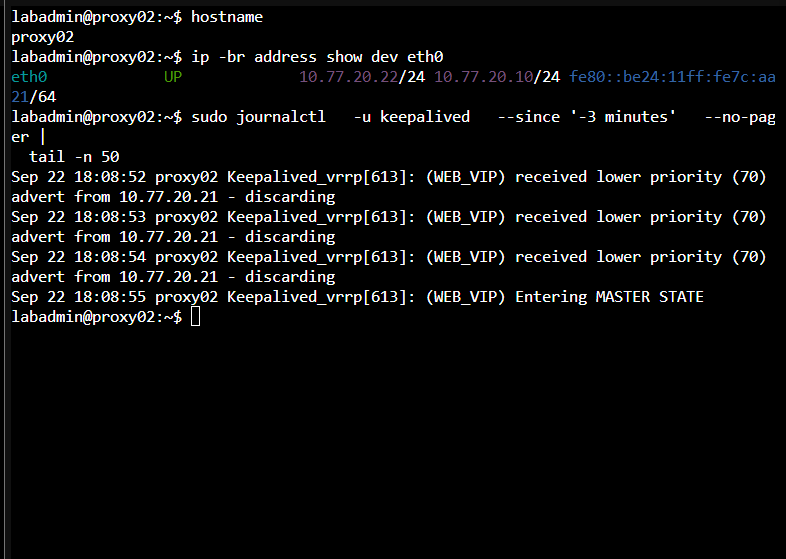
圖(九之二)proxy02 接管 Web VIP,沒有接管 DB-RW 與 DB-RO VIP
這項結果驗證 chk_nginx 只影響 Web VRRP Instance。最初一秒一次的探測沒有捕捉到 Web 請求失敗,說明採樣間隔可能漏掉短暫狀態。改用 0.2 秒探測後,則觀察到完整的失敗與恢復區間。
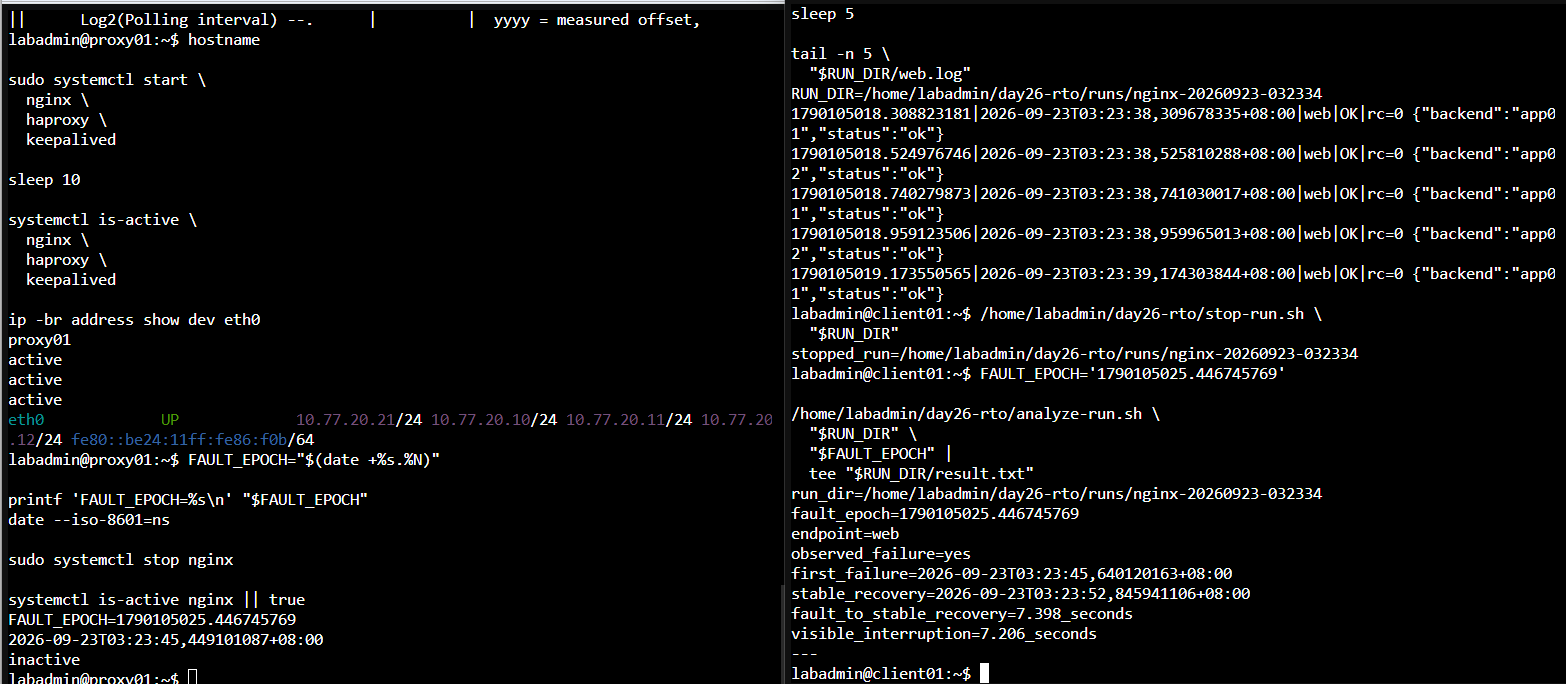
圖(九之三)停止 proxy01 的 Nginx 後,Web 入口在 7.398 秒內穩定恢復,其中用戶端可見中斷為 7.206 秒
恢復 Nginx 並等待 Web VIP 回到正常基準後,再停止 proxy01 的 HAProxy。預期 DB-RW 與 DB-RO VIP 都移到 proxy02,Web VIP 留在 proxy01。
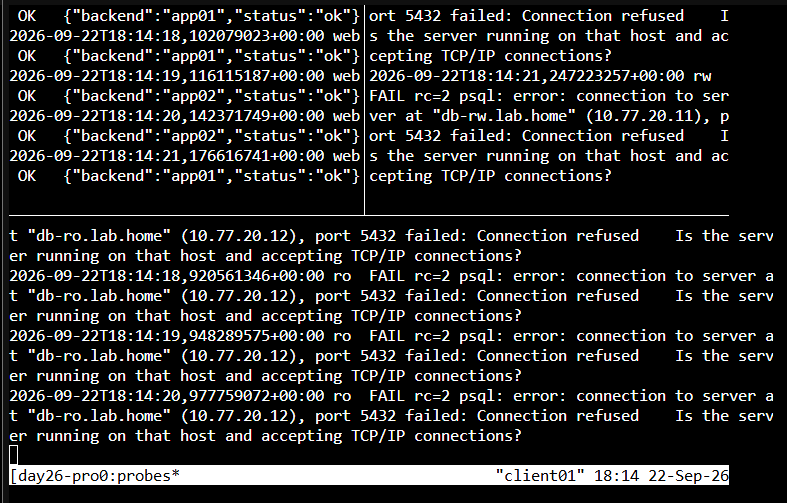
圖(十之一)HAProxy 停止後,DB-RW 與 DB-RO 探測暫時失敗,Web 入口持續成功
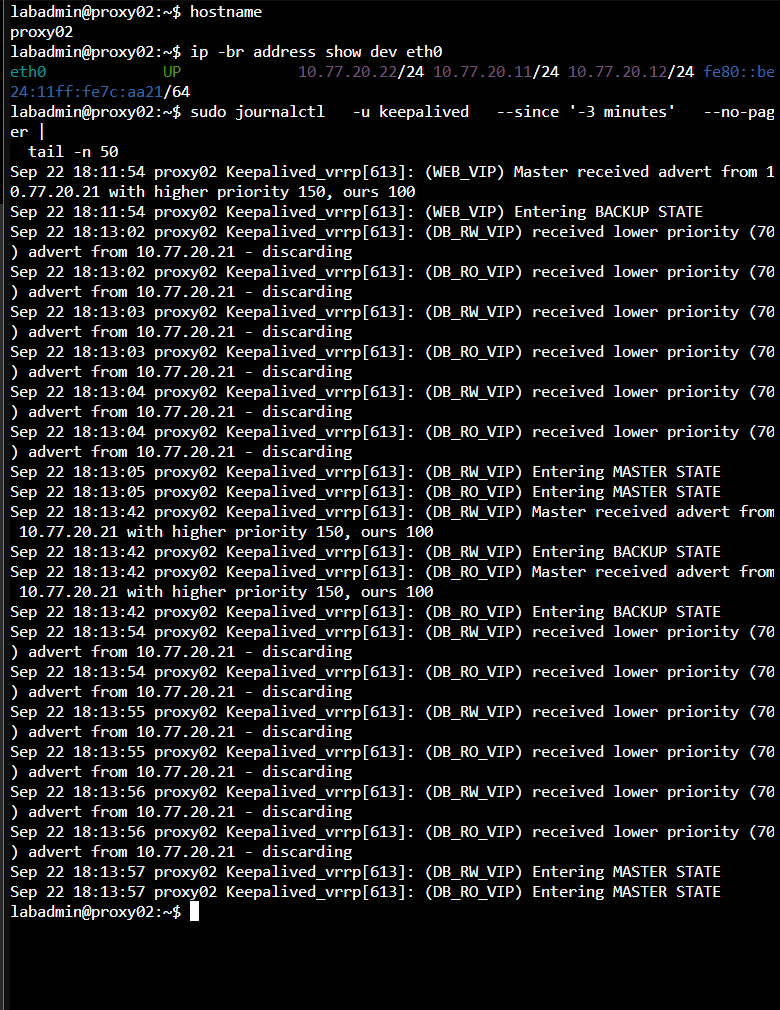
圖(十之二)proxy02 接管 DB-RW 與 DB-RO VIP,沒有接管 Web VIP
這項結果驗證兩組 DB VRRP Instance 都追蹤相同的 chk_haproxy。RW 查詢回到 Primary,RO 查詢回到 Replica,確認入口恢復後維持正確資料庫角色。0.2 秒補測進一步保存兩組入口的第一次失敗與連續三次成功時間。
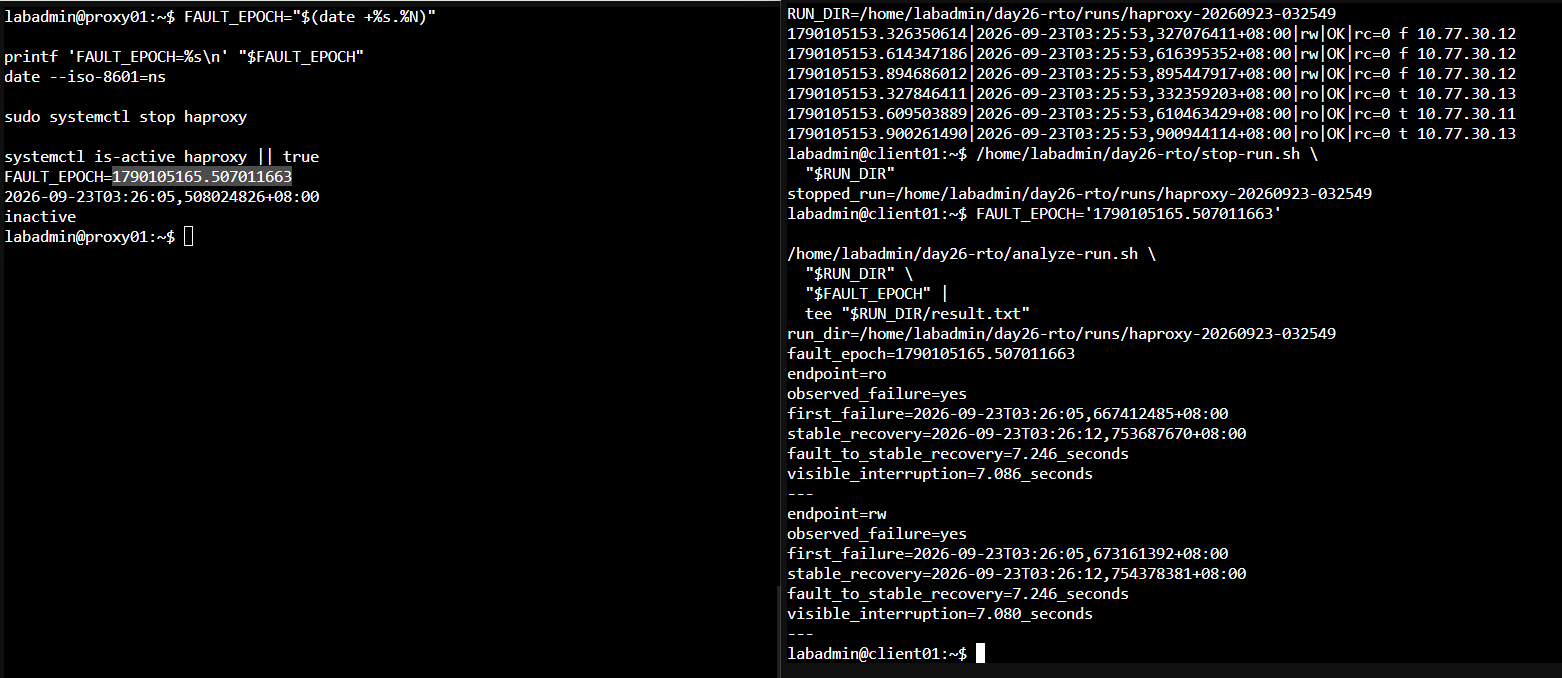
圖(十之三)停止 proxy01 的 HAProxy 後,DB-RW 與 DB-RO 都在 7.246 秒內穩定恢復,可見中斷分別為 7.080 與 7.086 秒
恢復 HAProxy 並等待三組 VIP 回到正常基準,確認 proxy02 健康後,依手冊使用 PVE 的 Shutdown 正常關閉 proxy01 VM。proxy02 應接管全部 VIP,三種用戶端探測應能成功。正常關機可能先完成 VRRP 交接。這次結果代表關機接管,突然斷電的恢復時間需另外測試。
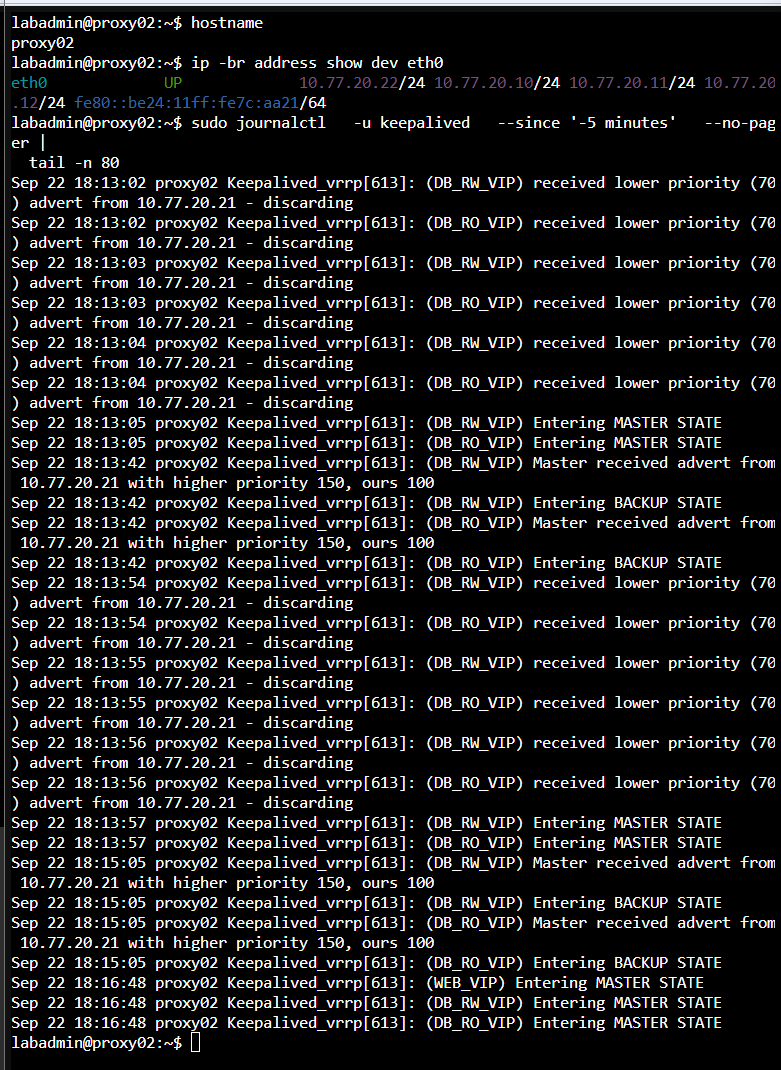
圖(十一之一)proxy02 在 proxy01 關機後成為三組 VRRP Instance 的 MASTER 並持有全部 VIP
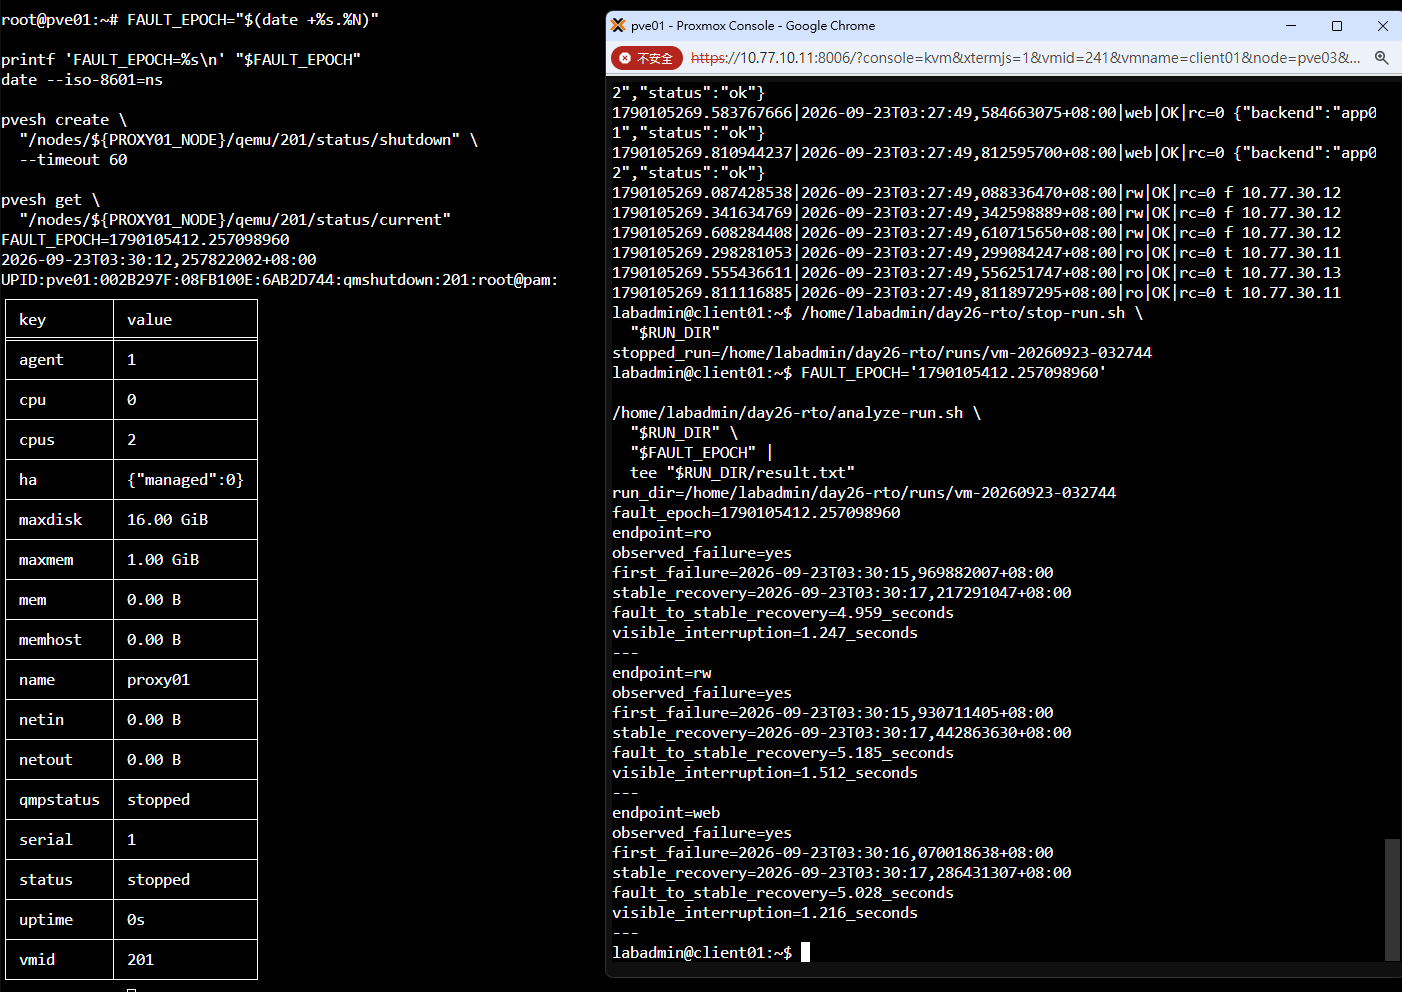
圖(十一之二)PVE 正常關閉 proxy01 後,三組入口約在故障注入後 5 秒內穩定恢復,用戶端可見中斷介於 1.216 至 1.512 秒
重新啟動 proxy01 後,還要等待三個服務通過健康檢查,觀察預設搶占是否讓 VIP 回到較高優先權節點,並記錄回切造成的第二次連線波動。
三組 DNS 記錄應解析到各自 VIP。使用 sslmode=verify-full 連向兩組資料庫名稱時,DB-RW 應抵達 Primary,DB-RO 應抵達 Replica。應用程式改用 db-rw.lab.home 後,兩台 Web 後端都應能完成 /write。
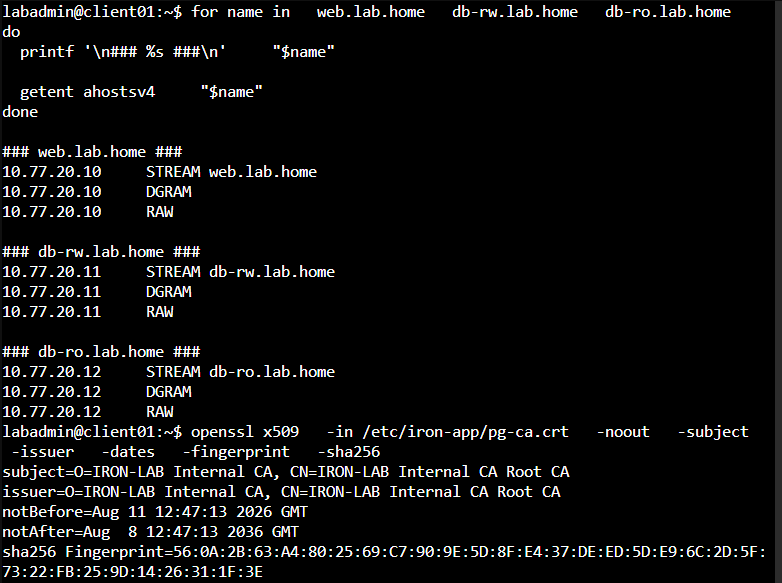
圖(十二之一)三個服務名稱分別解析到 Web、DB-RW 與 DB-RO VIP,client01 使用內部 CA 根憑證建立信任
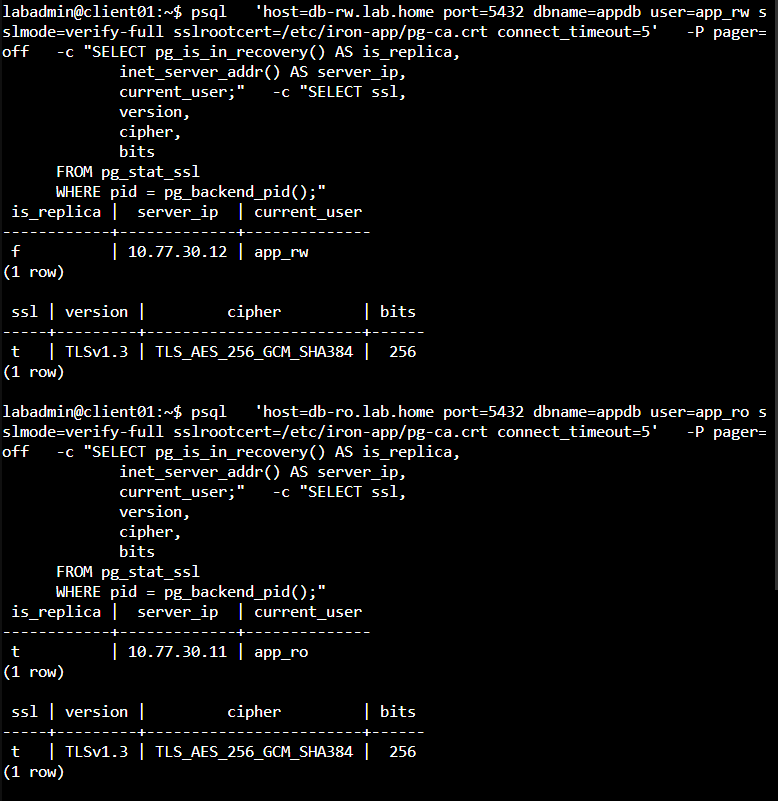
圖(十二之二)sslmode=verify-full 連線確認 DB-RW 抵達 Primary、DB-RO 抵達 Replica,兩條連線皆使用 TLS 1.3
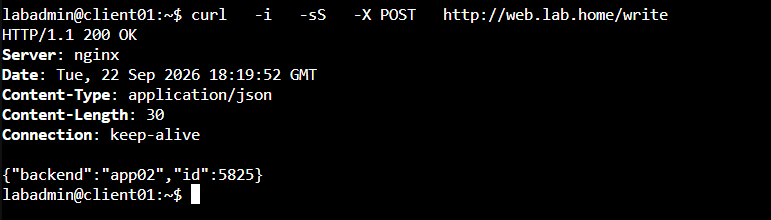
圖(十二之三)透過 Web VIP 執行寫入請求並取得 HTTP 200 與新增資料編號
這項結果驗證用戶端沿用固定名稱即可取得正確服務,並同時保留憑證名稱驗證與資料庫角色分流。
VPN RW 使用者的允許範圍是 DB-RW VIP,VPN RO 使用者的允許範圍是 DB-RO VIP。兩種使用者連向另一組資料庫 VIP,以及直接連線 PostgreSQL 節點都應失敗。判定為防火牆拒絕時,須同時取得阻擋日誌。VPN 未下發資料庫網段路由,也可能造成直連失敗。入口規則控制網路可達性,SQL 權限由資料庫角色決定。
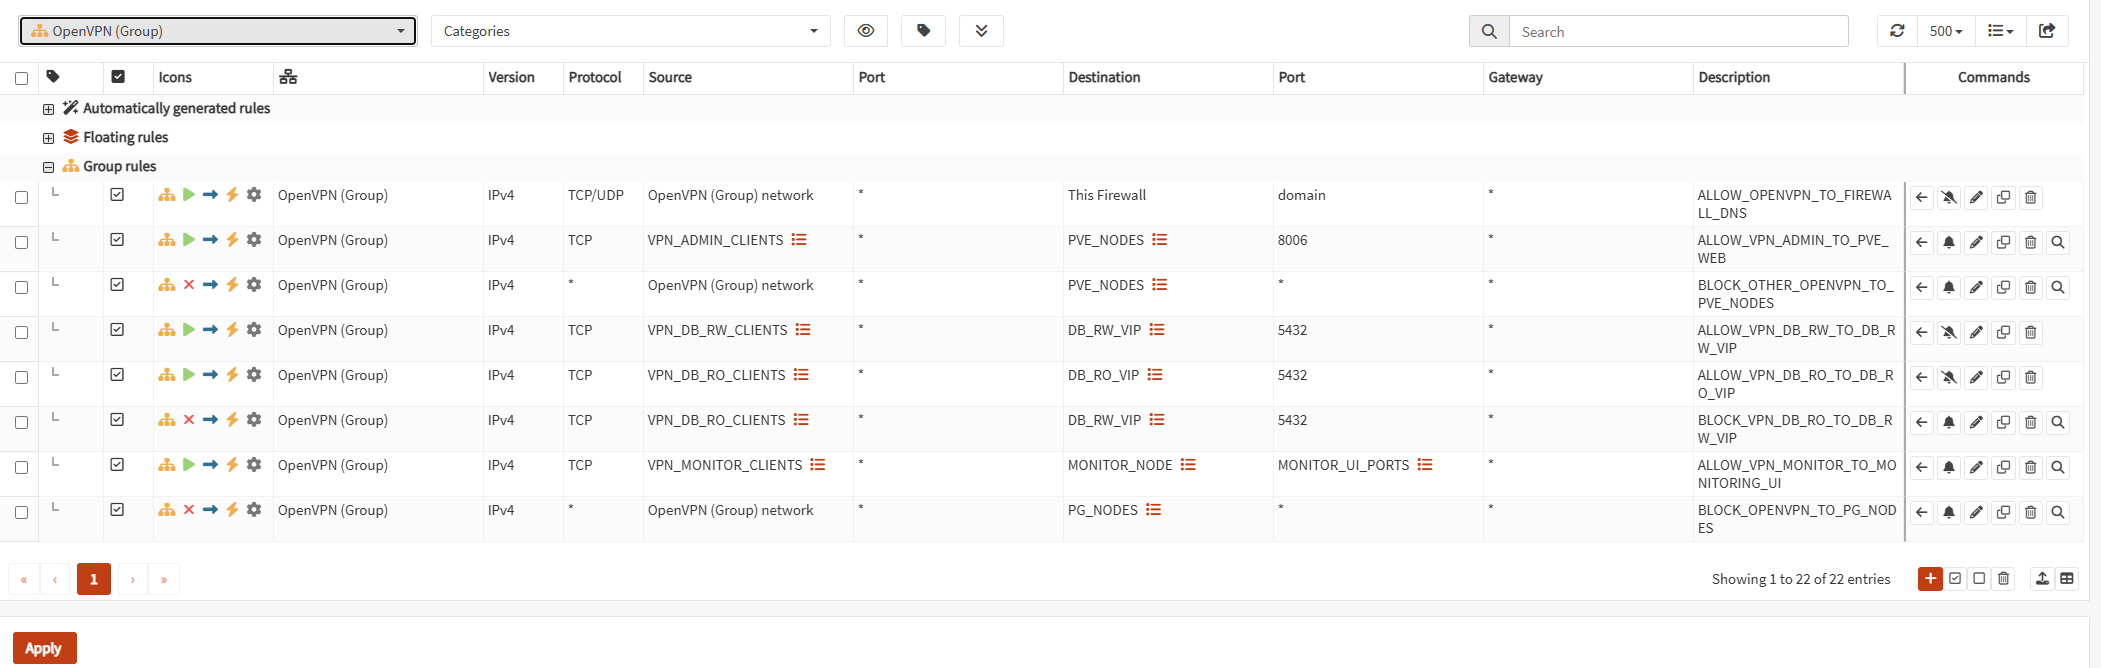
圖(十三之一)OPNsense 依 VPN 使用者群組允許 DB-RW 或 DB-RO VIP,並阻擋 OpenVPN 直接連線 PostgreSQL 節點
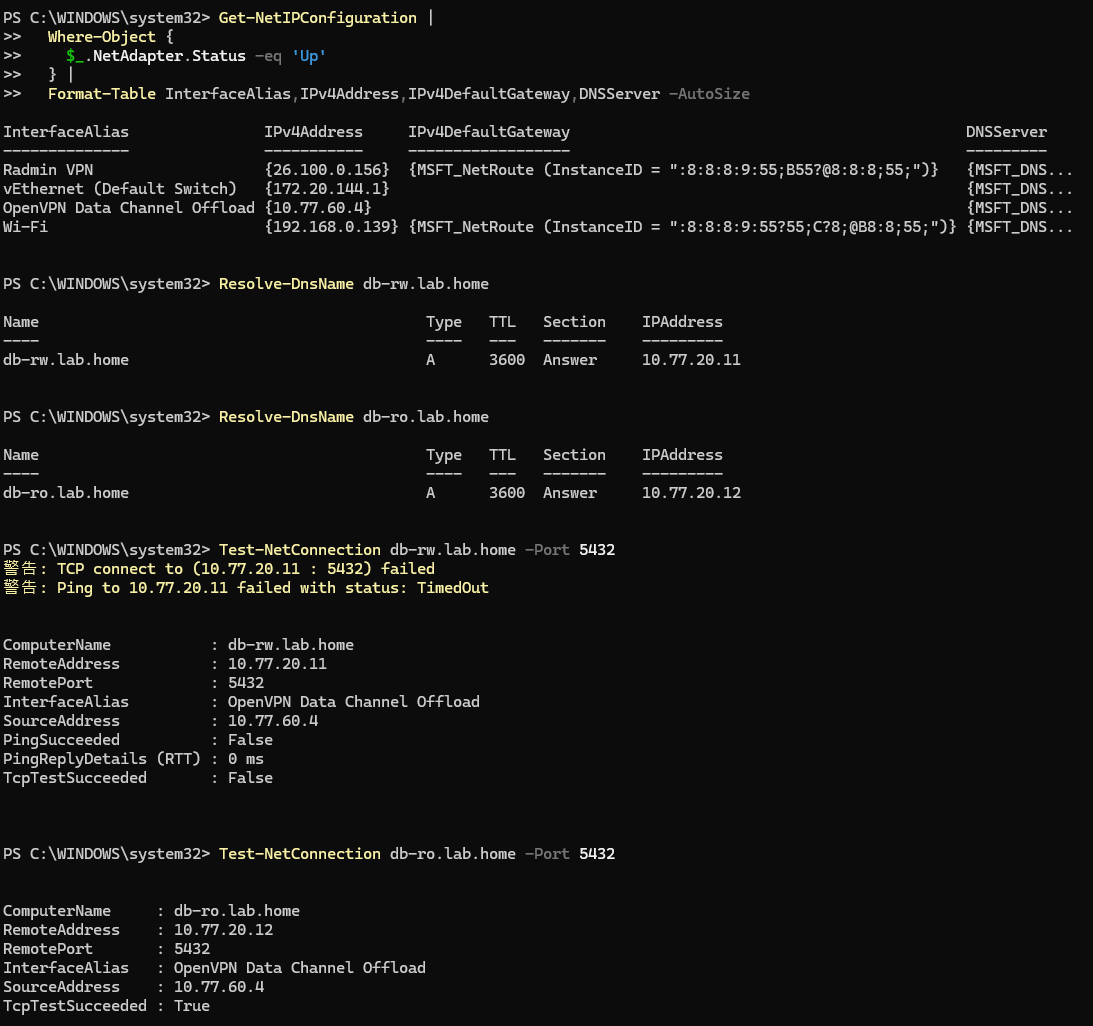
圖(十三之二)VPN RO 使用者以 10.77.60.4 連線時,DB-RO VIP 成功、DB-RW VIP 失敗
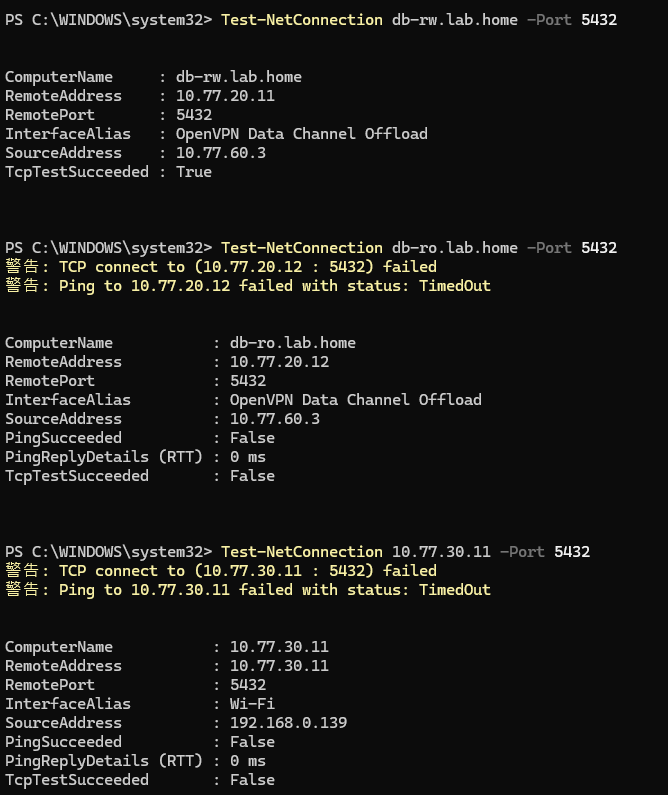
圖(十三之三)VPN RW 使用者以 10.77.60.3 連線時,DB-RW VIP 成功、DB-RO VIP 失敗。直接節點測試實際經由 Wi-Fi,因此只呈現路由結果
前兩組連線結果驗證 VPN 權限已對準固定服務入口。圖(十三之三)的直接節點測試使用 Wi-Fi 來源 192.168.0.139,只能證明 Windows 沒有把該目的位址送進 VPN,無法單獨證明 OPNsense 的 BLOCK_OPENVPN_TO_PG_NODES 已命中。若要驗證該規則,還要補上 OpenVPN 來源的阻擋日誌。
完成操作後,將結果整理成同一張表:
| 測試情境 | 入口 | 第一次失敗 | 第一次穩定成功 | 故障到穩定恢復 | 可見中斷 | 結果 |
|---|---|---|---|---|---|---|
| proxy01 Nginx 停止 | Web | 03:23:45.640 | 03:23:52.846 | 7.398 秒 | 7.206 秒 | 只有 Web VIP 接管,符合預期 |
| proxy01 HAProxy 停止 | DB-RO | 03:26:05.667 | 03:26:12.754 | 7.246 秒 | 7.086 秒 | 兩組 DB VIP 一起接管,符合預期 |
| proxy01 HAProxy 停止 | DB-RW | 03:26:05.673 | 03:26:12.754 | 7.246 秒 | 7.080 秒 | RW 恢復後抵達 Primary,符合預期 |
| proxy01 VM 正常關閉 | DB-RO | 03:30:15.970 | 03:30:17.217 | 4.959 秒 | 1.247 秒 | proxy02 接管,符合預期 |
| proxy01 VM 正常關閉 | DB-RW | 03:30:15.931 | 03:30:17.443 | 5.185 秒 | 1.512 秒 | proxy02 接管,符合預期 |
| proxy01 VM 正常關閉 | Web | 03:30:16.070 | 03:30:17.286 | 5.028 秒 | 1.216 秒 | proxy02 接管,符合預期 |
故障注入發生在 proxy01 或 PVE,穩定恢復時間由 client01 記錄,因此「故障到穩定恢復」以測試前各端已完成時間同步為前提。「可見中斷」的起點與終點都取自 client01 的同一份探測紀錄,不受跨主機時鐘偏差影響。
服務停止測試的故障注入幾乎立刻造成失敗,因此兩種時間很接近。VM 正常關機時,停止命令送出後會有一段可服務時間,所以故障到穩定恢復約為 5 秒,而真正由用戶端觀察到的中斷約為 1.2 至 1.5 秒。這組結果描述正常關機交接。突然斷電的數值會由 VRRP 逾時、健康檢查與網路收斂共同決定。
若結果和預期不同,保留錯誤訊息、時間、兩台 VIP 分布、Keepalived Log 與封包擷取結果,再依下列順序定位:
auth_type PASS 的密碼會以明文傳送,主要用來避免誤配置,無法取代網路存取控制。nopreempt。維護期間應控制回切時間,避免短時間內連續兩次中斷。今天把兩台代理節點從兩個獨立位址組成三個固定服務入口:
下一篇是 Day 27|將私有雲服務安全發布至網際網路:Cloudflare DNS、CDN、WAF 與 Full (strict)。內部 Web VIP 已經提供固定入口,接下來會讓公開網域透過 Cloudflare 抵達這個入口,並保護訪客到 Cloudflare、Cloudflare 到 Origin 的兩段連線。


 iThome鐵人賽
 看影片追技術