

前面已經讓 PostgreSQL 可以在節點故障時切換,也替 Web 與資料庫建立了高可用入口。不過,高可用性會忠實保留服務的最新狀態:若使用者誤刪資料、程式寫入錯誤內容,變更同樣會經由 WAL 傳到所有 Replica。今天改從資料復原的角度出發,建立獨立的 pgBackRest 備份儲存庫(Repository)、持續保存 WAL,並把誤刪前的資料還原到隔離主機。
今天會依序回答以下問題:
本文先從事故與備份類型開始,再拆解 WAL Archive、pgBackRest 與 PITR,最後才進入 Lab。
本文閱讀方式
- 完整理解備份與復原原理:依序閱讀全文。
- 掌握完成部署所需的基本概念:優先閱讀標有「⭐」的章節。
- 快速了解當天的部署內容:閱讀文末的 Lab/實作章節。
- 跟著系列建立完整系統:依照 GitHub 詳細部署文件 的天數順序操作。
PostgreSQL 串流複寫的目標是讓 Replica 持續接近 Primary,準備在節點故障時接手服務。DELETE、DROP TABLE 與錯誤的應用程式交易都是合法變更,也會被寫入 WAL 並套用到 Replica。Replica 因此能接手最新狀態,卻無法單獨提供事故前的歷史版本。
Ceph 副本與儲存快照也有各自的責任。Ceph 副本主要處理儲存裝置或節點故障。快照快速保留某個儲存狀態,但一致性、保存位置、保留期限與還原方式需要另外設計。所有副本、快照與來源資料位於同一個故障域時,單一硬體事故可能同時影響它們。
PostgreSQL 常見的資料保護方式可以整理如下:
| 方法 | 保存內容 | 主要處理方式與事故 | 主要限制 |
|---|---|---|---|
| Replica | 持續套用中的最新資料 | 節點或 PostgreSQL 程序故障時,由 Patroni 將服務切到健康 Replica | 錯誤交易也會被複寫 |
| 儲存快照 | 某一時間點的區塊狀態 | 快速回復整個磁碟或 VM | 需要另外確認資料庫一致性與故障域 |
pg_dump/pg_dumpall |
邏輯物件、結構與資料列 | 選擇性還原、資料移轉與跨大版本 | 不提供連續 WAL 重播所需的實體起點 |
| 實體基礎備份 | 整套 PostgreSQL Cluster 的資料檔案 | 整體還原、建立 Replica 與 PITR | 通常綁定 PostgreSQL 大版本與平台條件 |
| 基礎備份+WAL Archive | 實體起點與之後的連續變更 | 發生錯誤 DELETE/DROP TABLE 時,先隔離還原基礎備份,再重播 WAL 到事故前 |
必須維持完整備份鏈並實際測試還原 |
| 異地或不可變備份副本 | Repository 中的備份集合與 Archived WAL | 來源站點或主要 Repository 故障時,從另一個故障域重建 | 需要獨立儲存、權限與定期還原演練 |
這些方法可以並用。Replica 維持服務連續性,邏輯備份方便抽取單一資料庫或資料表,實體備份與 WAL Archive 則負責重建整個 PostgreSQL Cluster 的歷史狀態。另一個故障域中的副本再承接站點與 Repository 故障。今天使用基礎備份與 WAL Archive,處理誤刪後回到指定時間點的需求。
圖(一)pgBackRest 將 PostgreSQL 的備份、WAL 封存、保留與還原整理成一套可重複操作的流程。
pgBackRest 是 PostgreSQL 的備份與還原工具。它以 PostgreSQL 提供的實體備份與 WAL Archive 機制為基礎,加入備份鏈管理、完整性檢查、保留政策、平行處理與還原功能。
Repository 是 pgBackRest 管理的復原資料保存位置,裡面包含備份集合、Archived WAL、備份清單(Manifest)與相關中繼資料。建立備份時,pgBackRest 將目前 Primary 的資料寫入 Repository。執行還原時,再從 Repository 取回基礎備份與所需 WAL。PostgreSQL 資料目錄負責目前的線上服務,Repository 則保存可供復原的歷史資料。
本次將 Repository 建立在獨立的 backup01,實際路徑為 /var/lib/pgbackrest/repo。後面的 Lab 會讓 PostgreSQL 節點持續封存 WAL,再由隔離的 pg-restore01 從這個 Repository 完成指定時間點還原。
時間點復原(Point-in-Time Recovery,PITR)是一種把資料庫恢復到指定時間點的方法,例如停在誤刪或錯誤寫入發生之前。它的復原範圍由可用的基礎備份、連續 WAL 與復原目標共同決定。
Day 21 已說明 WAL 會先記錄資料頁需要發生的變更,再由 PostgreSQL 將這些變更寫入主要資料檔案。PITR 先還原一份基礎備份,再依序重播該備份之後封存的 WAL。基礎備份提供一致的起點,WAL 補上後續變更。PostgreSQL 抵達復原目標後停止,就能得到該時間點一致的資料庫狀態。
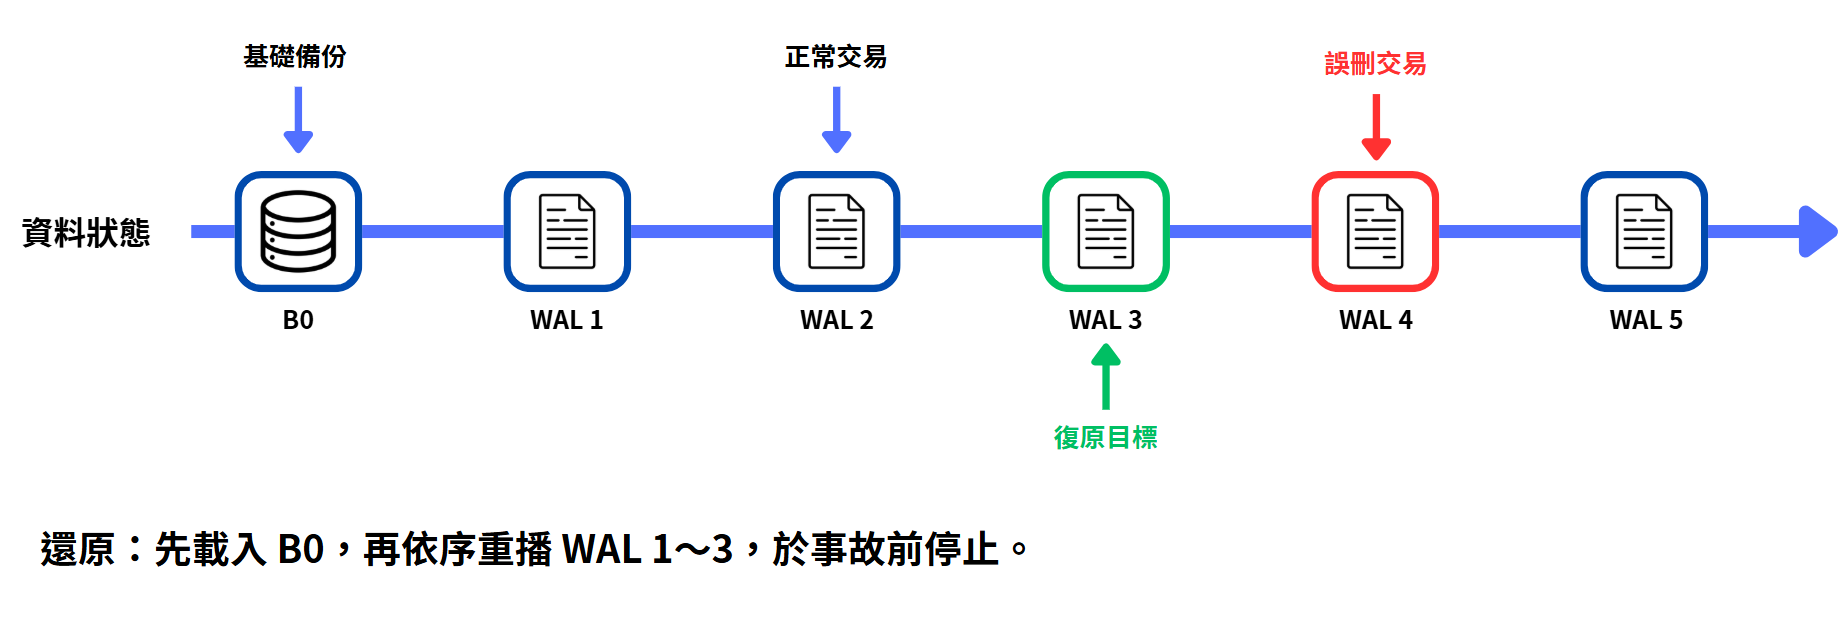
圖(二)PITR 從基礎備份開始重播連續 WAL,並在誤刪交易前停止。
這條還原路徑有三個必要條件:
缺少中間任一必要的 WAL 區段,重播就無法跨過該位置。保留一份最新完整備份,也要同時保留它完成一致性與繼續向後重播所需的 WAL。
WAL 保存的是資料庫資料檔案的變更,不會替管理者封存手動修改的 postgresql.conf、pg_hba.conf、Patroni 設定、憑證與 pgBackRest 設定。這些檔案要納入另外的組態備份,復原時才能重建相同的連線、驗證與服務參數。
PostgreSQL 預設會把 WAL 分割成固定大小的區段,一般為 16 MiB。啟用 archive_mode 後,PostgreSQL 會在 WAL 區段完成時呼叫 archive_command。命令回傳成功才代表該檔案已安全封存,失敗時則保留在 pg_wal 並持續重試。
本次由 pgBackRest 執行 Archive Push:
archive_mode = on
archive_command = 'pgbackrest --stanza=iron-pg archive-push %p'
archive_timeout = 60s
restore_command = 'pgbackrest --stanza=iron-pg archive-get %f %p'
%p 是 PostgreSQL 要封存的 WAL 完整相對路徑。%f 是復原時要求取得的 WAL 檔名。archive_timeout 讓低寫入量的系統定期切換 WAL 區段,縮短已提交交易尚未進入 Repository 的等待時間。較短的 archive_timeout 會更頻繁切換並封存尚未填滿的 WAL 區段,增加封存檔案數量與處理開銷,因此要在復原需求與 Repository 資源之間取捨。pg_switch_wal() 則可在備份或復原演練時主動完成目前區段,讓最新 WAL 儘快進入封存流程。
Archive Push 長期失敗時,尚未封存的 WAL 區段會持續累積在 pg_wal。檔案系統填滿後,PostgreSQL 可能停止服務。因此 pg_stat_archiver、最後成功封存時間、失敗次數、WAL 堆積量與磁碟容量都屬於需要持續監控的重要訊號。
交易完成 COMMIT 時,WAL 已依 PostgreSQL 的同步設定寫入 Primary,並可能送達同步 Replica。目前 WAL 區段完成且 Archive Push 成功後,才會成為 Repository 可用的復原資料。備份端目前能證明的復原邊界,應以最後一段連續成功封存的 WAL 為準。
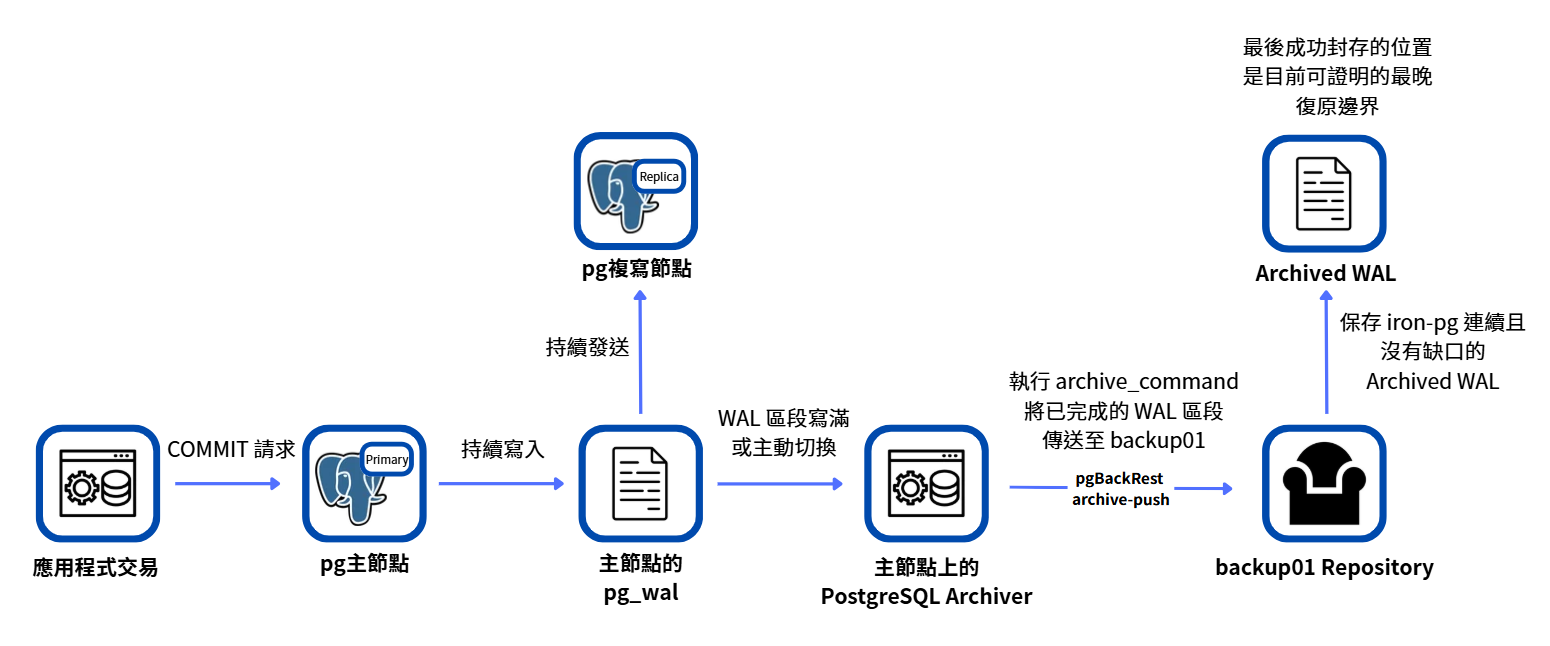
圖(三)交易提交、串流複寫與 WAL Archive 使用不同完成條件,Repository 的復原邊界可能落後最新交易。
archive_timeout=60s 能縮短低寫入量時等待 WAL 區段切換的時間,實際空窗還會受到 Archive Push、網路與 Repository 狀態影響。RPO 應以事故時最後可還原資料與來源資料的差距量測,archive_timeout 只是其中一項影響因素。
Stanza 是 pgBackRest 對一套 PostgreSQL Cluster 的設定名稱,記錄資料目錄、Repository 與備份行為。Patroni 的三個 Member 共同組成 iron-pg,因此使用同一個 Stanza,而非替 pg01、pg02、pg03 各建立一套互不相干的備份名稱。
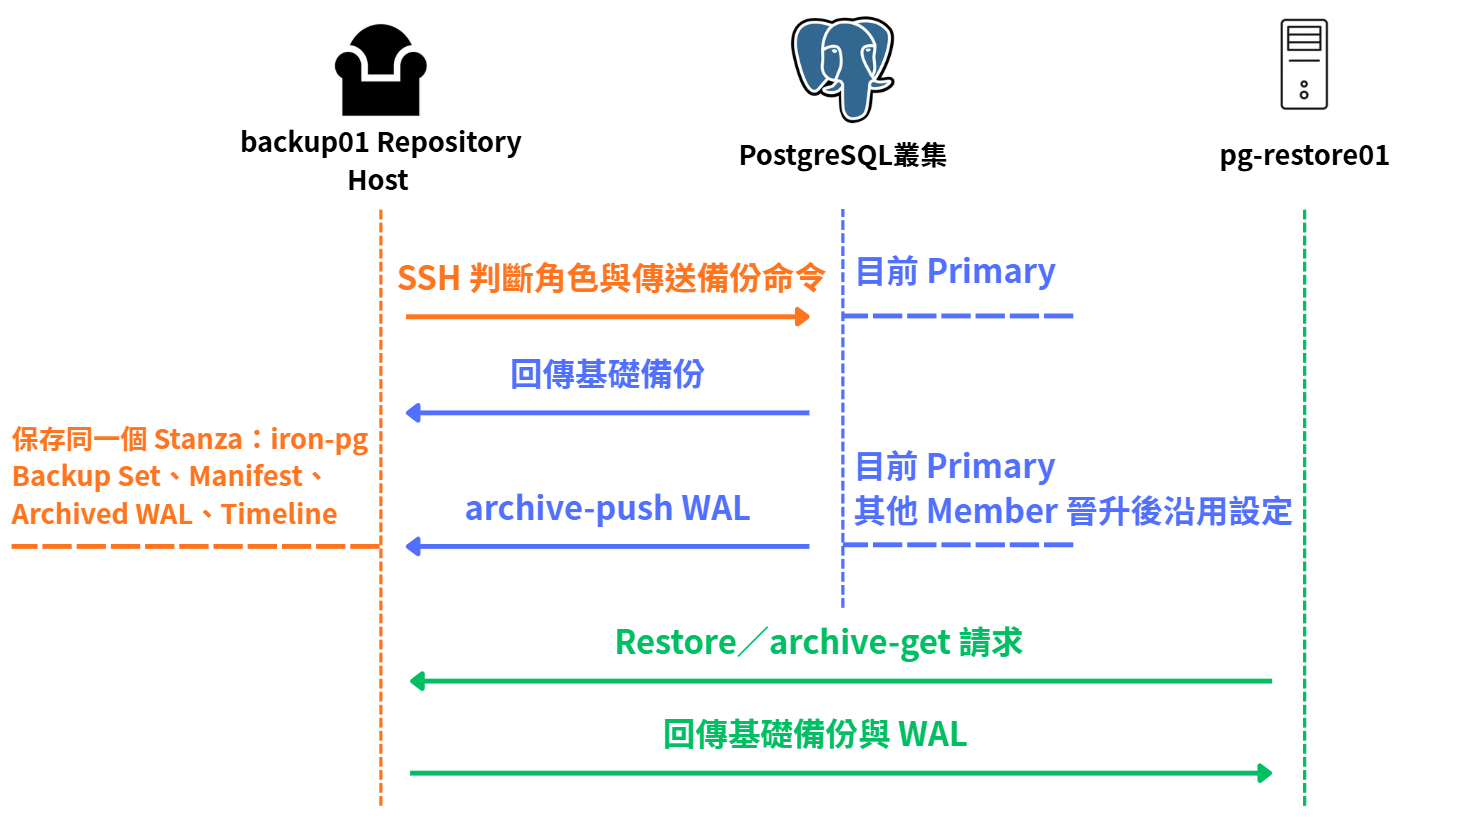
圖(四)backup01 透過 SSH 從目前 Primary 建立基礎備份。目前 Primary 以 archive-push 封存 WAL。pg-restore01 再向 Repository 請求基礎備份與 WAL,完成隔離還原。
本次 Repository 設定的核心部分如下:
[iron-pg]
pg1-host=pg01.lab.home
pg1-host-user=postgres
pg1-path=/var/lib/postgresql/18/patroni
pg2-host=pg02.lab.home
pg2-host-user=postgres
pg2-path=/var/lib/postgresql/18/patroni
pg3-host=pg03.lab.home
pg3-host-user=postgres
pg3-path=/var/lib/postgresql/18/patroni

[global]
repo1-path=/var/lib/pgbackrest/repo
repo1-retention-full=2
repo1-retention-diff=4
start-fast=y
process-max=2
start-fast=y 會要求 PostgreSQL 以立即 Checkpoint 開始備份,能縮短等待時間,也可能在開始時提高 I/O。正式排程要觀察備份窗口與工作負載後再決定。
pgBackRest 的三種備份會形成依賴關係:
| 類型 | 保存範圍 | 還原時需要的備份 |
|---|---|---|
| Full | 整套 Cluster | 該完整備份與必要 WAL |
| Differential | 相對最近 Full 後變更的檔案 | 該差異備份、所屬完整備份與必要 WAL |
| Incremental | 相對最近一次任何類型備份後變更的檔案 | 該增量備份回溯到完整備份的完整依賴鏈與必要 WAL |
較短的依賴鏈通常需要更多備份時間與容量,但還原路徑較單純。較長的增量備份鏈能節省日常傳輸與空間,還原時則要讀取更多備份集合。選擇要同時考慮資料變更率、備份窗口、Repository 容量與復原速度。
repo1-retention-full=2 代表以數量保留兩份完整備份。第三份完整備份成功後,最舊的一份才符合到期條件。當完整備份到期時,依賴它的差異與增量備份也會一併到期。repo1-retention-diff=4 的計數包含 Full,因此代表保留四個 Full/Differential 備份集合的計數範圍,並非額外保留四份 Differential。
pgBackRest 預設會配合 Full Retention 保存 Archived WAL。若另外採用更積極的 Archive Retention,設定只保證備份恢復到一致狀態所需的最低 WAL。較晚時間點能否復原,取決於對應的連續 WAL 是否還在。PITR 窗口因此要從可用 Base Backup 與連續 WAL 的交集判斷。
Repository 不應由管理者手動刪除看似過期的 WAL。讓 pgBackRest 依 Retention 執行 expire,先用 --dry-run 檢查預計移除的內容,再以 info 和定期 Restore Test 核對實際可用範圍。
PITR 可使用時間、LSN、交易 ID 或命名還原點(Restore Point)作為目標。時間最容易與事故紀錄對照,但要包含時區,並直接以 PostgreSQL 回傳的時間為準,減少管理端與資料庫主機時鐘或時區不同造成的誤判。
SELECT clock_timestamp();
若重要部署或批次作業有明確邊界,也可以先建立命名 Restore Point:
SELECT pg_create_restore_point('before_batch_20260923');
以時間、LSN 或交易 ID 為目標時,recovery_target_inclusive=on 預設會包含剛好位於目標位置的交易。設為 off 則停在該交易之前。recovery_target_action 再決定抵達目標後要暫停、提升為可寫入的 Primary,或關閉 PostgreSQL。本次選擇 pause,先以唯讀方式確認資料再停止隔離主機。
復原目標只決定 WAL 重播停止的位置。回到事故前,也會排除事故後完成的合法交易。資料庫管理者還要從原叢集、應用程式事件或其他紀錄辨認哪些合法資料需要補回,並避免把錯誤交易再次匯入。
備份命令成功表示工具完成指定工作。stanza-create、check 與 info 能確認 Repository、設定、備份集合與 WAL 範圍。PostgreSQL 能否啟動、復原目標是否正確,以及應用程式需要的資料是否存在,則要透過隔離還原確認。
還原演練應使用隔離的資料目錄或主機,並避免加入原 Patroni Scope、存取原 DCS 或接收應用程式流量。測試流程如下:
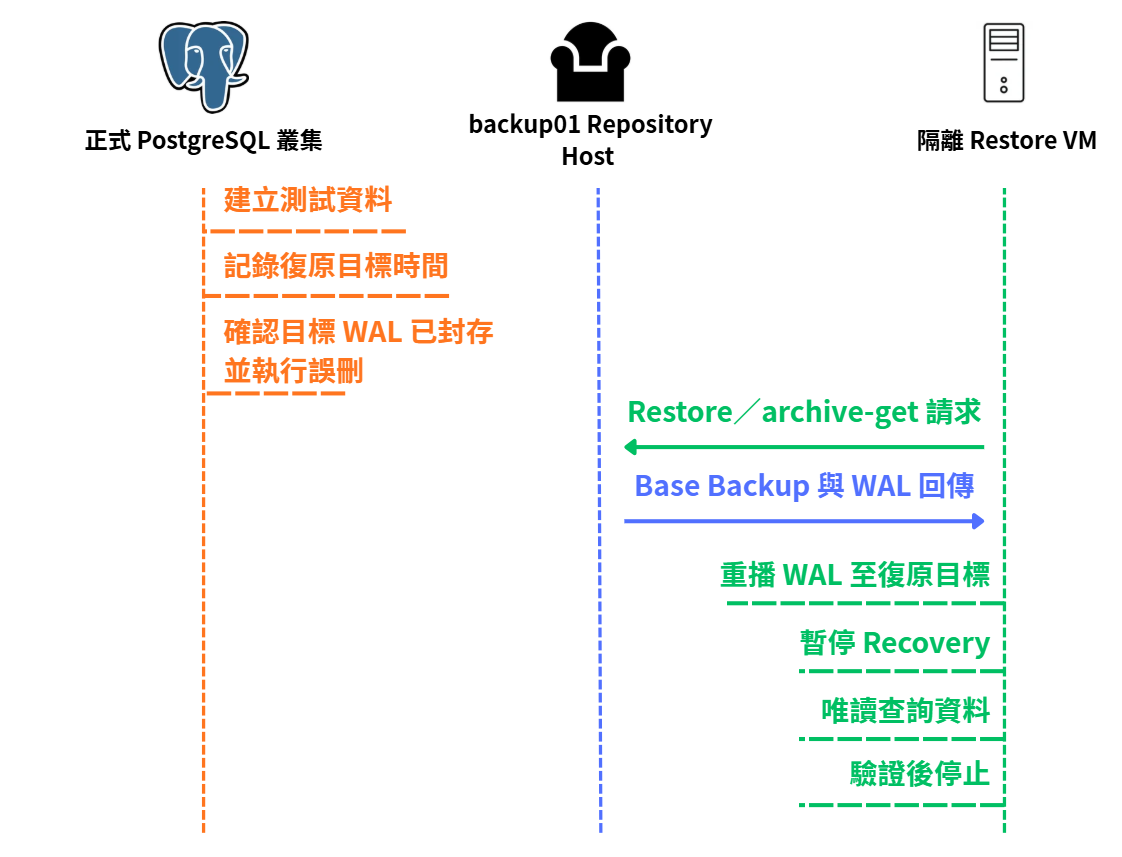
圖(五)隔離 Restore VM 使用相同備份鏈重建事故前狀態,不加入正式 HA Cluster。
本次使用 --target-action=pause,讓 PostgreSQL 抵達指定時間後暫停 Recovery。--archive-mode=off 與啟動時再次指定 archive_mode=off,則避免隔離主機把新的 WAL 寫回正式 Repository。驗證完成後直接停止,不在這台主機 Promote,也不將它接入正式流量。
還原驗證至少包含四層:
今天量到的是 Restore 流程的一部分耗時。完整 RTO 還包括事故判斷、取得資源、停止或隔離寫入、決定 Recovery Target、資料核准與重新開放流量。RPO 則要先訂出可接受的資料遺失目標,再以 Archived WAL 範圍和事故前後交易驗證。
先列出要處理的事故,再決定保存方法與演練方式:
| 事故 | 主要處理方式 | 要保留的證據 |
|---|---|---|
| Primary 程序或節點故障 | Patroni Failover | 切換結果與服務中斷時間 |
| 單一 Replica 損壞 | 從健康來源重建 Replica | 重建後角色與追趕狀態 |
錯誤 DELETE/DROP TABLE |
PITR 到事故前,再抽取或替換資料 | 復原目標與資料查詢結果 |
| 整套 Cluster 毀損 | 從 Repository 重建 Cluster | 完整還原演練與耗時 |
| 來源站點與 Repository 同時故障 | 異地或不可變備份副本 | 第二故障域的還原演練 |
| 備份遭惡意刪除或加密 | 權限隔離、離線或不可變副本 | 刪除權限測試與副本可讀性 |
備份排程也要納入資料量、WAL 產生率、網路頻寬與復原窗口。較頻繁的基礎備份能縮短需要重播的 WAL 範圍,持續 WAL Archive 則讓復原目標前進到兩次基礎備份之間。Repository 容量至少要容納保留政策所需備份、WAL、暫時並存的新舊備份,以及還原演練所需空間。
常見的 3-2-1 原則可以作為起點:保存多份副本、使用不同儲存位置或媒介,並讓至少一份位於另一個站點。面對勒索與憑證外洩,再加入不同管理權限、離線副本或物件鎖定。最後依風險與預算,把文件中的條件落實成可以定期驗證的備份流程。
Repository 保存完整資料庫內容,敏感度與正式資料相同。除了限制 SSH、檔案與刪除權限,也可使用 pgBackRest 的 Repository 加密。加密金鑰要與 Repository 分開保存並納入復原演練,避免備份存在卻失去解密能力。
本次 Lab 建立 backup01 作為 pgBackRest Repository Host,讓三台 PostgreSQL 節點共用 iron-pg Stanza 與相同的 Archive 設定。正常運作時由目前 Primary 封存 WAL,其他節點晉升後即可接續使用相同流程。接著建立完整備份、寫入一筆測試資料、記錄復原目標、執行誤刪,最後在 pg-restore01 還原並確認事故前資料可讀取。
GitHub 實作文件:Day 28|PostgreSQL 資料誤刪如何復原?使用 pgBackRest、WAL Archive 與 PITR 回到指定時間點
| 項目 | 本次設定 |
|---|---|
| Repository Host | backup01,10.77.40.11 |
| Repository 掛載點 | /var/lib/pgbackrest |
| Stanza | iron-pg |
| PostgreSQL 資料目錄 | /var/lib/postgresql/18/patroni |
| 保留政策 | 完整備份(Full)計數 2、差異備份(Differential)保留計數 4(計數包含 Full) |
| WAL Archive | archive_mode=on、archive_timeout=60s |
| Restore Host | pg-restore01,10.77.30.21 |
| Restore Port | Loopback 127.0.0.1:55432 |
| Recovery 行為 | 指定時間還原、抵達後 Pause、Archive 關閉 |
backup01 使用獨立的 32 GiB Repository 磁碟,pg-restore01 使用獨立的 16 GiB 還原磁碟。Repository 透過 SSH 讀取目前 Primary 以建立備份。目前 Primary 則以 postgres 帳號將 WAL 推送到 Repository,其他 Member 晉升後接續相同設定。兩個方向都只開放必要的 SSH 路徑。
先透過 Patroni Dynamic Configuration 寫入 archive_mode、archive_command、restore_command 與 archive_timeout。archive_mode 需要重新啟動 PostgreSQL 才會生效,因此採 Replica 先重啟、計畫性切換後再重啟舊 Primary 的順序,維持叢集服務。
驗證時要直接查詢三個 PostgreSQL Instance 的實際值,避免只看到 DCS 設定便判定已載入:
SELECT current_setting('archive_mode'),
       current_setting('archive_command'),
       current_setting('restore_command'),
       current_setting('archive_timeout');
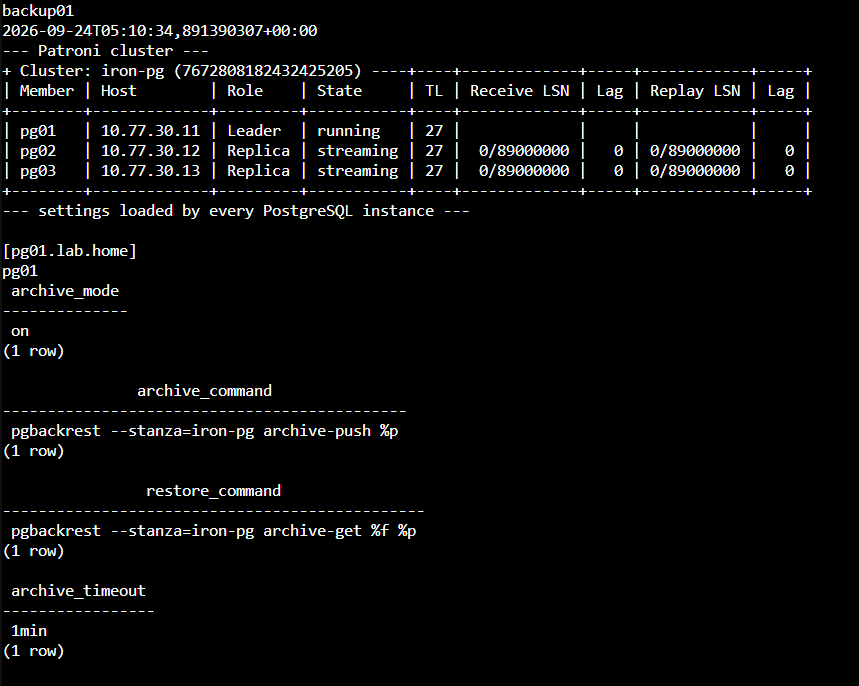
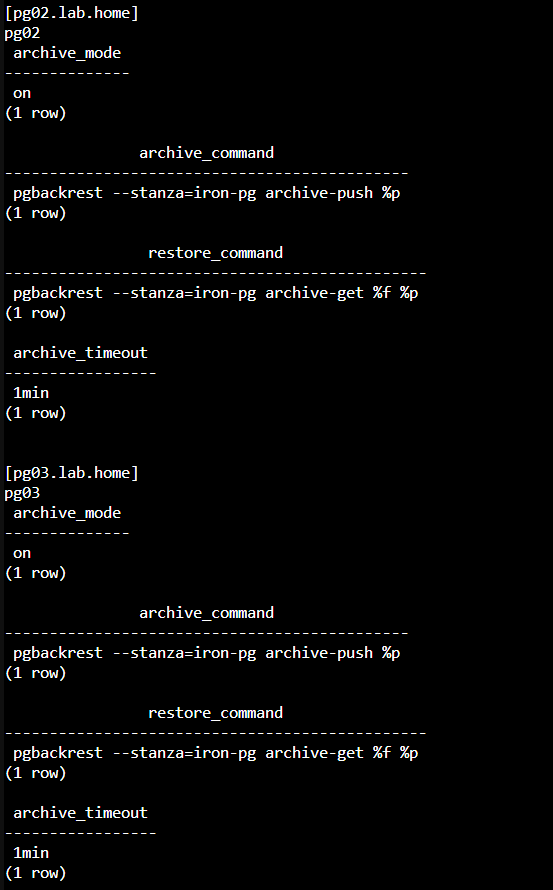
圖(六)三個 PostgreSQL 節點皆正常執行,並實際載入相同的 archive_mode、archive_command、restore_command 與 archive_timeout。
Repository Host 依序建立 Stanza、檢查路徑並建立完整備份:
sudo -u pgbackrest pgbackrest --stanza=iron-pg stanza-create
sudo -u pgbackrest pgbackrest --stanza=iron-pg check
sudo -u pgbackrest pgbackrest --stanza=iron-pg --type=full backup
sudo -u pgbackrest pgbackrest --stanza=iron-pg info
info 應顯示 Stanza 狀態、完整備份標籤、起訖時間及 WAL 起訖範圍。接著在目前 Primary 執行 pg_switch_wal(),再比較 pg_stat_archiver.last_archived_wal 與 Repository 中的 Archived WAL,確認目標 WAL 區段已送達。
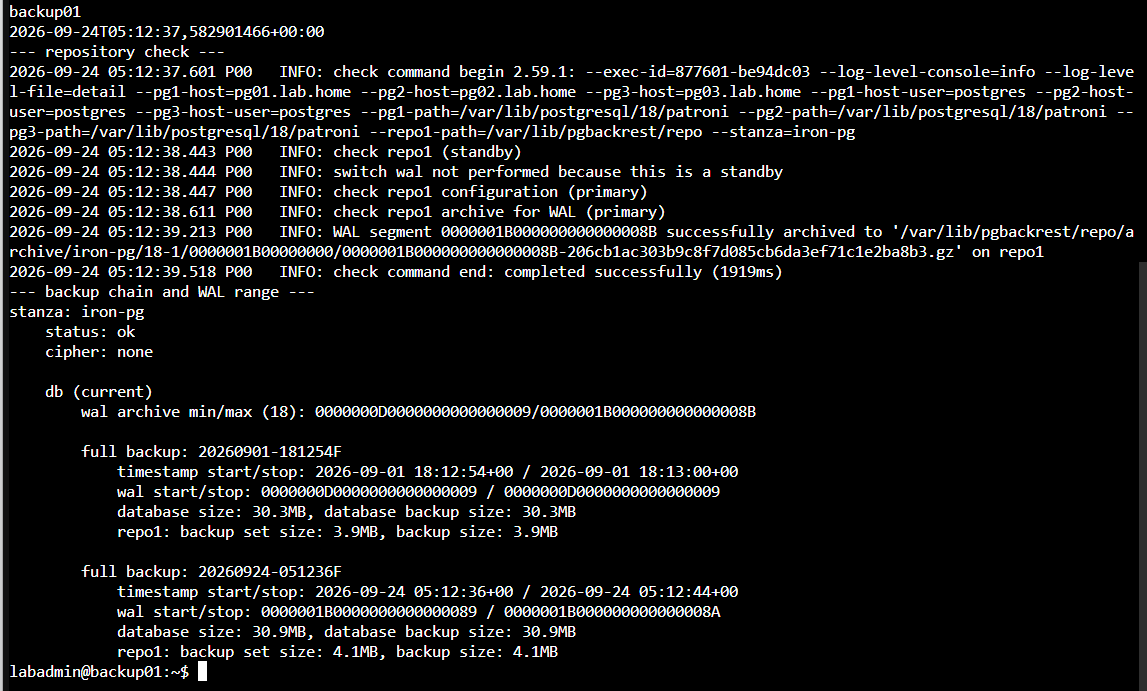
圖(七)Repository Check 成功,info 列出狀態正常的 iron-pg Stanza、完整備份與 WAL 範圍。
本次建立 app.pitr_demo,寫入唯一的 PROOF_ID 後直接由 PostgreSQL 記錄包含時區的復原目標時間,並保存當下 WAL 檔名。確認該 WAL 已進入 Repository 後,再刪除這筆測試資料。
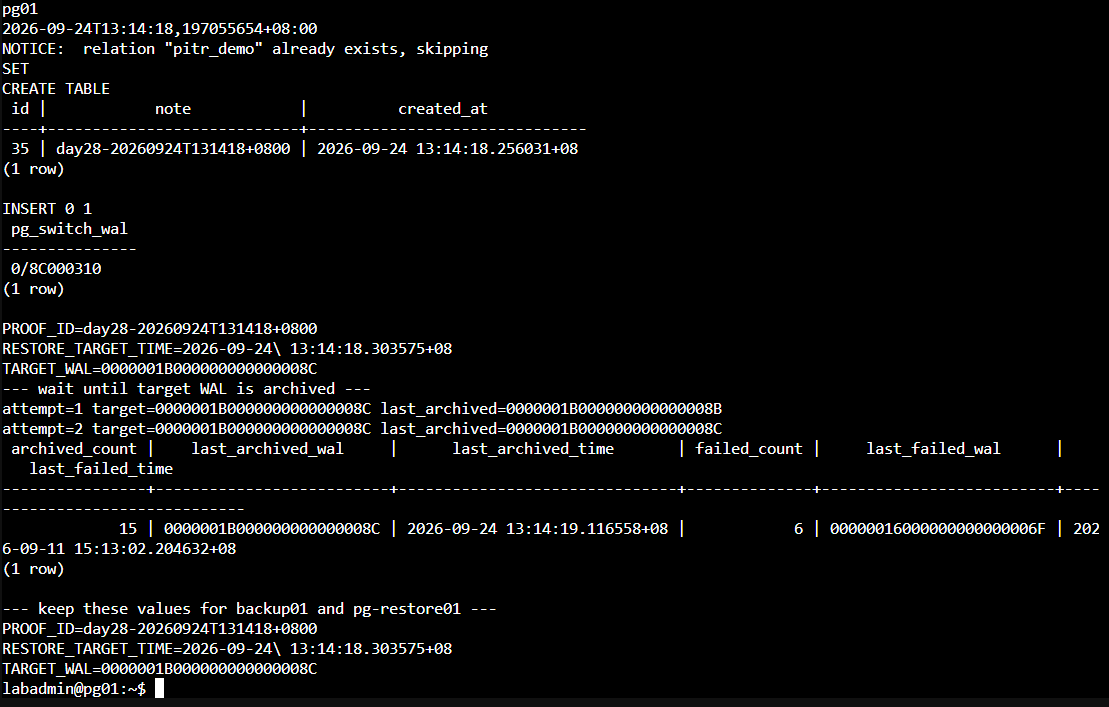
圖(八)測試資料、復原目標時間與目標 WAL 來自同一次操作。last_archived_wal 已到達目標 WAL。畫面中的 failed_count 是累計值,最後失敗時間早於本次測試,本次判讀以目標 WAL 已成功封存為準。
寫入唯一 PROOF_ID
  → 記錄復原目標時間與 WAL
  → 確認 WAL 已封存
  → DELETE 同一筆測試資料
  → pg-restore01 還原到復原目標時間
  → Recovery 暫停後查詢相同 PROOF_ID
pg-restore01 不執行 Patroni,也不加入正式 etcd Scope。還原命令的核心參數如下:
RESTORE_DIR="/var/lib/postgresql/18/day28-proof-$(date +%Y%m%dT%H%M%S)"

sudo -u postgres pgbackrest \
  --stanza=iron-pg \
  --pg1-path="$RESTORE_DIR" \
  --type=time \
  --target='<含時區的復原目標時間>' \
  --target-action=pause \
  --archive-mode=off \
  restore
啟動時綁定 Loopback 的 TCP 55432,確認 pg_is_in_recovery() 為 true、Recovery 已 Pause,再查詢 app.pitr_demo。預期結果是正式 Cluster 已刪除本次 PROOF_ID,隔離 Restore Instance 可以查到同一筆資料。
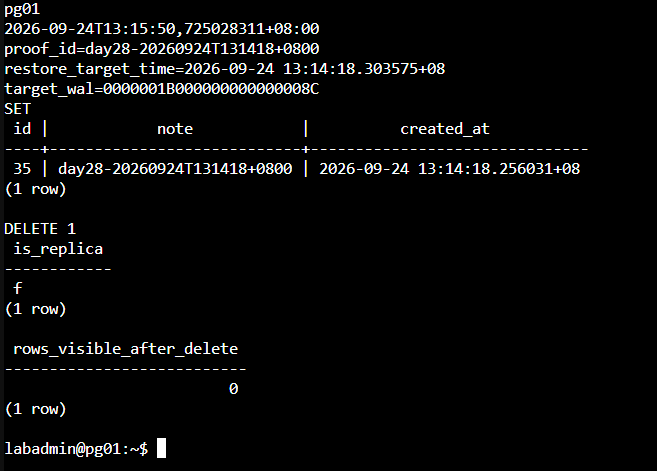
圖(九)目前 Primary 已完成 DELETE,正式 Cluster 查詢本次 PROOF_ID 的結果為 0 筆。
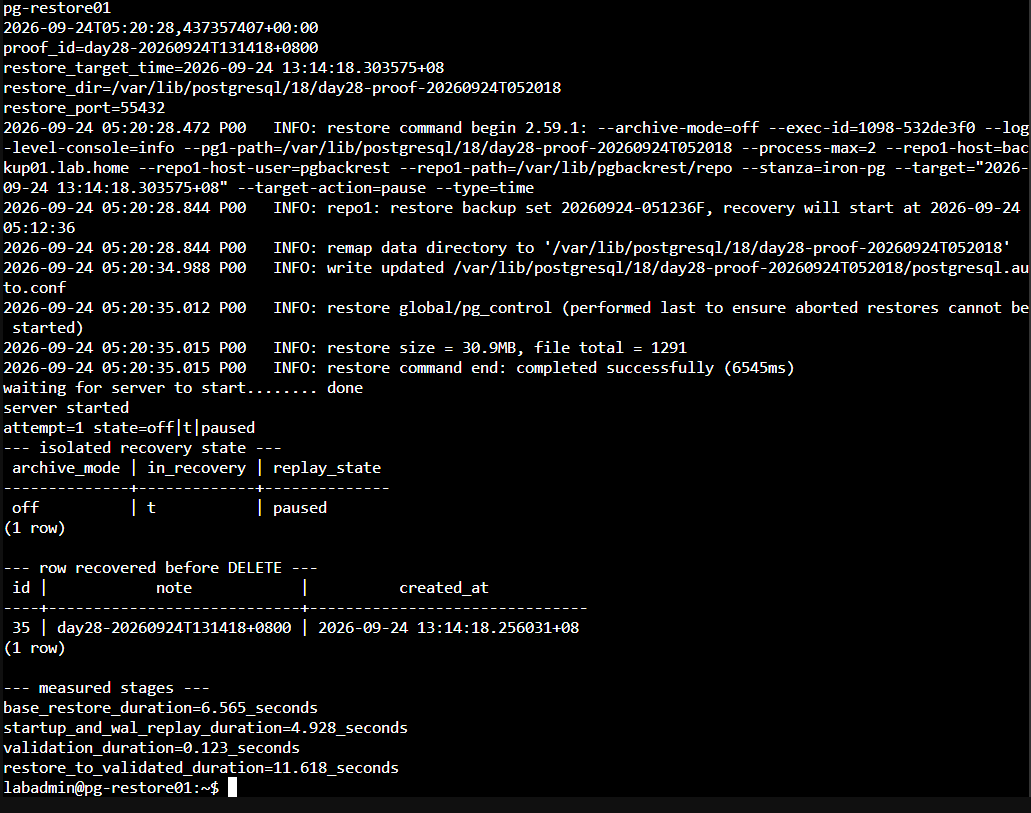
圖(十)隔離 Restore Instance 保持 archive_mode=off 與 Paused Recovery,並成功找回相同 PROOF_ID 的資料。
主 Lab 的 PITR 樣本量測結果如下:
| 階段 | 實測時間 |
|---|---|
| 還原基礎備份 | 6.565 秒 |
| PostgreSQL 啟動並重播 WAL 至復原目標 | 4.928 秒 |
| Recovery 狀態與資料查詢驗證 | 0.123 秒 |
| 從開始 Restore 到資料驗證完成 | 11.618 秒 |
這 11.618 秒是已知復原目標下的 Restore、WAL 重播與查詢驗證時間。完整服務 RTO 還要量測事故發現、選擇復原目標、建立還原主機、人工核准及重新開放正式服務。
完成驗證後立即停止 pg-restore01。這份結果驗證目前備份鏈可以還原到指定時間點,同時保留正式 Patroni Cluster 持續運作的邊界。
backup01 是獨立 VM,也使用獨立虛擬磁碟。但它與 pg01 位於同一台 PVE Host,且共享同一顆實體 500 GB 磁碟。這套 Lab 能驗證 pgBackRest、WAL Archive 與 PITR 流程。抵抗實體磁碟故障或整個站點毀損,還需要另一個故障域中的備份副本。
實際部署應把至少一份 Repository 放到不同 Host、不同儲存系統或異地位置,並限制資料庫節點與 Repository 的刪除權限。每次 PostgreSQL、pgBackRest、儲存架構或備份政策變更後,也要重新執行隔離還原。
本次主 Lab 驗證指定時間點可以完成 PITR。額外實作 再建立 seq=0 基準交易,確認該交易與命名還原點所在 WAL 已完成封存,接著把目前 Primary 的 archive_command 暫時改成 /bin/false。自動化腳本先等待 pg_stat_archiver 留下新的失敗紀錄,再以每秒一筆的速度提交 seq=1~15,最後記錄模擬事故時間。這樣可以排除登入其他主機、複製變數與人工排查所花的時間。
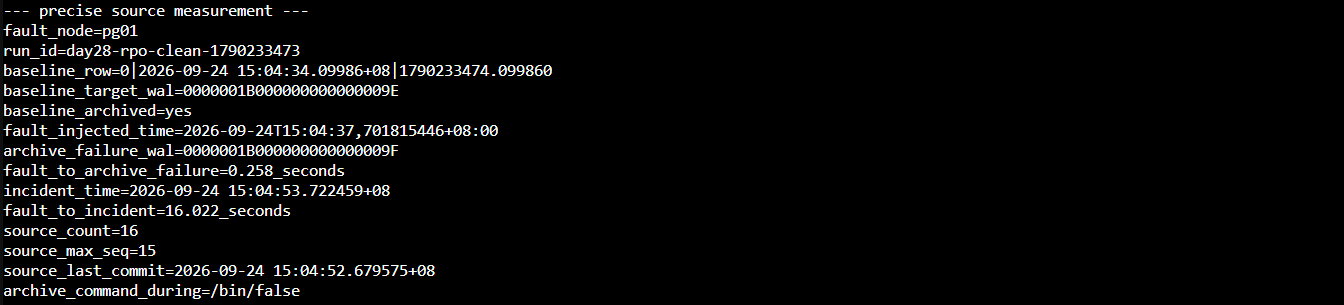
圖(十一)基準 WAL 9E 完成封存後才注入故障。pg_stat_archiver 於 0.258 秒後記錄失敗,腳本在 16.022 秒後完成 15 筆後續交易並固定事故時間。
pg-restore01 從 Repository 還原到事前建立的命名還原點。正式 Cluster 保存 seq=0~15 共 16 筆資料,Restore Instance 只看見已確認封存的 seq=0,因此本次資料缺口為 15 筆。
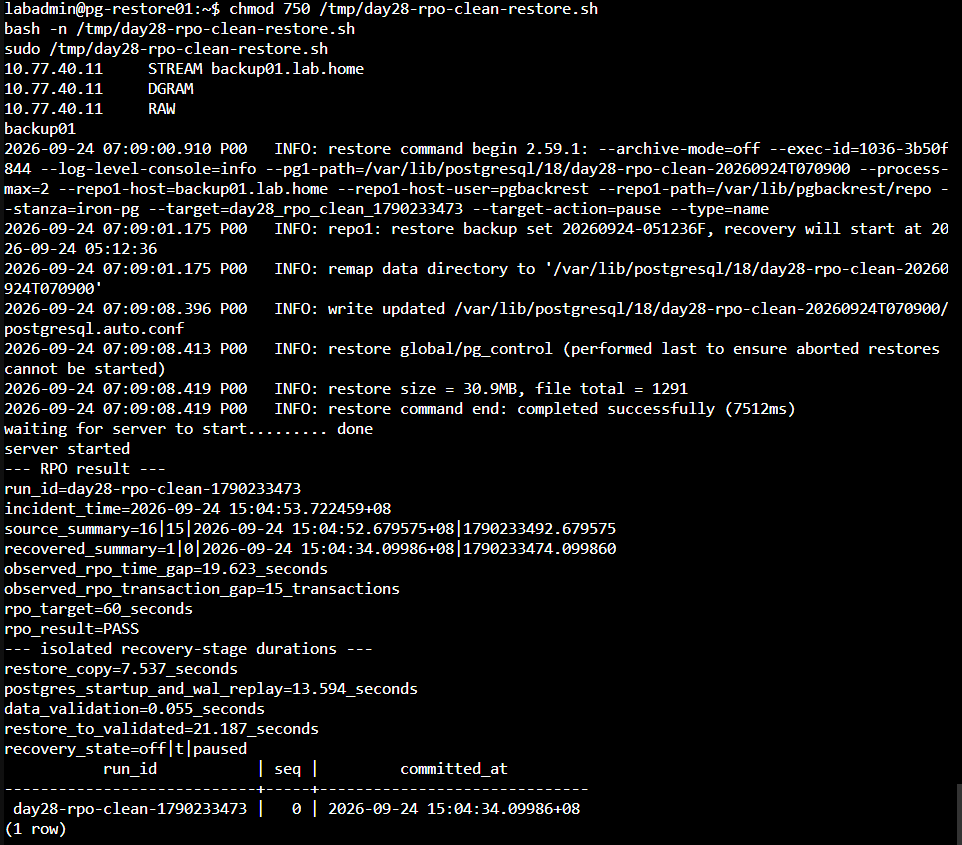
圖(十二)來源端最大序號為 15,隔離還原端最大序號為 0。事故時間與最後可復原交易相差 19.623 秒,低於事先設定的 60 秒 RPO。
本次補測結果如下:
| 項目 | 實測結果 |
|---|---|
| RPO 目標 | 60 秒 |
| 故障注入至 Archive 留下失敗紀錄 | 0.258 秒 |
| 故障注入至模擬事故 | 16.022 秒 |
| 最後可復原測試交易 | 2026-09-24 15:04:34.099860+08 |
| 模擬事故時間 | 2026-09-24 15:04:53.722459+08 |
| 正式 Cluster/Restore Instance 最大序號 | 15/0 |
| 觀察到的時間缺口 | 19.623 秒 |
| 觀察到的交易缺口 | 15 筆 |
| RPO 判讀 | PASS |
PASS 代表這次約 16 秒的受控 Archive 中斷樣本符合 60 秒目標。Repository 的復原邊界在 Archive 停止期間不會前進,因此持續中斷會讓資料時間缺口繼續增加。實際維運還要讓監控、告警與修復流程能在 RPO 用盡前完成處置。
RPO 補測使用另一個命名還原點重新建立隔離 Instance,並分別記錄各階段耗時:
| 隔離還原階段 | 實測時間 |
|---|---|
| pgBackRest 還原檔案 | 7.537 秒 |
| PostgreSQL 啟動並重播 WAL 至命名還原點 | 13.594 秒 |
| 查詢並驗證資料 | 0.055 秒 |
| 從開始 Restore 到資料驗證完成 | 21.187 秒 |
這 21.187 秒是隔離 Restore、WAL 重播與資料驗證的階段耗時。完整服務 RTO 還要量測事故判斷、選擇復原目標、核准及重新開放正式服務。
完成比較後,實驗恢復 pgBackRest archive-push,建立新的命名還原點並切換 WAL。last_archived_wal 在 3.550 秒後到達目標 WAL A2,最後由 backup01 再次執行 Repository Check。
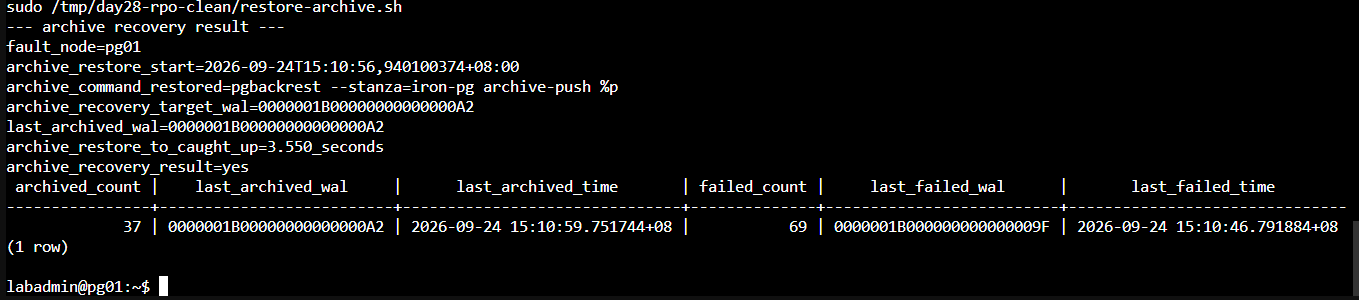
圖(十三)archive_command 恢復後,目標 WAL A2 已完成封存,Archive 追趕結果為 yes。
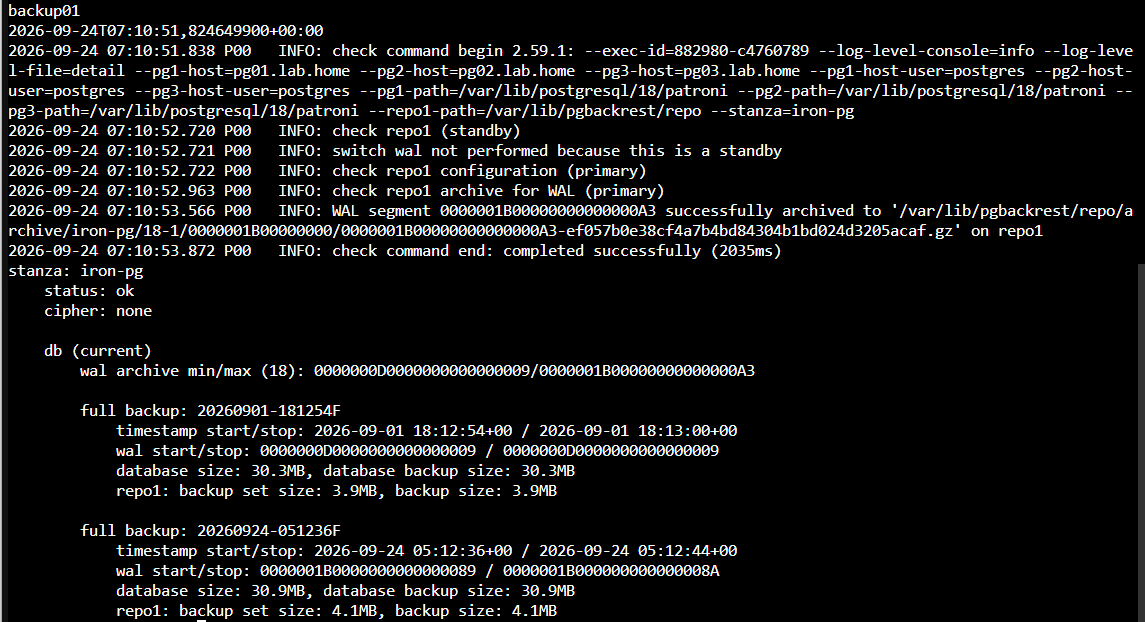
圖(十四)pgBackRest Check 成功、iron-pg Stanza 狀態為 ok,Repository 的 Archived WAL 已前進至 A3。
iron-pg Stanza。下一篇是 Day 29|在使用者回報前看見異常:Prometheus、Grafana、Exporter 與 Alertmanager 告警。我們會把 PVE、PostgreSQL、etcd、Patroni、代理服務與備份狀態轉成可以觀察的指標,建立儀表板與告警規則,讓故障、容量與備份異常能在影響擴大前被發現。


 iThome鐵人賽
 看影片追技術