
昨天講的那個 DNS 的坑,發生在測試環境。而同樣的坑在生產環境不可能發生,因為兩邊的網路根本不是同一種設計。
同一套架構,為什麼要做兩種? 環境之間不是應該盡量一致嗎?
測試環境: 資料庫自己一個網路,叢集在另一個網路,中間用對等互連接起來,再另外把 DNS 區域綁到叢集那個網路。
生產環境: 資料庫、叢集、VPN 閘道全部放在同一個網路的不同子網。不需要對等互連,DNS 也自動涵蓋。
有一點兩邊是一樣的:資料庫都得有一個自己的子網。Azure 的託管 MySQL 要求它所在的子網必須「委派」給資料庫服務,委派出去之後那個子網就整個歸它管,不能再塞別的東西進去。所以資料庫獨佔一個子網是規定,不是設計選擇。
真正的差別在那個子網位於哪個網路裡。
而測試環境為此多出來的東西,比看起來多。對等互連要建兩筆,兩個網路各一筆、方向相反,只建一邊的話狀態會停在等待對方,流量不會通。再加上昨天那個 DNS 區域的連結,總共三個物件,每一個都得設對,服務才走得到資料庫。
生產環境這三個都不需要。
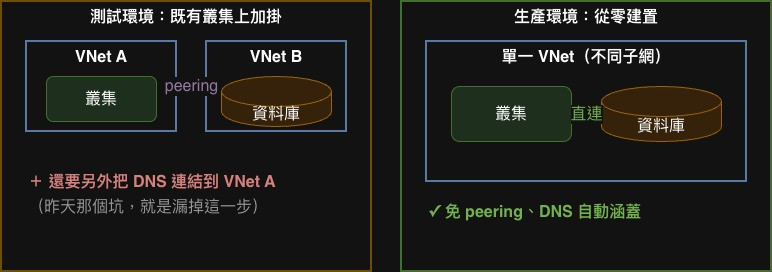
測試環境是在一個已經在跑的叢集上加東西。
那個叢集早就存在,有自己的網路,而且那個網路位於 Azure 自動管理的資源群組裡。這種資源群組有個特性:叢集重建的時候,裡面手動加進去的東西可能會被一起處理掉。 把資料庫塞進那個網路,等於把它的命運綁在叢集的生命週期上。
這個資源群組不是我們自己開的。建立叢集的時候 Azure 會自動生一個,名字長得像 MC_<叢集名>_<叢集名>_<地區>,叢集的節點、磁碟、網路都放在裡面。你看得到它,也可以往裡面加東西,但它是屬於叢集的。
所以當時的選擇是:資料庫另開一個自己的網路,再想辦法跟叢集接起來。多繞一段路,但資料庫的網路是我們自己的,放在我們自己的資源群組裡,不受叢集重建影響。
生產環境是從零開始建的。
因為是藍綠切換,新的叢集和新的資料庫是一起建的,兩個都是白紙。既然都是新的,就沒有「要不要塞進別人家」的問題,直接規劃一個網路、切三個子網(叢集一個、資料庫一個、VPN 閘道一個),各就各位。
建完之後我還是去確認了一次:把那個網路的對等互連清單打開看,確認它是空的。我大可以推論「同一個網路本來就不需要對等互連」,但這一路上已經被「應該沒問題」坑過幾次了,打開看一眼只要三秒。
我後來的想法是:這兩套的「架構」其實是一樣的,不一樣的是「接線方式」。
兩邊都是雲端資料庫、地端備援、VPN 打通、binlog 同步。真正做災害復原的那些東西完全相同。差別只在雲端內部,服務怎麼走到資料庫。
而這一段之所以不同,是因為兩邊的起點不同。測試環境的限制是真實存在的,不是我偷懶。
如果硬要讓兩邊一致,只有兩個做法:要嘛把生產也做成繞路的版本(明知有更簡單的做法卻不用),要嘛回頭把測試環境重建(為了一致性去動一個正在服務的環境)。兩個都不划算。
環境一致性是有價格的,而且不是每一段都值得付。
值得堅持一致的是「行為」:同樣的操作、同樣的參數、同樣的結果。這種一致性能讓你在測試環境驗證過的東西,在生產環境也成立。
不太值得堅持的是「長相」:資源怎麼擺、網路怎麼切。這些東西受限於環境的歷史,而歷史是改不掉的。
所以現在如果兩個環境有差異,我會問一個問題:這個差異會不會讓測試環境的驗證結果失效?
拿今天這個例子來說,測試環境多了對等互連和 DNS 綁定,生產環境沒有。這個差異的影響是:測試環境會踩到的坑,生產環境不會。 方向是安全的。
反過來就要小心了。如果是生產環境有測試環境沒有的東西,那你在測試環境驗過的一切,在生產環境都要重新想一次。
被迫換三次地區、最後在日本從零重建,當時很煩。馬來西亞連一台資料庫都建不起來,新加坡的配額未來半年都調不上去,才一路換到日本,這是 Day 6 那篇的內容。
那時候我只覺得是在賠時間。現在回頭看,那三次失敗買到的東西就是今天講的這一整套:一個不用對等互連、不用手動綁 DNS、少掉三個物件和三類故障的網路。
而如果馬來西亞第一次就建成功了,我不會去想這些。我會打開測試環境的設定照著複製一份,連同那些繞路一起帶過去。
因為那時候我根本不知道那是繞路。我只知道「測試環境就是這樣做的」。
明天講建置篇的最後一塊,一個跟資料庫無關但非搬不可的東西:韌體檔案。它們原本存在 Kubernetes 的磁碟裡,而那個磁碟同時只能掛在一台機器上。


 iThome鐵人賽
 看影片追技術