
前面 11 篇講的都是資料庫。但這次遷移要搬的東西,有一部分根本不在資料庫裡。
我們的產品會發布韌體更新,使用者的耳機透過 App 下載新版本。那些韌體檔案是實體檔案,不是資料庫裡的一列資料。它們原本存在 Kubernetes 的一塊磁碟上。
第一天講過資料庫不適合跑在 Kubernetes 裡,理由之一是那種磁碟通常同時只能掛在一台機器上。同樣的限制也落在韌體檔案上。
這裡其實是兩個不同的問題,當時我把它們混在一起看,後來才分清楚。
第一個問題是它綁在一台機器上。 那台機器出問題,檔案就拿不到;想跑多個副本分攤流量也不行,因為磁碟掛不了第二台;叢集重建的時候,這顆磁碟還得記得另外處理。
第二個問題是它完全不在災害復原的範圍內。 我們做了半天備援,binlog 同步過去的是資料庫裡的資料,這些檔案一份都不會跟著走。所以就算資料庫那邊做得再好,真的出事的時候,使用者還是下載不到韌體。
先講結論:這次搬家,只解決了第一個問題。第二個問題到現在還沒有完整的答案,這篇最後會回來講。
改用 Azure 的物件儲存(Blob Storage)。這種儲存本來就是設計來放檔案的,不綁在任何一台機器上。
規模其實不大。資料庫裡的韌體紀錄是 74 筆,不是幾萬筆。搬的過程也不複雜:寫一支腳本把磁碟裡的檔案複製到本機暫存,再上傳到儲存體。因為這件事和資料庫的資料完全獨立,可以跟資料庫遷移同時進行,不用排隊。
但「小」和「可以不做」是兩件事。它小到不值得開會討論,也小到很容易在盤點的時候整個被忘記。
我原本以為換儲存方式就一定要改程式。實際上有兩條路,而選哪一條,決定了韌體服務要不要被動到。
第一種是用 SDK 直接呼叫。 程式裡引入雲端廠商的函式庫,把原本「開檔案、寫檔案」的地方改成「呼叫上傳、呼叫下載」。這條路能用到物件儲存的全部能力,代價是服務裡所有處理檔案的邏輯都要重寫一次,然後重新測試。
第二種是把它掛成一個資料夾。 在叢集上裝一個驅動程式(Blob CSI driver),它會把儲存體裡的容器對應成一個目錄,掛進 pod 裡。程式看到的還是一個路徑,還是用讀寫檔案的方式操作,一行都不用改。
我們選的是第二種,理由很單純:這次遷移要改的東西已經夠多了,能少動一個服務就少一個。
而它跟原本那顆磁碟最大的差別是:這個資料夾可以同時掛在很多台機器上。第一個問題就是這樣解掉的。
不過這種掛法有個前提要知道:它不是真正的檔案系統。底層還是物件儲存,所以「在檔案中間插一段」「大量改名」這類操作會很慢,行為也不完全一樣。韌體檔案剛好是最適合它的那種東西:寫一次、之後只有讀,沒有人會去改檔案的中段。
一是叢集那邊要先打開這個功能。 除了安裝驅動程式,還要先在訂用帳戶那一層把它註冊起來。兩件事任何一件沒做,掛載都會直接失敗,pod 起不來。所以它被列進了切換當天的前置檢查清單,跟「資料庫連得到嗎」擺在一起。
二是要給驅動程式一組憑證,因為它要代替服務去存取那個儲存體。我們給的是兩個值。
accountName 是儲存體帳戶的名字。這個名字在全世界是唯一的,因為它同時就是那個儲存體的網址:https://<名字>.blob.core.windows.net。名字就是位址,這也是為什麼建立的時候名字撞到別人就得換一個。
SAS token 是一段帶簽章的字串,中文叫「共用存取簽章」。它的內容大致是:拿著這串東西的人,可以對哪些資源、做哪些操作、到什麼時候為止。
為什麼不直接用帳戶金鑰就好?因為金鑰的權限是全開的,而且沒有期限,等於把整個儲存體的鑰匙交出去。SAS 可以只給「讀這個容器」這種很窄的權限,而且可以設一個到期日。
那個到期日,就是這篇後面要講的地雷。
整條路徑串起來是這樣:
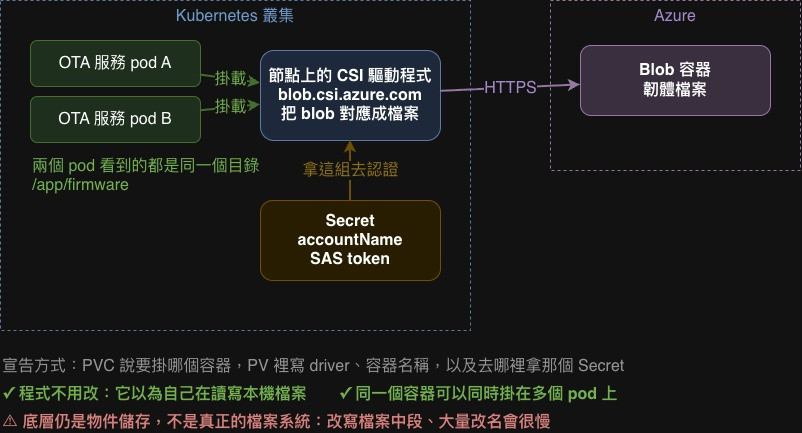
做事的不是 pod,是節點上的驅動程式。 pod 只是宣告「我要在這個路徑上掛一個東西」,真正拿著憑證去跟儲存體講話的是驅動程式。所以憑證不需要進到服務的程式或設定檔裡,韌體服務自己完全不知道 SAS token 的存在。
至於怎麼宣告,用的還是 Kubernetes 原本那套:一個 PVC 說「我要掛哪個容器」,背後的 PV 裡寫著要用哪個驅動程式、容器叫什麼名字、以及去哪裡拿那個 Secret。跟原本掛磁碟的寫法幾乎一樣,換掉的只是底下接的東西。
回到開頭那兩個問題。第一個解決了,第二個沒有。
寫這篇的時候我去翻自己的架構文件,看到儲存體的等級寫著本地備援。這個等級的意思是:檔案會在同一個資料中心裡存好幾份,硬碟壞掉、機架出問題都救得回來。
但它保護不了「整個區域出事」。而整個區域出事,正是我們做這整套災害復原要防的那件事。
再加上一件事:這個儲存體跟資料庫、叢集、VPN 閘道在同一區。當初刻意把它們放在一起是為了少掉跨區的複雜度(Day 11 講的那些),但這也代表它們共享同一個命運。
所以現在的狀態是:資料庫有一份即時的副本躺在公司機房裡,韌體檔案沒有。
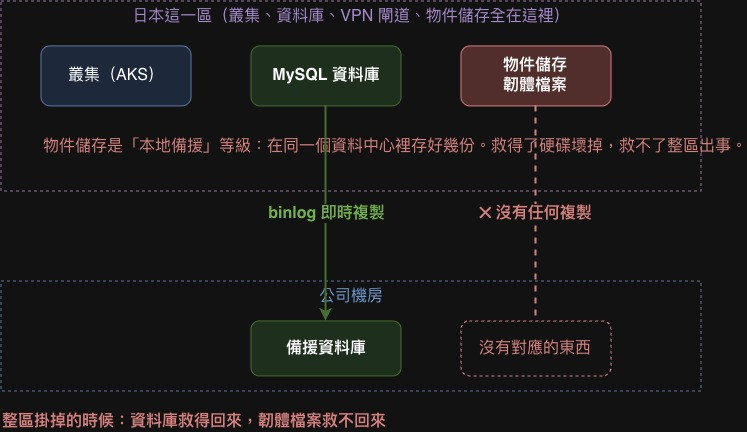
這不是搬去物件儲存搬錯了,搬過去確實解掉了「綁在一台機器上」。只是我當初把「不綁機器」跟「有異地備援」當成了同一件事,而它們不是。
前面那組 SAS token,我們簽的期限是一年。
明年的這個時候,如果沒有人記得換,韌體下載會突然壞掉。而那一天不會有任何前兆,前一秒還好好的。
這種東西最麻煩的地方在於,它不會出現在任何監控上。監控看的是「現在有沒有壞」,而它現在好得很。它要等到那一天才變成一個問題,而那一天通常不會挑你方便的時候。
規劃災害復原的時候,我一開始的清單只有「資料庫」。但一個服務要跑起來,需要的東西不只資料庫,而每一樣都得問一次有沒有備援。
以我們的情況,答案至少有三類:資料庫裡的資料、資料庫外的檔案,還有那些讓服務跑得起來的設定和憑證。
這份清單我原本以為只有第三類是空的。實際去翻儲存體的設定,才發現第二類也只做了一半。
所以現在如果要盤一個系統的災害復原,我會從「把整個區域關掉,哪些東西拿不回來」這個角度列清單,而不是只想著資料庫。這個問法比「哪些東西壞了服務會起不來」更嚴格,因為它會把那些「已經有備援、但備援跟本體放在一起」的東西也照出來。
到這裡建置篇結束,網路通了、資料庫建好了、檔案也搬了。明天開始進入遷移篇,第一件事是決定要怎麼搬資料。我原本打算整包倒出來再灌進去,後來發現這個方法會帶來一個很麻煩的副作用。


 iThome鐵人賽
 看影片追技術