
昨天說到生產環境的做法是「服務先建結構、我們只灌資料」。今天講倒資料那一步。
原本我以為這步很單純:一個指令把資料倒出來,另一個指令灌進去。實際上中間要做的事比想像中多,因為新舊兩邊的名字對不起來。
一、資料庫的名字改了。
舊環境有幾個資料庫的名字是早期隨手取的,跟後來訂的命名規範對不上。既然要搬家,順便統一。所以倒出來的檔案裡,INSERT INTO 舊名字.某張表 要改成 INSERT INTO 新名字.某張表。
二、有一個欄位的名字改了。
韌體服務那邊有個欄位,新版程式用的名字跟舊資料裡的不一樣。所以那張表的資料要在途中改欄名,不然灌進去的時候會說「沒有這個欄位」。
三、有一張表整個跳過。
舊環境有一張稽核紀錄的表,已經沒有任何程式在寫、也沒人在讀,就是躺在那裡佔空間。既然是搬家,這種東西沒必要帶走。
這三件事全部寫在同一支匯出腳本裡。它跑一輪大約八分鐘,倒出六個資料庫的資料,而倒出來的東西已經是可以直接灌的樣子,不需要再開檔案改任何一個字。
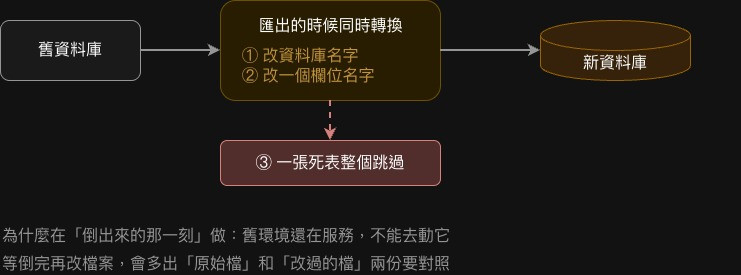
有三個時機可以選:倒出來之前(在舊資料庫上改)、倒出來之後(改檔案)、灌進去的時候(改目標)。
我們選了倒出來的那一刻,也就是匯出腳本一邊倒、一邊順手改。
理由是舊環境還在服務使用者,不能為了搬家去動它。而如果等倒完再改檔案,就會多出一個「原始檔」和「改過的檔」,兩份要對照、要確認改對了、重跑的時候還要記得從哪一份開始。倒的時候一起做,出來就是可以直接用的東西。
還有一個參數幫了大忙:匯出的時候要求它在每一行資料都把欄位名字寫出來。預設的寫法只有值,靠位置對應;加上這個參數之後,每一行都明確寫著哪個值要放進哪一欄。
這件事有兩個好處。第一,改欄名變成單純的文字替換,因為欄位名字就明明白白寫在那裡。第二,萬一新舊兩邊的欄位對不上,它會直接報錯說「沒有這一欄」,而不是默默把值塞進錯的欄位。後面會有一整篇在講「靠位置對應」出事的時候有多難查,而這裡加一個參數就先躲掉了一種。
上面講的都是「倒出來之後要改什麼」。而在那之前還有一個更基本的問題:怎麼倒。
資料庫跑在叢集的容器裡。最直覺的做法是進到那個容器裡執行匯出指令,然後把輸出接回本機的檔案。測試環境第一次搬的時候我就是這樣做的。
指令跑完,檔案產生了,將近一 GB,看起來很正常。但那個檔案是斷的。
它在第三萬兩千多行的地方直接結束,最後一行停在一個還沒寫完的數值中間:
"quality":[1.53,1.16,0.79,0.86,1.41,
沒有收尾的括號,沒有分號,後面什麼都沒有。那張交易紀錄的表預期有 15,405 筆,這個檔案裡只有 15,234 筆。
原因是「進到容器裡執行指令、再把輸出接回來」這條路本來就不是設計來搬大量資料的。中間的輸出有緩衝機制,量一大就可能在某處斷掉。而它斷的時候不會報錯:指令正常結束、回傳成功、檔案也確實產生了,只是內容少了一截。
改法是換一條路:不進容器,改成在本機開一條通往那個容器的通道,再用本機的資料庫工具透過那條通道連進去倒。這樣走的是資料庫自己的連線協定,而不是被層層轉發的文字輸出。
換完之後同一張表倒出來是 976 MB,筆數一筆不差。
現在生產環境那支匯出腳本用的就是這個做法。它每倒完一個資料庫會印一行 Terminated: 15,那是關掉通道的正常訊息,不是錯誤。這句話我特地寫進文件裡,因為它長得實在太像出事了。
搬完之後要做三方比對,確認每張表的筆數對得上。而那張被跳過的表,在比對結果裡會變成「來源有、目標沒有」。
它是我們刻意造成的差異,但機器不知道。所以驗證腳本必須事先知道這張表是故意跳過的,把它歸到「可以忽略」那一類。
每一個刻意的差異,都要在驗證那一步登記一次。 不然它會在停機視窗裡變成一個紅字,而你得當場判斷它到底要不要理。那不是你想在那個時間點做的判斷。
前面說新環境的結構比較乾淨,不帶歷史包袱。但有一個欄位是例外。
其中一個服務的表上有一個欄位,新版程式已經不建它了,但舊資料裡有值。灌資料的時候,會因為目標表沒有這一欄而失敗。
所以匯入腳本裡加了一段:灌之前先檢查那個欄位在不在,不在就補上去,然後才灌。先查再補是為了讓腳本可以重跑,已經補過的話就跳過。
文件裡管這個欄位叫「遺留欄」。也就是說:昨天才說要把歷史包袱留在舊環境,今天就為了把資料灌進去,親手把一個包袱加回新環境。
我沒有更好的解法。資料在那裡,總不能因為新程式不用就把它丟掉;而新程式不建這一欄,代表它確實已經不需要那些值了。所以新環境現在有一個欄位,沒有任何程式會讀它,它存在的唯一理由是裝得下舊資料。
它會在那裡待到有人想起來為止。
策略 2 的前提是「服務啟動時會自己把表建好」。但有三張表它建不出來。
原因是那幾張表有欄位需要唯一索引,而框架在沒有指定長度的情況下,會把字串欄位建成「長文字」型別。而 MySQL 8 不接受長文字欄位加唯一索引,會直接拒絕,錯誤碼 1170。
框架其實有備案:它偵測到失敗之後,會改用另一種寫法再試一次。但那個寫法在這個版本的 MySQL 上語法不合,換來另一個錯誤 1064。兩條路都走不通,表就是建不出來。
解法是我們自己寫一份建表的 SQL,把索引用到的那幾個欄位明確指定成有長度的字串,先把表建好。框架啟動時看到表已經存在,就不去動它。
但這只是繞過去,不是修好。 真正的修法是回到程式碼,在那兩個欄位上直接標明型別,標了之後這份 SQL 就可以退掉。現在的狀態是:我們賭框架不會去動已經存在的欄位。哪天框架版本變了,或是有人把那幾張表刪掉重建,同樣的錯誤會再出現一次。
這件事我寫進文件裡了,標明是暫時的做法,也寫了根治的方法該怎麼做。寫下來不會讓它自己修好,但至少下一個撞到的人不用把整條推理再走一遍。
搬家的時候順便改名字,是一個很有誘惑力的選擇,因為「反正都要動了」。
我後來覺得判斷標準是:這個改名,是不是在搬家的時候做最省事?
改資料庫名字符合這個標準,因為它本來就要重建一次,順手改跟不改的成本一樣。而如果不趁現在改,之後要改就得停機、改設定、重新部署,代價高很多。
反過來,如果一個改動在平常也能做,那就不要塞進搬家。搬家當天要驗證的東西已經夠多了,每多一個改動,出事的時候就多一個嫌疑犯。
明天講灌進去那一步。新的資料庫是私有的,我的電腦連不到它,所以資料要先想辦法「進到那個網路裡面」才灌得進去。


 iThome鐵人賽
 看影片追技術