
上一篇談 User Interview 時,我們一直在問同一件事:使用者到底遇到什麼問題?
不過,當我們真的開始看數據、做 Survey、訪談使用者之後,很快會遇到另一個麻煩。
假設現在產品的 Activation Rate 是:
Activation Rate = 55%
這個數字看起來很明確。
但如果往下拆,可能會變成:
建立 Workspace 的管理者:80%
被邀請進來的協作者:31%
個人使用者:62%
那原本的 55% 到底代表什麼?
如果我們現在正在改善「邀請別人一起協作」這段流程,真正值得看的顯然不是所有使用者的平均,而是那些被邀請進來的人有沒有成功開始使用。
這就是平均值很容易藏起來的東西。
前面談 Funnel、Activation、Retention 時,我們常常會用「使用者」當成一個整體。
但同一個產品裡,不同人可能正在完成完全不同的 Job。
以文件協作產品來說:
如果把這些人全部塞進同一條 Funnel,得到的數字當然還是正確,但它可能回答不了我們現在真正想問的問題。
所以做分析時,除了問「這個 Metric 是多少」,還需要問:
這個 Metric 是哪一群人的?
講到 Segmentation,很容易先想到年齡、國家、裝置或方案。
這些資訊有時候有用,但產品分析裡更常見的分法,其實是使用者目前處在什麼狀態。
例如:
自己註冊的人
被別人邀請進來的人

已經完成第一次協作的人
還沒有完成第一次協作的人

最近 30 天仍然活躍的人
已經流失的人
這些 Segment 的價值在於,它們通常和使用者現在正在完成的 Job 更接近。
例如一個被邀請進來的 reviewer,如果他的 Job 只是「看完內容並留下一句 comment」,那要求他先建立完整帳號、設定 Workspace、看完 Onboarding,反而可能是在替另一種使用者設計流程。
這也意味著,同一個產品裡,不同 Segment 甚至可能有不同的成功定義。
在 PostHog 裡,如果只是想知道不同群組的 Funnel 或 Retention 有沒有差,可以先用 Breakdown。
例如把 Activation 按 role 拆開,發現:
owner        80%
collaborator 31%
individual   62%
這時 Breakdown 已經完成它的工作:它讓我們看到原本平均值藏起來的差異。
但如果接下來真正想研究的是:
被邀請進來,但 24 小時內沒有完成第一次協作的人。
那這群人就不只是某一張圖上的切法了。
我們可能會想:
如果每一次都重新把條件設定一遍,不只麻煩,也很容易每張圖用到的定義不完全一樣。
這時就很適合把這個 Segment 保存成 Cohort。
在 PostHog 裡,Cohort 可以依使用者 Property 或實際發生過的行為建立。
例如我們可以定義:
被邀請進 Workspace
AND
24 小時內沒有留下第一則 Comment
或者:
建立 Workspace
AND
邀請過至少一名使用者
AND
7 天內沒有任何 collaboration event
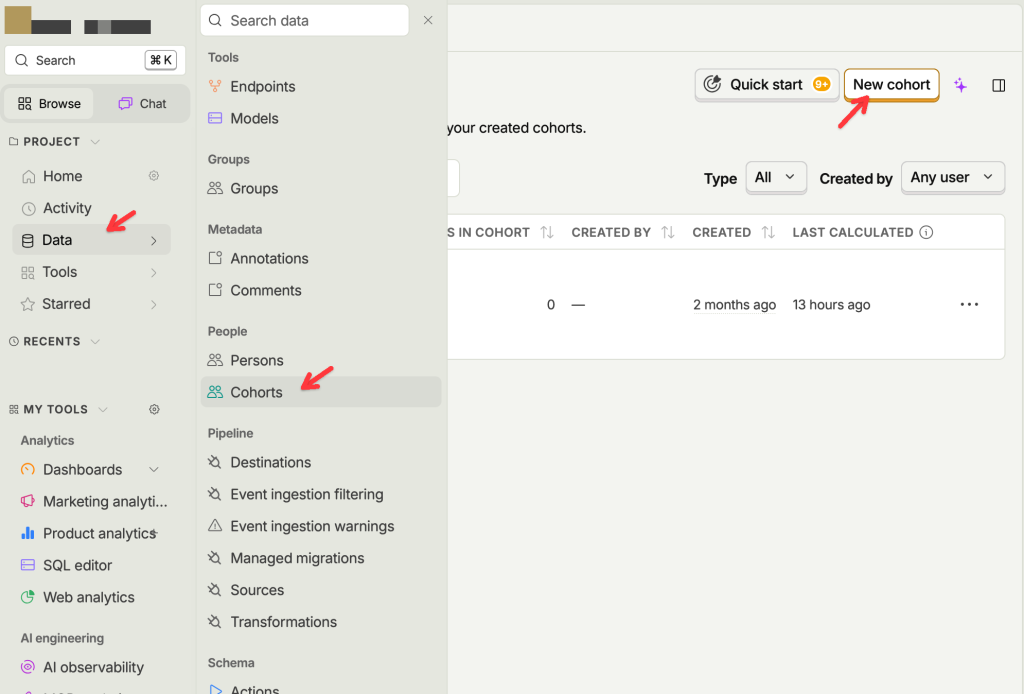
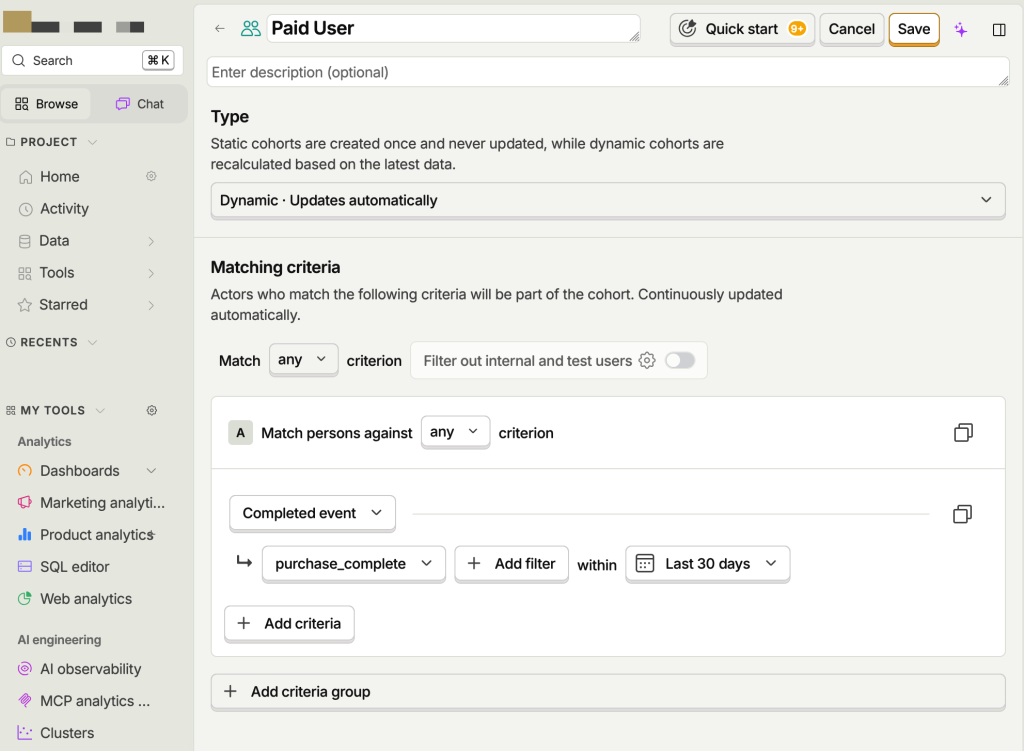
和單純的 demographic segmentation 相比,這種 Behavioral Cohort 往往更適合拿來研究產品問題。
因為它描述的不是「這個人是誰」,而是:
這個人現在在產品旅程裡發生了什麼。
一旦把它存成 Cohort,後面就可以重複用同一個定義。
Cohort
↓
Funnel / Retention
↓
Session Replay
↓
Survey
↓
User Interview
工具本身並不複雜,真正重要的是 Cohort 讓 quantitative 和 qualitative 的研究對象開始對得起來。
我們在數據裡看到「這群人特別容易失敗」,接著看的 Replay、問的 Survey、找來訪談的人,都是同一種使用情境。
這比先看一張整體 Funnel,然後再隨便找幾個使用者來問,通常更容易得到有用的答案。
這也會回到上一篇 User Interview。
如果我們只找 Power User 訪談,聽到的大多會是已經成功留下來的人遇到的問題。
他們可能想要更進階的搜尋、更多快捷鍵、更完整的權限設定。
但如果現在真正想知道的是「為什麼新使用者兩天內就離開」,這批人反而不是最適合的受訪者。
比較合理的做法是先從問題定義研究對象。
例如:
想研究 Onboarding Drop-off
→ 找在特定步驟離開的人

想研究 Retention
→ 比較留下來和離開的人

想研究協作失敗
→ 找被邀請但沒有完成第一次協作的人
Cohort 在這裡的作用,不是幫我們決定「哪一群使用者比較重要」,而是讓研究問題和研究對象對得起來。
假設新的 Onboarding 上線後,整體 Activation:
50% → 56%
看起來變好了。
但拆開後可能是:
個人使用者:45% → 68%
團隊管理者:72% → 48%
平均值本身沒有錯。
只是它回答的是「所有使用者混在一起之後發生什麼」,而不是「我們這次真正想改善的那群人發生什麼」。
所以看到一個 Metric 時,除了確認定義、分母、時間窗以外,還值得再多問一句:
這裡面混了哪些不同的使用情境?
有時只需要 Breakdown 就能回答;如果這群人接下來會反覆出現在分析、Replay、Survey 或 Interview 裡,那就值得把它正式變成 Cohort。
這樣我們最後得到的不只是一個更漂亮的分群,而是一條比較完整的研究路徑:
看到整體異常
↓
Breakdown 找到差異
↓
定義值得研究的 Segment
↓
保存成 Cohort
↓
用同一群人繼續分析與研究
下一篇開始會進入 AI 功能。
到了 AI,這件事反而會更重要。因為同一個 Agent 面對不同任務、不同使用者時,「成功」很可能完全不是同一件事。如果連測試對象和使用情境都混在一起,最後得到的 Eval 分數也很容易只是另一種平均值。
如果你願意花 30 秒留下回饋,我會用這些意見來調整後續文章:分享你的意見



 iThome鐵人賽
 看影片追技術