
AI 改完程式,回報最後一段寫著:
pytest: 99 passed
99 個測試通過,看起來像好消息。
可是交代工作的時候,你寫過「測試至少要 1468 個通過」。99 跟 1468 擺在一起,你大概馬上看得出不對。問題是它們很少擺在一起:一個在你交出去的工作單最底下,一個在 AI 交回來的回報最後面。
今天講的漏法是:該跑的測試寫進了工作單,回報裡也有數字,可是那個數字沒人拿去跟基準對。
usage 是我做的開源小工具,顯示 Claude Code、Codex 這幾家 AI 工具的用量額度還剩多少。它在 Mac 上是選單列的一個小圖示,那段程式全放在一個叫 menubar.py 的檔案,一千五百多行。專案替這個檔案訂了行數上限,它已經頂到上限,再多一行,CI(每次推上 GitHub 就自動跑的一輪檢查)就會亮紅燈。
那天要把它拆小。我在 Claude Code 裡跟 Claude 對話,由它把工作單派給 Codex 去改程式,Codex 做完,回報再交回 Claude 這邊。工作單開頭先寫了現況:
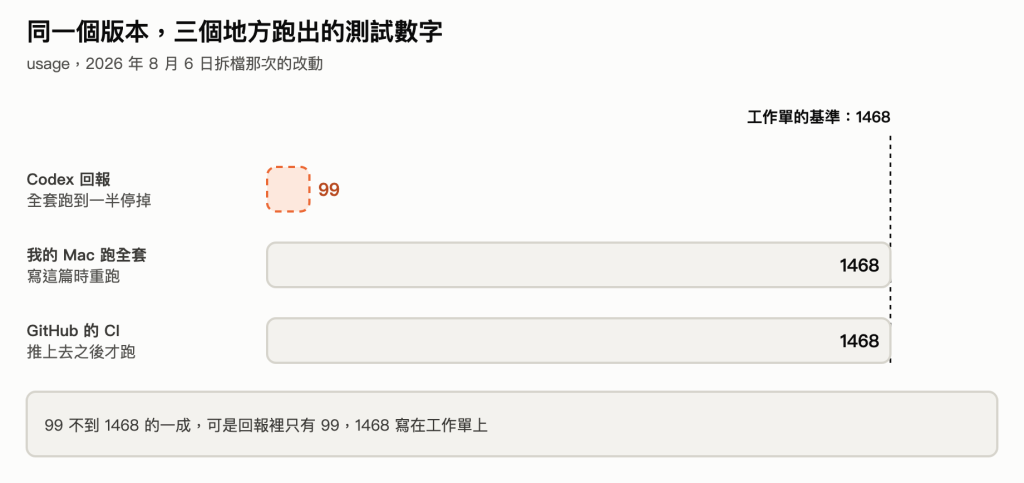
全套測試現況:.venv/bin/python -m pytest -q → 1468 passed, 2 skipped。這是基準,不准變少。
pytest 是跑測試的工具。1468 passed, 2 skipped 是 1468 個通過、2 個跳過。拆檔案只是搬家,程式該做的事一樣都不變,所以測試一個都不該少。
工作單最底下的成功標準,第一條又寫了一次:
.venv/bin/python -m pytest -q ≥ 1468 passed, 2 skipped
工作單要求回報只寫一行。Codex 交回來的是這樣:
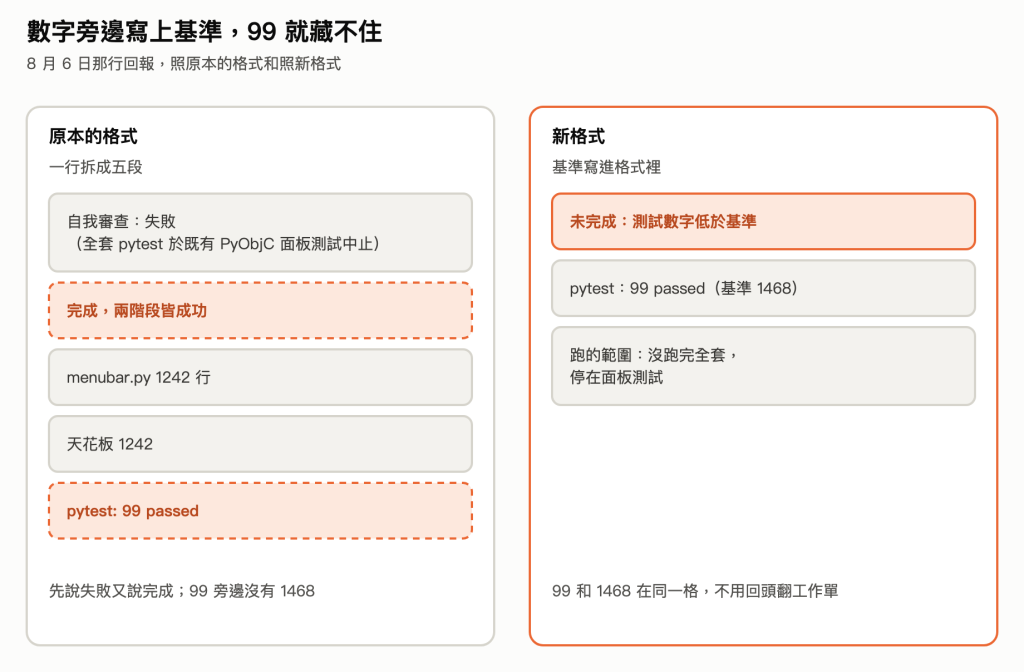
自我審查:失敗(全套 pytest 於既有 PyObjC 面板測試中止)|完成,兩階段皆成功|menubar.py 1242 行|天花板 1242|pytest: 99 passed
用直線隔開,拆成五段來看:
同一行裡,第一段說失敗,第二段說完成。最後一段的 99,跟工作單上的 1468 差了一千多個。
寫這篇時,我把後來推上去的那個版本拿出來,在自己電腦上跑了兩次。一次只跑選單列那一個測試檔,一次跑全部:
$ pytest tests/test_menubar.py -q
99 passed in 2.36s

$ pytest -q
1468 passed, 2 skipped in 10.13s
那個版本一共有 77 個測試檔。Codex 那次到底跑了哪些,回報沒寫;數字對得上的,是其中這一個檔。
全部跑,在我的 Mac 上是 1468,一個都沒少,也沒有停掉。
那 Codex 那邊為什麼會停?它也是在我的 Mac 上改程式,可是被關在沙盒裡跑。沙盒是替 AI 隔出來的環境,限制它能碰電腦上哪些東西。它的回報說,usage 有幾個測試會真的在畫面上做出一個面板來檢查,在沙盒裡跑到這裡,整個測試程式就停掉,不是單純一個測試失敗。更早的回報貼過錯誤訊息,是這一行:
Fatal Python error: Aborted
全套在沙盒裡跑不完,所以回報的 99 不是全套的結果。
回到 8 月 6 日那天。回報進來之後,15:29 我問了一句:
commit push 該發版?
Claude 請我先打開新版,點一點選單列的面板,看有沒有哪裡壞。15:31 我回:
commit + push;
不到一分鐘,這次的改動存進版本紀錄,推上 GitHub。
存下來的對話裡,從回報進來到推上去,沒有人提到 99 跟 1468 對不上。
推上去之後,GitHub 上的 CI 跑了全部測試。Mac 那組的結果是:
1468 passed, 2 skipped in 20.51s
一個都沒少。測試抓得到的地方,這次搬家都沒弄壞。
這次是運氣好。要是搬家弄壞了哪個測試,壞掉的版本已經推上 GitHub 了。存下來的紀錄裡,全套的數字第一次出現,是推上去之後 CI 跑出來的。
沒弄壞靠運氣,99 會被看過去卻有原因。回頭看工作單,它要的回報格式是這樣:
完成,兩階段皆成功|menubar.py N 行|天花板 N|pytest: N passed
N 是讓 AI 填數字的空格。這個格式有兩個地方,讓 99 很容易被看過去。
第一,「完成」寫在格式最前面。同一張工作單還有兩條要求,一條在自我審查那段,一條在輸出那段:
在報告開頭寫一行「自我審查:通過/失敗+原因」
stdout 只回一行
stdout 就是 AI 最後印出來、交回來的那段文字。開頭要一行自我審查,全部又只能回一行,格式的第一個詞又寫死是「完成」。三件事擠在一起,就變成開頭寫失敗、接著寫完成。
第二,數字旁邊沒有基準。格式只留了一格 pytest: N passed,填進去的是多少,就顯示多少。1468 寫在工作單上,回報裡沒有它。99 單獨站在那裡,看起來就是一個結果。
要改的是回報的格式:把基準寫進格式裡,讓 AI 填數字的時候,基準就在旁邊。
pytest:N passed(基準 1468)|跑的範圍:全套/只跑了哪些檔
再加兩條規矩:
- N 比基準少,不准寫「完成」,開頭寫「未完成:測試數字低於基準」
- 全套跑不完,寫出只跑了哪些檔、停在哪裡,剩下的由我在自己電腦上跑
照這個格式,8 月 6 日那行回報會長這樣:
未完成:測試數字低於基準|pytest:99 passed(基準 1468)|跑的範圍:沒跑完全套,停在面板測試
最後那句「剩下的由我在自己電腦上跑」,是因為那時 AI 的沙盒跑不完全套,我自己跑得完。Codex 改的就是我電腦上的專案資料夾,推上去之前,改動已經在我這裡了。跑一次全套在我的 Mac 上只要十秒。推上去之前跑這十秒,不用等 CI 替我對數字。
現在就可以做一件事:翻出你最近一次叫 AI 跑測試的回報,找到它寫的那個數字。
然後在自己電腦上,把全部測試跑一次,看最後一行。
兩個數字一樣,至少數量對上了。不一樣,就回頭問 AI:那次跑的是哪些?
工作單裡有一格「做完怎麼算對」,Day 4、Day 8 到 Day 11 各在這格加了幾行。今天再加一行:
做完怎麼算對:
- (Day 4、Day 8 到 Day 11 加的幾行)
- 回報的測試數字旁邊寫上基準:「pytest:N passed(基準 ____)|跑的範圍:____」;N 比基準少不准寫完成,全套跑不完就寫只跑了哪些,剩下的我自己跑
今天的數字,是拿測試去對測試。明天看另一種:測試全綠,算出來的錢卻跟官方對不上。8 月 27 日,同一段 Claude Code 的對話,usage 算出來是 1.37 美元,官方的數字是 2.49 美元,少算了四成多。


 iThome鐵人賽
 看影片追技術