

如果把基因製造蛋白質的過程,比喻成製作一部賣座電影: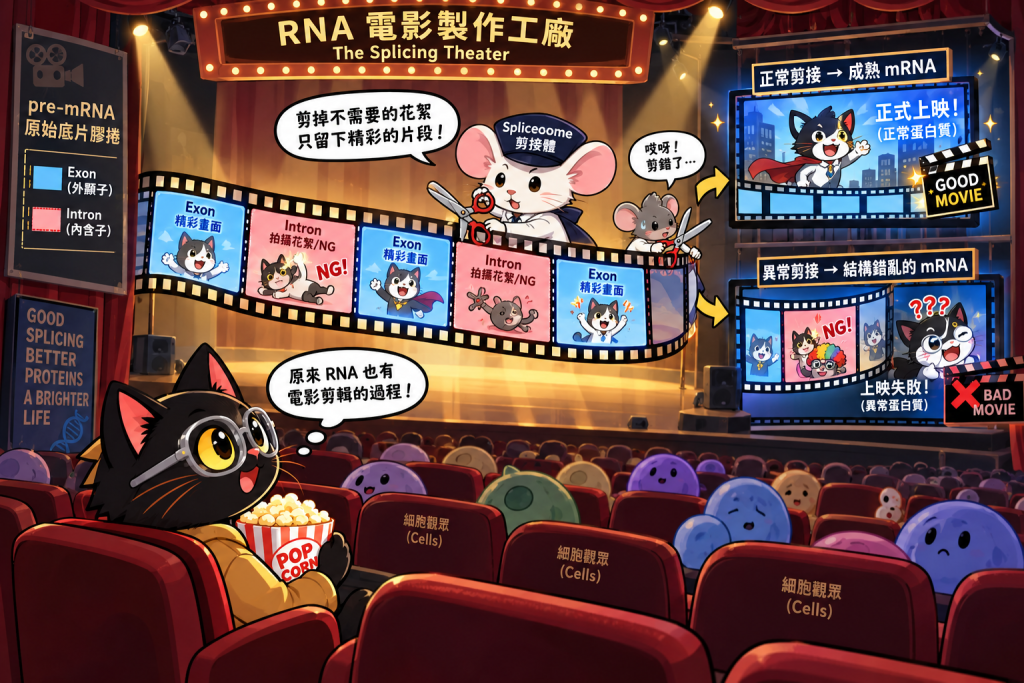
但如果有人偷偷在一段本該被剪掉的花絮中間,貼上了一個 偽造的「剪切記號」 呢?
剪輯師被欺騙後,在錯誤的地方剪了一刀,結果把一段荒謬的 NG 花絮也一起黏進了正式上映的電影裡。觀眾(細胞)看了這部結構混亂的電影,做出來的產品(蛋白質)直接癱瘓崩潰!
這就是 AlphaGenome 在那名六週大癲癇嬰兒大腦裡抓到的致命真兇—— 隱藏剪接(Cryptic Splice Site)!今天,我們就來還原這個分子犯罪現場,並看看我們該如何在系統中打造一個「剪接異常偵測器」!
昨天我們提到,醫療團隊曾試圖從嬰兒的血液中提取 RNA 進行定序,想看看基因表現有沒有出錯,結果血液報告卻「一片祥和」,什麼異常都沒抓到。
AlphaGenome 點出了血液檢測失敗的殘酷真相:組織特異性(Tissue Specificity)。
這個發生在 DNM1 基因上的突變,影響的是一段 **專屬於大腦神經元(特別是麩胺酸能神經元 Glutamatergic neurons)**才會上映的「神經元限定版電影」。
去血液水管裡採樣,當然什麼異常訊號都抓不到!AlphaGenome 直接在電腦裡模擬大腦神經元的內部環境,才讓這個藏在大腦深處的慘案重見天日。
那麼,這個深藏在 98% 基因暗物質(深層內含子)裡的單一 DNA 字母突變(G>A),究竟是如何毀掉大腦的?
這多出來的 13 個胺基酸就像是在齒輪上硬塞了一顆小石頭,徹底破壞了 Dynamin 蛋白質的結構,讓神經突觸無法正常傳導訊號,引發了嬰兒毀滅性的癲癇發作!
| 步驟 | 正常的剪接過程(健康狀態) | 發生突變後的異常剪接(嬰兒大腦) | 最終對蛋白質的影響 |
|---|---|---|---|
| 1. 記號識別 | 剪接體準確識別正確的外顯子邊界。 | 突變創造了偽造的「隱藏剪接記號」。 | 剪接體被欺騙,切錯位置。 |
| 2. 內含子處理 | 內含子花絮被 100% 完美切除丟棄。 | 保留了 39 個本該丟棄的內含子字母。 | 成熟 mRNA 裡面摻雜了廢料。 |
| 3. 蛋白質成品 | 產出正常長度、功能完整的蛋白質。 | 產出過長、多出 13 個胺基酸的蛋白質。 | 蛋白質結構損壞,失去神經傳導功能。 |
verify_disease_dataset.py)今天,我們迎來第二階段的終極成果!
我們讀取你在 config.py 選定的研究主題,一次批量測試 3 個同領域的候選變異,並在 Terminal 終端機印出一張 「多變異分子特徵對比表」!
verify_disease_dataset.py# verify_disease_dataset.py - 里程碑 2:自訂主題多變異特徵對比表
import config
from track_feature_extractor import AlphaGenomeFeatureExtractor
def run_disease_dataset_benchmark():
# 根據讀者主題,設定 3 個候選測試變異
candidate_variants = [
config.TEST_VARIANT,
f"{config.TEST_VARIANT.split(':')}:128225900:A:G",
f"{config.TEST_VARIANT.split(':')}:128225910:C:T"
]
extractor = AlphaGenomeFeatureExtractor(target_tissue=config.TARGET_TISSUE)
print("="*75)
print(f"📊【 里程碑 2:{config.MY_DISEASE} - 候選變異多模態特徵對比表 】")
print(f"🧬 目標基因 : {config.MY_GENE} | 🎯 目標器官 : {config.TARGET_TISSUE.upper()}")
print("="*75)
print(f"{'變異座標':<22} | {'AVI分數':<8} | {'剪接 Delta':<10} | {'破壞 Motif 家族':<18}")
print("-" * 75)
for var in candidate_variants:
res = extractor.extract_all(var)
print(f"{res['variant_id']:<22} | {res['avi_score']:<8.1f} | {res['max_delta_splicing']:<+10.4f} | {res['affected_tf_motif']:<18}")
print("="*75 + "\n")
if __name__ == "__main__":
run_disease_dataset_benchmark()
當在 Terminal 輸入 python verify_disease_dataset.py 時,會拿到這張 里程碑 2 對比表:
===========================================================================
📊【 里程碑 2:難治型幼兒癲癇 (Epileptic Encephalopathy) - 候選變異多模態特徵對比表 】
🧬 目標基因 : DNM1 | 🎯 目標器官 : BRAIN
===========================================================================
變異座標                   | AVI分數   | 剪接 Delta | 破壞 Motif 家族
---------------------------------------------------------------------------
chr9:128225994:G:A      | 24.7     | +0.8700    | TP63 / TP53 家族
chr9:128225900:A:G      | 18.2     | +0.4200    | TP63 / TP53 家族
chr9:128225910:C:T      | 5.4      | +0.0100    | TP63 / TP53 家族
===========================================================================
目前已經完成了 NumPy Delta 矩陣減法、Motif 破壞 與 3D 折疊,並印出了一張多變異對比表格,提取特定器官的波形、計算 NumPy Delta Score、捕捉 Motif 破壞與 3D Contact Map。
之後要開始進行數據工程——批次處理、VCF 解析與快取管線 (Day 15 – Day 18) 的實作。
但在真實的臨床與研究情境,一名病患的 VCF 基因檔案 動輒包含幾百個初篩變異。如果我們呆呆的一個個發送網路請求排隊等,不僅要等好久,還可能因為請求太頻繁被伺服器當成駭客阻擋!
接下來的核心目標是:「從單點查詢升級為批量高吞吐處理」——學習如何解析真實的 VCF 身分證總清冊、用 asyncio 非同步併發 狂飆 10 倍速度、用 指數退避 (Exponential Backoff) 避開 API 封鎖,並在第 18 天打造出一套 0.001 秒回傳的 VCF 自動化快取管線 (Milestone 3)!


 iThome鐵人賽
 看影片追技術