

Day 12 把每人每天排成一列後,另一個問題變得明顯:日期有列,不等於那天有量到每個指標。兩輪期間原有 4,909 列,補齊各人各輪的日期軸後是 4,958 天;只補出 49 天,但 rmssd 只有 1,975 天有值。若把空白直接補成前一天的值,或把沒有步數當成整天沒走路,後面的 baseline 與 AI 摘要都會建立在沒有觀測到的事實上。
我想區分四種情況:裝置沒有佩戴、資料尚未同步、佩戴了但該指標量測或計算失敗,以及依明確定義本來就不該有值。它們對「這天可不可以拿來算平均」的意義不同;但資料不一定能讓我們逐筆判定原因。今天的產出會是 wear/non-wear 的證據與候選旗標、各指標的 missingness 旗標,以及按人、按輪分組的完整度報表。無法辨認的原因保留為 unknown,不為了湊齊四類硬貼標籤。
資料使用 LifeSnaps 公開資料集的日粒度與小時粒度 CSV。
缺值至少有四個層次:時間軸上原本沒有 CSV 列、列存在但某一欄是空的、欄位有值卻不足以代表整天,以及欄位的值本身是沒有資料時填進去的預設值。例如某日步數有值,不能因此說夜間 HRV 一定有量到;同一天的 rmssd 空白,也不能從日表斷言整天沒戴。row_present 只標第一層,rmssd_present、steps_present 等逐欄旗標才標第二層。Day 12 已看到,這份資料主要是列在、值空,所以只計算缺列會嚴重低估指標缺值;小時表也一樣,有列的小時不代表有心率或步數。
第四層最容易漏,因為它讓逐欄旗標也失效。LifeSnaps 日表有些天 sedentary_minutes 恰好是 1440、其他活動分鐘都是 0,這種日子多半(1,024 天中 935 天)連步數、心率、睡眠都是空的;這比較像「沒有資料時把一整天記成久坐」,而不是量到一個人整天沒動。這種欄位的 *_present 會是 True,卻不是觀測。缺值的單位也不只一天:有人整段期間都沒有某個指標,這和某一天沒量到是不同層級的原因,應該分開計算。
「沒戴、同步失敗、量測失敗、原本不適用」是可能的原因,不是四種可以從 NaN 直接讀出的值。沒有佩戴紀錄、裝置接觸訊號或時間戳時,連續多小時沒有心率與步數頂多是 non-wear 候選,也可能是裝置沒電、沒有同步或匯出時沒有收進來。反過來,steps = 0 是有值的零,不能和空值合併;人在睡覺或久坐也可能沒有步數。但零也要看粒度:小時表的零步多半同時有心率,像是真的沒走;日表的零步卻常和上面那種「整天久坐」的型態一起出現,比較像沒資料。
Vert 等人的 non-wear 偵測研究指出,沒戴的時段會被誤判成活動、睡眠或久坐等行為;他們用研究級腕戴加速度計,把溫度變化率加進判定,找出短到 5 分鐘的摘除。研究對象與參考標準都和 LifeSnaps 差很多,這兩張聚合 CSV 也沒有同等的接觸證據,不能照搬他們的門檻。
每個 (id, study_round, date) 保留 row_present 與逐欄的 *_present;再從小時表記錄有值小時數、出現心率或正步數的小時,作為曾有佩戴線索。日表的心率區間分鐘數加總,和小時表有心率的小時數幾乎同步變動,可能是更細的「有心率的分鐘數」;但 Fitbit 對這幾欄的定義還沒查證,先當候選證據,不當 wear time。這些都不等於全天 wear:心率出現在某個小時,不能保證睡覺時也戴著;沒有線索也不能直接寫成 non_wear = True。比較誠實的設計是把 wear_evidence、nonwear_candidate 與 missing_kind 分開,並容許 unknown。除非有佩戴、同步或量測狀態的紀錄,候選不會升級成確認;「不適用」也需要指標定義或來源狀態支持,不能因為空白就假定當晚沒有睡眠。
LifeSnaps 論文說研究團隊會監看同步,超過 48 小時未同步便提醒參與者;但釋出的日、小時 CSV 沒有每筆的同步或抵達時間。因此今天能量到的是匯出後的完整度,不能回推某天當下是否同步失敗。missing_kind 仍保留 sync_failure 這個值,但在 LifeSnaps 上一筆都不會標;用規則推論(例如「空白後面接著一段補回的資料」)也沒有真值可以驗證,只會把猜測寫成像觀測的標籤。延遲資料怎麼改寫旗標,留到帶有抵達時間的合成資料上示範。
groupby 報表要先固定分母先對每個 (id, study_round) 建好逐日日期軸,再分別數 n_calendar_days、n_rows_present、n_steps_valid、n_rmssd_valid 等欄。日值完整度是 n_valid_days / n_calendar_days;若要算小時完整度,要另以預期小時數為分母,不能把「有一個小時有心率」寫成「這一天心率完整」。小時表每天的列數不一定是 24,分母要先決定用 24 還是實際列數。小時表同鍵可能重複,也得先定義去重規則,否則 groupby 的計數會被灌高。
跨人比較時,分母又有兩種問題:全部 80 個 (id, 輪) 合計是 4,958 個日曆日;若只問曾有 rmssd 的組(46 個 (id, 輪)、43 人)在可觀測期間內有多完整,分母是 2,918 天,分子仍是 1,975 天。前者回答資料集整體覆蓋多少,後者回答有此指標的組內覆蓋多少;不能只報一個百分比而省略母體。
缺值也不一定是隨機的。統計上把缺值機制分成三種(Rubin 1976;定義依 van Buuren 2018):所有日子缺值的機率都一樣(MCAR)、只在已觀測變數分出的組內一樣(MAR),以及兩者都不成立(MNAR)。例如身體不適的日子比較常不戴,缺的正好是最該看的那幾天。MAR 和 MNAR 無法只靠觀測資料區分;而像前值填補這類簡單補值,多半連 MCAR 下都未必站得住,也會把這些資訊抹掉。報表先呈現缺口的位置和長度,再決定下游哪些視窗能算、哪些應保留 unknown。
日表沿用 Day 12 的 daily_fitbit_sema_df_unprocessed.csv,今天另外讀小時表 hourly_fitbit_sema_df_unprocessed.csv 的 bpm、steps 與四個心率區間分鐘欄,兩張表都只留兩輪期間(D-050)。日表 4,909 列補成 4,958 天、80 個 (id, 輪)、71 人。小時表兩輪內 114,572 列,其中 37,039 列(32.3%)的 bpm 與 steps 都是空的。(id, date, hour) 有 57 組重複,每組兩列、所有欄位都相同;去重後每天最多 24 列,4,910 個 (id, date) 中有 156 個不滿 24 列。
complete_daily_axis 從各組第一列補到最後一列,補出的日子 row_present = False;分組鍵有缺值就丟錯)。dedupe_hourly 在同鍵各列完全相同時留第一列,不加總;有任何一欄衝突就丟錯,因為 CSV 沒有版本或抵達時間可以判斷哪列正確。hourly_evidence 每天數出有 bpm 的小時、正步數的小時,以及 bpm 或 steps 非空的小時(含零步)。missingness_flags 輸出逐欄 *_present、fill_value(sedentary_minutes == 1440 且其他活動分鐘是 0 或空值),以及三個判定欄:
wear_evidence:有 bpm、正步數或心率區間分鐘 > 0 為 True;有資料但沒有正線索為 False;小時表只有空列或沒有這一天為 。nonwear_candidate:填值日、沒有正線索,而且五個主要指標(steps、resting_hr、minutesAsleep、rmssd、bpm)都沒有觀測時為 True。這是日層級的候選,沒有看連續幾小時沒有線索。{col}_missing_kind:有觀測(值非空,且不是填值日的 0 步)時為 ,否則是 no_row、fill_value(只用在填值日的 0 步)或 unknown。completeness_report 按 (id, study_round) 數有觀測的天數,pooled_completeness 並列兩種分母;狀態圖每組一列、每天一格。wear_evidence 的核心是三態,預設值是 ,不是 False:
hr_zone_minutes = daily[list(HR_ZONE_COLUMNS)].sum(axis=1, min_count=1)  # 四欄全空 → NaN,不是 0

positive = out["n_hours_evidence"].gt(0).fillna(False) | out["hr_zone_minutes"].gt(0).fillna(False)
observed = out["n_hours_valued"].gt(0).fillna(False) | out["hr_zone_minutes"].notna()
out["wear_evidence"] = pd.Series(pd.NA, index=out.index, dtype="boolean")
out.loc[observed, "wear_evidence"] = False
out.loc[positive, "wear_evidence"] = True
兩個容易寫錯的地方:sum 預設把全空加成 0,等於替空白編了「0 分鐘有心率」,要加 min_count=1;「有資料」若寫成「小時表有這一天的列」,1,088 個小時列全空的日子會被標成 False,但它們其實和沒有列一樣是不知道(D-055)。
| 原本以為 | 實際發現 |
|---|---|
| 欄位有值就代表有觀測 | 1,024 天 sedentary_minutes 是 1440 分鐘、其他活動分鐘都是 0;其中 935 天五個主要指標全空,86 天仍有心率。steps 有 43 天在填值日有值,40 天是 0 步。 |
| 日表判斷不了佩戴 | 心率區間分鐘加總和同日有心率的小時數 r = 0.987(3,786 天),加總中位數 1,377 分鐘。可當「有心率的分鐘數」的候選證據。 |
| 缺值都是「某天沒量到」 | 28 人整段都沒有 rmssd。有 rmssd 的組裡,943 個缺值天有 77%(726)連睡眠紀錄都沒有,但 63%(597)當天有佩戴線索。 |
| 0 步是真的零 | 小時表 16,907 個零步小時,99.1% 同時有心率;日表的 54 個 0 步中,40 個落在填值日。 |
| Vert 2022 是為了避免把久坐、睡眠當成沒戴 | 摘要講的是沒戴被誤判成行為;它的貢獻是把溫度變化率加進判定。 |
| 以為小時表有列、卻沒有正線索,就能明確標成「沒有佩戴線索」。 | 原規則把 1,091 天標成 wear_evidence = False;排除只有空值的小時列後,只剩 3 天是 False,1,088 天改為 。有列不等於有資料。 |
以為 nonwear_candidate 就是填值日中五個主要指標全空的日子。 |
候選有 938 天,比五欄全空的 935 天多 3 天:那 3 天日表只有 0 步,小時表也只有一小時零步。它們仍只是候選,不能證明沒戴。 |
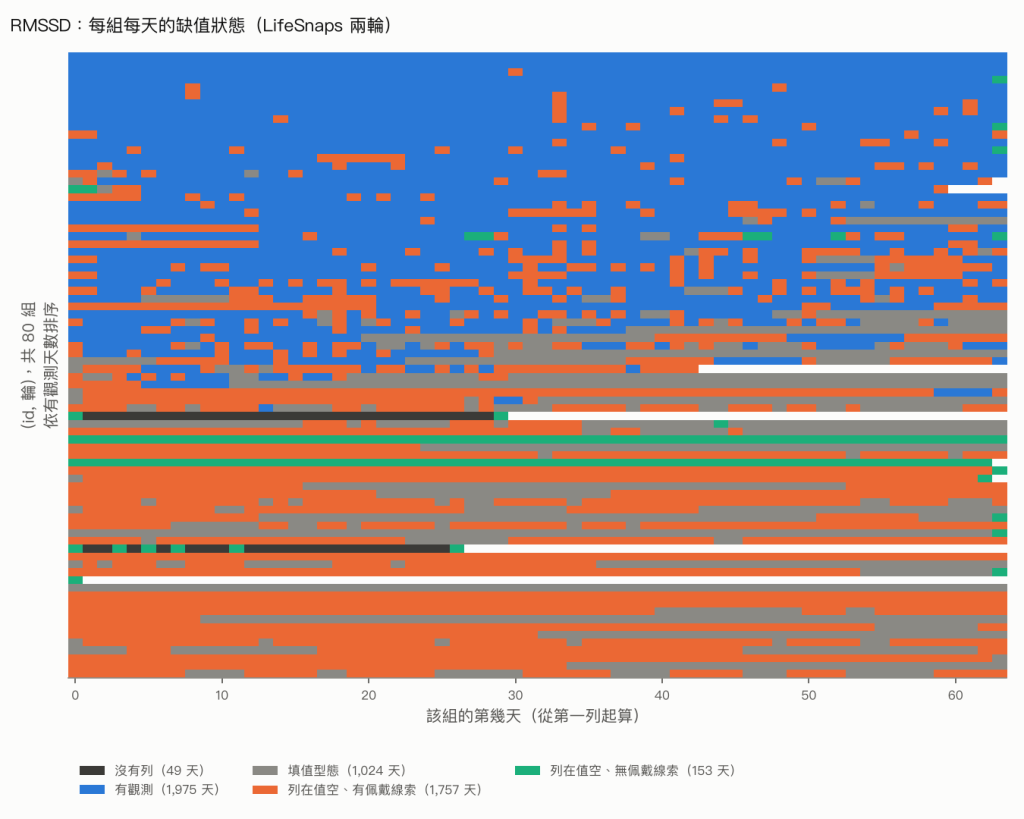
LifeSnaps 兩輪的 80 個 (id, 輪),每列一組、每格一天,顏色是當天 RMSSD 的狀態。組依有觀測的天數由多到少排列;橫軸是該組從第一列起算的第幾天,不同輪的日期不對齊;組結束後留白
rmssd 在 4,958 天的狀態分布:
| 狀態 | 天數 | 占 4,958 |
|---|---|---|
| 沒有列 | 49 | 1.0% |
| 有觀測 | 1,975 | 39.8% |
| 填值型態 | 1,024 | 20.7% |
| 列在值空、有佩戴線索 | 1,757 | 35.4% |
| 列在值空、無佩戴線索 | 153 | 3.1% |
狀態依表中順序判定,填值日一律歸「填值型態」:其中 86 天其實有佩戴線索,938 天沒有。所以有列卻沒有正線索的日子共 1,091 天,不只 153 天。
完整度報表的兩種分母:
| 欄 | 有觀測 | 占全部 4,958 天 | 有該欄的組 | 這些組的日曆日 | 占這些組 | 各組中位數 |
|---|---|---|---|---|---|---|
steps |
3,721 | 75.1% | 72 組、68 人 | 4,581 | 81.2% | 94.4% |
resting_hr |
3,498 | 70.6% | 72 組、68 人 | 4,581 | 76.4% | 90.6% |
minutesAsleep |
2,879 | 58.1% | 70 組、66 人 | 4,453 | 64.7% | 75.0% |
rmssd |
1,975 | 39.8% | 46 組、43 人 | 2,918 | 67.7% | 73.4% |
bpm |
3,789 | 76.4% | 73 組、69 人 | 4,645 | 81.6% | 95.2% |
steps 的 3,721 比 Day 12 的非空列數少 40,就是填值日的 0 步。
sedentary_minutes = 1440 且其他活動分鐘為 0 或空值,只是可疑型態;CSV 沒有欄位證明這 1,024 天全是系統填補。其中 86 天仍有心率,因此不能把整天或所有同日指標一併判成無效。本篇只把符合型態的 40 個日表零步值排除;這條規則可能漏掉其他填值,也可能誤傷真正的零步。wear_evidence = True 只表示當天曾有心率或正步數等線索,不能推成全天佩戴;nonwear_candidate = True 也不能確認沒戴。心率區間分鐘數與同一資料集裡有心率的小時數高度相關(r = 0.987),但 Fitbit 對區間分鐘的定義尚未查證,這兩張 CSV 也沒有佩戴日誌可驗證。去重後仍有 156 天的小時列不滿 24;本篇未定義有效小時的分母,也沒有量出部分天的實際佩戴時長。sync_failure 不標,其他無法辨認的缺值保留 unknown(D-054)。這份靜態資料不能回答當時是沒戴、沒同步,還是裝置沒有產生該指標;資料延遲留待 Day 14 的合成情境示範。rmssd 排除了整段無值的組,67.7% 不能當作全體覆蓋率。本篇沒有檢定缺值屬於 MCAR、MAR 或 MNAR;只靠這些觀測資料也無法區分 MAR 與 MNAR。把日表直接交給 LLM,它會看到 1,024 天「sedentary_minutes 1440、活動 0 分鐘」,很合理地寫出「你這天整天坐著」。欄位有值、型態正確,schema 驗證會通過,錯在把一個很可能是填值的數字當成觀測。這不能指望模型在生成時自己發現,得在前處理標成 fill_value,讓標記跟著數值往下傳。
空白也要有型別。rmssd 空白的 2,983 天裡,1,843 天有佩戴線索,1,091 天有日表列卻沒有任何正線索,49 天連列都沒有。三種都送成 null,模型只能猜,或乾脆只看有值的日子寫摘要。Day 19 的 feature contract 裡,每個指標至少要帶 missing_kind、日層級的 fill_value、三態的 wear_evidence、有效天數與分母,unknown 是合法值而不是錯誤。
分母也是 context。「資料集 39.8% 的日子有 rmssd」和「有此指標的組 67.7% 的日子有值」都對,回答的問題不同;不帶分母的百分比,模型分不出是哪一種。


 iThome鐵人賽
 看影片追技術