
前面幾天都在拆「看現況」:AGENTS.md(Day8)、Skills(Day10)。今天換到迴圈的另一站——動手做。
模型自己不會執行任何東西,它只能說「我要用某個工具、參數是這些」。真正做事的是 harness 提供的那組工具。所以工具集決定了 agent 的行動空間:它能做什麼、做不到什麼、以及做一件事要繞多少路。
Pi 的內建工具一共有八個:read、bash、powershell(僅 Windows)、edit、write、grep、find、ls。但預設只開四個:
// dist/core/system-prompt.js
const tools = selectedTools || ["read", "bash", "edit", "write"];
grep、find、ls 預設是關的。這件事我在 Day7 第一次實跑時才發現,它也直接改寫了 Day13 的題目——原本要問「拿掉搜尋工具會怎樣」,實際上要問的是「加上它們有沒有差」。
每個工具在原始碼裡都帶著兩段給模型看的文字:一行 snippet(出現在 system prompt 的工具清單),還有若干 guidelines(出現在 Guidelines 區)。
| 工具 | snippet | guideline |
|---|---|---|
read |
Read file contents | Use read to examine files instead of cat or sed. |
bash |
Execute bash commands (ls, grep, find, etc.) | 可以查 PI_* 環境變數取得目前模型與 session 資訊 |
edit |
Make precise file edits with exact text replacement, including multiple disjoint edits in one call | oldText 必須完全相符;多處修改請用一次呼叫 |
write |
Create or overwrite files | Use write only for new files or complete rewrites. |
這裡有個設計細節值得學:工具清單是動態組出來的,只有「呼叫端有提供 snippet」的工具才會出現在 system prompt 裡。Guidelines 也一樣,會依照當下開了哪些工具調整。沒開的工具,模型連知道都不知道。
先看一下這四個工具實際上怎麼被用。下面是第一輪校準裡,每個任務平均用掉的工具呼叫次數:
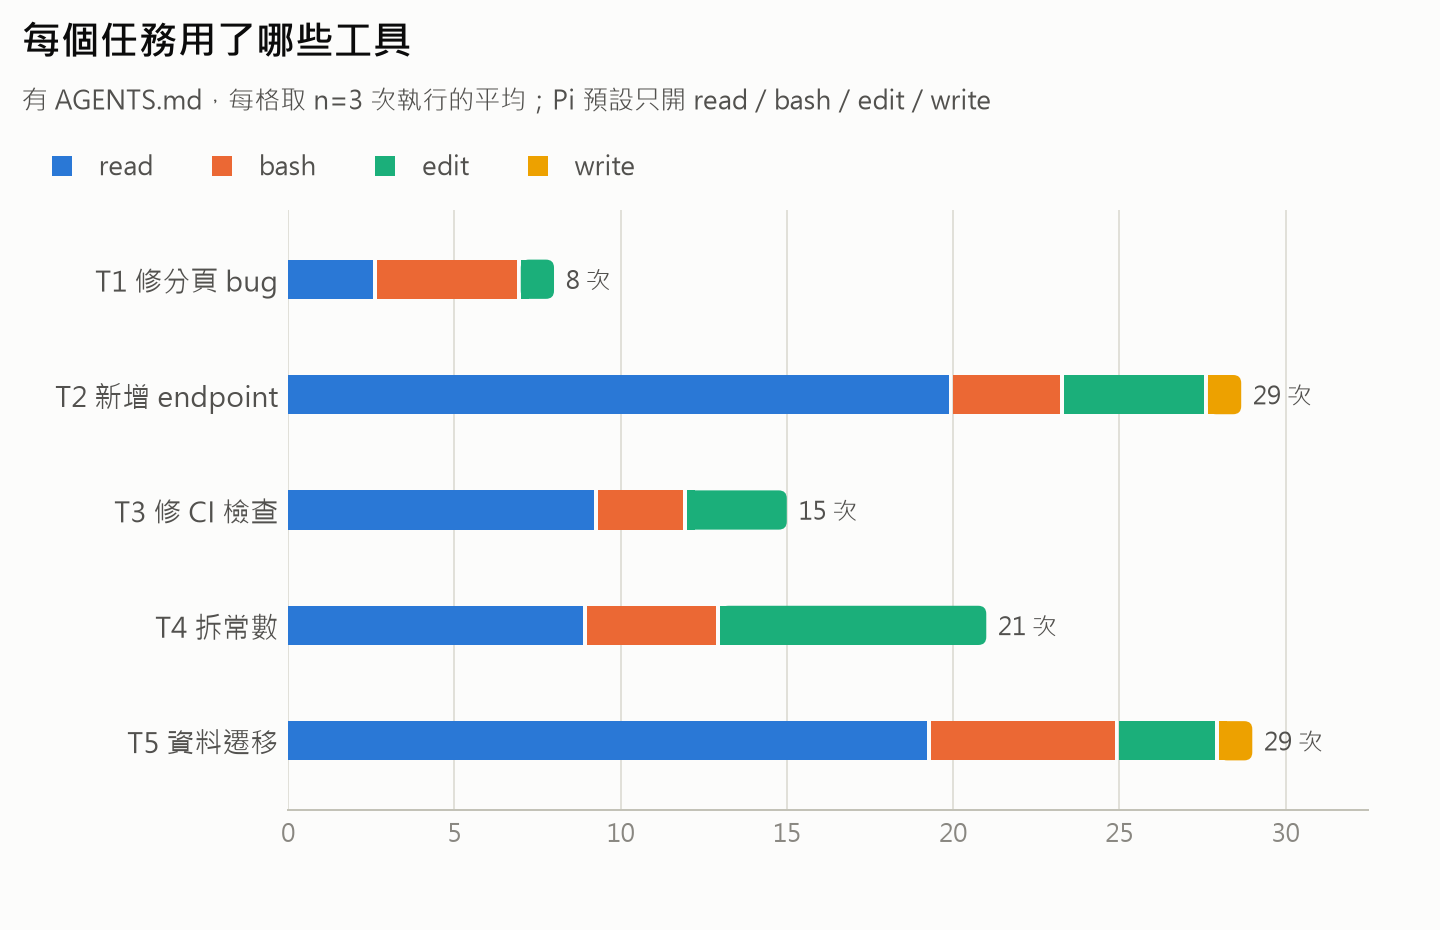
| 任務 | read | bash | edit | write | 合計 |
|---|---|---|---|---|---|
| T1 修分頁 bug | 2.7 | 4.3 | 1.0 | 0.0 | 8.0 |
| T2 新增 endpoint | 20.0 | 3.3 | 4.3 | 1.0 | 28.7 |
| T3 修 CI 檢查 | 9.3 | 2.7 | 3.0 | 0.0 | 15.0 |
| T4 拆常數 | 9.0 | 4.0 | 8.0 | 0.0 | 21.0 |
| T5 資料遷移 | 19.3 | 5.7 | 3.0 | 1.0 | 29.0 |
除了最短的 T1 以外,read 在每個任務都是最大宗——agent 大部分時間在讀,不在寫。T4 是例外中的例外:因為要改六個檔案,edit 的次數幾乎追上 read。write 全部加起來只有兩次,正好對應它的 guideline:只用在新檔案。
read 除了路徑,還接受 offset 和 limit 兩個參數,可以只讀某個行數範圍。回傳內容有上限:2000 行或 50KB,超過會被截斷並標示出來。
這解釋了 Day6 那份 session 的一個細節:模型讀 models_generated.py 時帶了 offset: 1, limit: 180——它在控制自己的 context 用量。
為什麼要專門做一個 read,而不是叫模型用 bash 跑 cat?因為工具結果會進 context,harness 需要能控制進來多少。cat 一個一萬行的檔案,整包都會塞進去;read 則會截斷、會標示、會告訴模型「還有更多」。
bash 的 schema 只有兩個參數:command,以及選填的 timeout。原始碼註解寫得很直白:「Timeout in seconds (optional, no default timeout)」——不指定就沒有逾時。
這是一個很重要的 harness 行為。如果模型跑了一個會卡住的指令又沒設逾時,這個 agent loop 就停在那裡了。實務上模型通常會自己帶 timeout(我們的實驗記錄裡,Pi 跑 pytest 和 check.py 時都帶了 timeout: 120),但這是模型的習慣,不是 harness 的保證。
指令的輸出同樣受 2000 行/50KB 限制,結束時會附上 exit code。Day6 看到的 Command exited with code 1 就是這樣來的——而且這種「指令失敗」會被標記成 isError: true 回傳給模型,讓它知道剛剛那步沒成功。
edit 是四個工具裡設計最講究的。它接受一個 edits[] 陣列,每一筆有 oldText 和 newText。規則寫在 schema 的 description 裡,模型看得到:
Exact text for one targeted replacement. It must be unique in the original file and must not overlap with any other edits[].oldText in the same call.
Each edit is matched against the original file, not incrementally.
兩個關鍵限制:
oldText 必須在檔案裡唯一。 不唯一就沒辦法確定要改哪一處。還有一條 guideline 是講效率的:「oldText 在唯一的前提下越短越好,不要填一大段沒改到的內容。」因為 oldText 和 newText 都是模型輸出的 token,填越多付越多。
在我們的實驗記錄裡看得到模型確實照著做:某一輪它同時改了四個檔案,其中兩個檔案各自包含兩處修改,回傳是 Successfully replaced 2 block(s)——一次呼叫、多處修改,而不是拆成四次。
write 最單純:建立或覆寫檔案,父目錄不存在會自動建立。它的 guideline 只有一句——「只用在新檔案或整份重寫」。
這句話其實是在防一種浪費:模型如果用 write 去改一個五百行的檔案裡的一行,它得把整整五百行重新輸出一次。Day14 會看到,這種「輸出 token」在成本裡的比重比想像中高。
把這四個工具擺在一起看,會發現它們其實在回答同一個問題:怎麼讓模型用最少的 token 完成一次動作。
read 有 offset/limit 和截斷 → 控制「進來」的量edit 要求最小唯一片段、可一次多處 → 控制「出去」的量write 被明確限制用途 → 避免整檔重寫bash 什麼都能做,但輸出一樣被截斷工具不只是「能力」,它同時是成本控制的介面。這也是為什麼「加一個工具」不見得總是好事——多一個工具就多一段 schema 常駐在每一次請求裡。
Day13 量這件事:把 grep、find、ls 這三個預設關閉的搜尋工具打開,對一個需要跨檔案搜尋的任務有沒有幫助。我已經先偷看到一個現象——關著的時候,agent 會直接用 bash 跑 rg 和 find 繞過去,所以真正要量的其實是「繞路要付多少代價」。


 iThome鐵人賽
 看影片追技術