
ES2023 的 toSorted()、toReversed()、toSpliced()、with() 讓常見 Array 操作能回傳新 Array,避免不小心修改仍被其他流程使用的原資料;而新舊版本共用沒改的部分(結構共享),讓「哪裡變了」可以用 === 快速判斷。
前置知識:會使用 Array 的 sort()、reverse()、splice() 與 index assignment;理解 reference 與淺拷貝更好。
學習路線:從 Day 20–22 的資料模型與集合操作,走到「如何安全產生資料集合的新版本」,並看懂新舊版本之間到底共用了什麼。
標籤:ES2023 Array Immutability Change Array by Copy State Update
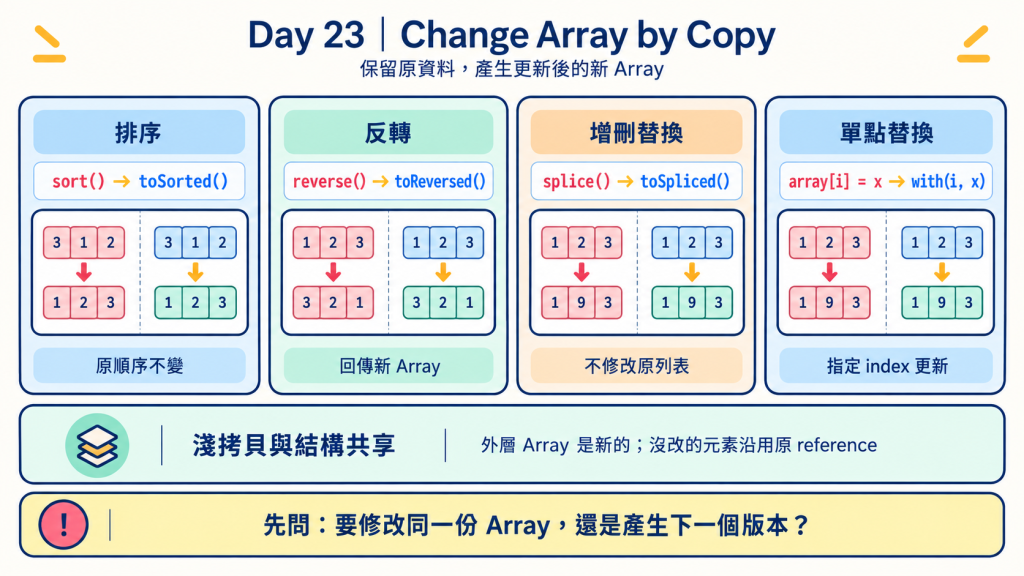
toSorted()、toReversed()、toSpliced()、with() 產生新 Array,同時保留原資料。=== 判斷新 Array 哪一層是新的,說明為什麼它只是淺拷貝。假設畫面同時需要兩種順序:
很自然會寫:
const users = [
  { id: 1, name: 'Rafael', score: 80 },
  { id: 2, name: 'Mina', score: 90 },
  { id: 3, name: 'Ivy', score: 70 },
];

const ranking = users.sort(
  (a, b) => b.score - a.score,
);

console.log(ranking.map((user) => user.name));
// ['Mina', 'Rafael', 'Ivy']

console.log(users.map((user) => user.name));
// ['Mina', 'Rafael', 'Ivy']
排行榜是對的,但 users 也被排序了。
問題不在 sort() 壞掉;sort() 的設計本來就是:
直接改變呼叫它的 Array,再回傳同一個 Array。
ranking === users;
// true
如果我們真正想表達的是:
請給我一份排序後的結果,但保留原本順序。
那 sort() 的意圖就不完全合適。
這是前端 state、selector、快取資料與 function 參數裡很常見的 bug:某段程式只是想「推導一份新資料」,卻在無意間改掉仍被其他地方共用的原資料。
先看兩種寫法:
const items = ['A', 'B', 'C'];

items.reverse();

console.log(items);
// ['C', 'B', 'A']
這是在說:
請把這一份 Array 本身反轉。
但有時候想說的是:
const items = ['A', 'B', 'C'];

const reversed = items.toReversed();

console.log(reversed);
// ['C', 'B', 'A']

console.log(items);
// ['A', 'B', 'C']
這是在說:
請根據這份 Array 產生反轉後的新版本。
兩種需求都合理:
| 意圖 | 適合的寫法 |
|---|---|
| 我就是要修改目前這份 Array | sort()、reverse()、splice()、index assignment |
| 我想保留原資料,產生更新後的版本 | toSorted()、toReversed()、toSpliced()、with() |
ES2023 的重點不是讓 Array 變成不可變資料結構。
它只是替「修改後回傳新版本」這個意圖,補上一組一致的標準 API。
在 ES2023 以前,要避免 sort() 改到原陣列,通常先複製:
const ranking = [...users].sort(
  (a, b) => b.score - a.score,
);
反轉也是:
const reversed = [...items].reverse();
這些寫法沒有錯,但有幾個問題。
第一,意圖被拆成兩步:先複製,再修改複本,讓 code review 讀程式的人需要自己推論:
喔,這裡先 spread,是因為作者不想改到原 Array。
第二,splice() 沒有那麼好處理。
假設想把第 2 個待辦事項換成新內容:
const todos = [
  { id: 1, text: '寫文章' },
  { id: 2, text: '整理筆記' },
  { id: 3, text: '回覆訊息' },
];
splice() 會直接修改:
const copy = [...todos];

copy.splice(1, 1, {
  id: 2,
  text: '整理 Day 23',
});
要嘛先建立暫存變數,要嘛改用 slice()、spread 與 concat() 組合。
第三,指定位置替換根本沒有一致的「copy 版」:
todos[1] = updatedTodo;
這行很直覺,但它直接改了原 Array。
整理一下,以前每一種需求都要自己拼湊:
| 需求 | ES2023 以前的寫法 | 問題 |
|---|---|---|
| 排序但保留原順序 | [...arr].sort() |
意圖拆成「先複製、再修改」兩步 |
| 反轉但保留原順序 | [...arr].reverse() |
同上 |
| 插入/刪除/替換一段 | 先複製再 splice(),或 slice() + concat() 組合 |
要暫存變數,寫法不一致 |
| 替換單一位置 | arr[i] = x |
沒有 copy 版,直接改到原 Array |
ES2023 把這些零散需求整理成一個家族:Change Array by Copy。名字的意思很直接:
改變 Array 的結果,但把改變放在一份新 copy 上。
TC39 的提案也將這四個方法定義成:保留原 Array,回傳改動後的新 Array。TC39:Change Array by Copy
| 會直接修改 | 回傳新 Array | 用途 |
|---|---|---|
sort() |
toSorted() |
排序 |
reverse() |
toReversed() |
反轉順序 |
splice() |
toSpliced() |
插入、刪除、替換一段元素 |
array[index] = value |
with(index, value) |
替換單一位置 |
這張表就是文章最重要的記憶點。
不要把它背成四個新 API;把它看成同一個問題的四個版本:
我想改變結果,但不想改變目前持有的 Array。
toSorted():排序後回傳新版本const users = [
{ id: 1, name: 'Rafael', score: 80 },
{ id: 2, name: 'Mina', score: 90 },
{ id: 3, name: 'Ivy', score: 70 },
];
const ranking = users.toSorted(
(a, b) => b.score - a.score,
);
console.log(ranking.map((user) => user.name));
// ['Mina', 'Rafael', 'Ivy']
console.log(users.map((user) => user.name));
// ['Rafael', 'Mina', 'Ivy']
和 sort() 一樣,toSorted() 接收 compare function;差別只在於它不會改動 receiver。
ranking === users;
// false
toSorted() 只改變「會不會動到原 Array」,排序規則和 sort() 完全一樣。所以 sort() 最常見的坑,toSorted() 也一樣會踩到:
const scores = [10, 1, 2];

scores.toSorted();
// [1, 10, 2]  ← 不是 [1, 2, 10]
沒傳比較函式時,兩者都會先把每個值轉成字串,再一個字元一個字元比。'10' 和 '2' 比第一個字元,'1' 比 '2' 小,所以 10 排在 2 前面。
把兩個方法放在一起比較(每一列都從 [10, 1, 2] 開始):
| 寫法 | 結果 | 原 Array |
|---|---|---|
sort() |
[1, 10, 2] |
被改掉 |
toSorted() |
[1, 10, 2] |
不變 |
sort((a, b) => a - b) |
[1, 2, 10] |
被改掉 |
toSorted((a, b) => a - b) |
[1, 2, 10] |
不變 |
排序結果只由「有沒有傳比較函式」決定;會不會改到原 Array,才由選 sort() 還是 toSorted() 決定。
常用的比較函式:
| 需求 | 比較函式 |
|---|---|
| 數字由小到大 | (a, b) => a - b |
| 數字由大到小 | (a, b) => b - a |
| 依物件的數字欄位 | (a, b) => a.score - b.score |
| 文字依一般字典順序 | (a, b) => a.localeCompare(b) |
最後一列是因為字串的預設排序也不一定符合直覺:它比的是字元編碼,所以大寫會排在小寫前面,['apple', 'Banana'].toSorted() 會得到 ['Banana', 'apple']。
另外,兩者都是穩定排序:比較結果相同的元素,會保持原本的先後順序。例如依分數排序時,同分的人仍照原本的順序排列。
toReversed():反轉後回傳新版本const newestFirst = ['第一篇', '第二篇', '第三篇'];
const oldestFirst = newestFirst.toReversed();
console.log(oldestFirst);
// ['第三篇', '第二篇', '第一篇']
console.log(newestFirst);
// ['第一篇', '第二篇', '第三篇']
和這種舊寫法相比:
const oldestFirst = [...newestFirst].reverse();
toReversed() 更直接表達:
我要的是反轉後的新 Array,不是要改動原 Array。
toSpliced():不碰原資料地插入、刪除或替換toSpliced() 的參數和 splice() 完全一樣:
array.toSpliced(start, deleteCount, ...items);
// 從 start 開始,刪掉 deleteCount 個,再插入 items
差別在回傳值和原 Array:
const tags = ['JavaScript', 'Vue', 'CSS'];

tags.toSpliced(1, 1, 'TypeScript');
// ['JavaScript', 'TypeScript', 'CSS']  ← 回傳新 Array

console.log(tags);
// ['JavaScript', 'Vue', 'CSS']         ← 原 Array 不變
splice(1, 1, 'TypeScript') |
toSpliced(1, 1, 'TypeScript') |
|
|---|---|---|
| 回傳值 | 被刪掉的元素:['Vue'] |
更新後的新 Array |
| 原 Array | 被改掉 | 不變 |
回傳值這一列要特別注意:習慣 splice() 的人,常以為它回傳的是更新後的陣列。
只要調整 deleteCount 和 items,就能做插入、刪除、替換三種更新(都從 ['JavaScript', 'Vue', 'CSS'] 開始):
| 想做什麼 | 寫法 | 結果 |
|---|---|---|
| 插入 | tags.toSpliced(1, 0, 'TypeScript') |
['JavaScript', 'TypeScript', 'Vue', 'CSS'] |
| 刪除 | tags.toSpliced(1, 1) |
['JavaScript', 'CSS'] |
| 替換 | tags.toSpliced(1, 1, 'TypeScript') |
['JavaScript', 'TypeScript', 'CSS'] |
with():只替換一個位置with() 對應的是最容易被忽略的一種更新:
items[index] = value;
例如使用者編輯了列表中的一筆 todo:
const todos = [
  { id: 1, text: '寫文章', done: false },
  { id: 2, text: '整理筆記', done: false },
  { id: 3, text: '回覆訊息', done: false },
];

const updatedTodo = {
  ...todos[1],
  done: true,
};

const nextTodos = todos.with(1, updatedTodo);

console.log(nextTodos);
// 第一筆與第三筆維持原樣,第二筆換成 updatedTodo

console.log(todos[1].done);
// false
with() 的語意不是「更新 object 的某個欄位」,而是:
建立新 Array,並以指定 value 取代指定 index 的元素。
所以更新 object 本身時,仍要先建立新 object:
const nextTodos = todos.with(1, {
  ...todos[1],
  done: true,
});
這個區分很重要,第四、五節會再回到它。
前面說參數意義和舊方法相同,但規範在細節上刻意做了幾個不同的選擇。從舊寫法換成新方法時,這兩點最可能讓你意外。
1. with() 支援負數 index,超出範圍會報錯
const steps = ['填寫資料', '確認資料', '完成'];

steps.with(-1, '已完成');
// ['填寫資料', '確認資料', '已完成']  ← -1 代表最後一個,和 at(-1) 一樣

steps.with(3, '額外步驟');
// RangeError
對照 index assignment:
const copied = steps.slice();
copied[5] = '額外步驟';

console.log(copied);
// ['填寫資料', '確認資料', '完成', <2 empty items>, '額外步驟']
// ← 不報錯,還多出兩個空位
with() 的意思是「替換既有的位置」,不是「把陣列加長」。要新增元素,請用 toSpliced() 或 spread。
2. 稀疏陣列的空位會變成 undefined
const sparse = [1, , 3]; // 中間是空位(empty slot)

sparse.slice().reverse();
// [3, <1 empty item>, 1]  ← 舊方法保留空位

sparse.toReversed();
// [3, undefined, 1]       ← 新方法把空位讀成 undefined
copy methods 會逐格讀取每個位置,讀不到值的就是 undefined,所以回傳的 Array 一定沒有空位。toSorted() 也一樣。
日常資料很少出現稀疏陣列,但要知道一個連鎖影響:forEach()、map() 會跳過空位,卻不會跳過 undefined。
let count = 0;
sparse.forEach(() => count++);              // count 是 2

count = 0;
sparse.toReversed().forEach(() => count++); // count 是 3
先看:
const users = [
  { id: 1, profile: { name: 'Rafael' } },
  { id: 2, profile: { name: 'Mina' } },
];

const copied = users.toReversed();

copied === users;
// false

copied[0] === users[1];
// true
toReversed() 建立了新的外層 Array,但 Array 裡面放的仍是同一批 object reference。
因此:
copied[0].profile.name = 'Mina Chen';

console.log(users[1].profile.name);
// 'Mina Chen'
這不是 toReversed() 失效,而是 JavaScript Array copy 的正常語意:
| 檢查 | 結果 | 代表 |
|---|---|---|
copied === users |
false |
外層 Array 是新的 |
copied[0] === users[1] |
true |
裡面的 user object 還是同一個 |
對 primitive 來說不容易感覺到:
const numbers = [1, 2, 3];
const reversed = numbers.toReversed();
但對 object、Array、Map、Set、Date 等 reference value,就要特別小心。
判斷 copy 到哪一層,最簡單的方法就是用 === 看「這一層是不是新的」。Array copy methods 的答案是:外層是新的,元素是共用的。
這看起來像陷阱,但下一節會看到,它其實是刻意的設計。
上一節把淺拷貝說成要小心的地方。但換個角度問:前端為什麼這麼在意「產生新版本」,而不是直接改?
答案是為了回答一個畫面更新時一定會問的問題:
資料更新之後,到底哪裡變了?
回到第三節的 todo 列表:使用者把第二筆標成完成。
const todos = [
  { id: 1, text: '寫文章', done: false },
  { id: 2, text: '整理筆記', done: false },
  { id: 3, text: '回覆訊息', done: false },
];
做法一:直接修改
const prev = todos;
todos[1].done = true;
做法二:整份深拷貝再改(structuredClone() 會把巢狀資料全部複製一份)
const next = structuredClone(todos);
next[1].done = true;
做法三:用 with() 沿著修改路徑複製
const next = todos.with(1, { ...todos[1], done: true });
用 === 比較新舊版本,三種做法的結果完全不同:
| 做法 | 整個列表 next === prev |
沒改的第一筆 next[0] === prev[0] |
改了的第二筆 next[1] === prev[1] |
|---|---|---|---|
| 一、直接修改 | true |
true |
true |
| 二、整份深拷貝 | false |
false |
false |
三、with() 沿路徑複製 |
false |
true |
false |
只有做法三,=== 的答案和「實際上哪裡變了」完全一致。
=== 這麼重要?因為 === 比較 reference 幾乎不花時間,不管 object 裡面有多少欄位。只要規則是「有改就換新 reference,沒改就沿用」,就能用 === 快速找出變化,不必逐欄位比對內容。
用一個很簡單的函式模擬「沒變就略過」:
function renderRow(todo, prevTodo) {
  return todo === prevTodo ? '略過' : '重新計算';
}
| 做法 | 三筆資料的結果 | 問題 |
|---|---|---|
| 一、直接修改 | 無法比較 | prev 和 todos 是同一個 Array,舊版本已經被覆蓋,沒東西可以比 |
| 二、整份深拷貝 | 重新計算、重新計算、重新計算 | 沒改的也換了新 reference,全部被當成有變 |
三、with() 沿路徑複製 |
略過、重新計算、略過 | 只重算真正改變的那一筆 |
這個做法有個名字:結構共享(structural sharing)。新版本只替換修改路徑上的節點,其他部分和舊版本共用:
| 位置 | 是不是新的 reference | 原因 |
|---|---|---|
| 外層 Array | 是 | with() 回傳新 Array |
| 第二筆 todo | 是 | 用 spread 建立了新 object |
| 第一、三筆 todo | 否 | 沒改,直接沿用 |
改得更深時,規則也一樣,只是路徑變長:
const users = [
  { id: 1, profile: { name: 'Rafael' } },
  { id: 2, profile: { name: 'Mina' } },
];

const nextUsers = users.with(1, {
  ...users[1],
  profile: {
    ...users[1].profile,
    name: 'Mina Chen',
  },
});
| 位置 | 是不是新的 reference |
|---|---|
| 外層 Array | 是 |
| 第二個 user | 是 |
第二個 user 的 profile |
是 |
| 第一個 user | 否,沿用 |
一句話:框架用「reference 有沒有換」判斷哪裡要更新,所以你怎麼複製資料,就決定了框架看到什麼變化。
| 做法 | 框架看到的 | 結果 |
|---|---|---|
| 直接修改 | reference 沒換,以為沒變 | 畫面不更新(漏更新) |
| 整份深拷貝 | reference 全換,以為全變了 | 全部重算(白做工) |
| 沿路徑局部複製 | 只有改到的地方換了 reference | 只更新真正改變的部分 |
例如 React 的 setState 和 memo 用 Object.is() 比較新舊值,Redux 的 useSelector 預設用 ===,相同就略過重新渲染。寫法不同,本質都是在比 reference。
上一篇看過,
===、SameValueZero、Object.is()只在NaN和+0/-0上結果會有些微不同;比較 object 時,三者都只看是不是同一個 reference。所以前面用===做的實驗,換成Object.is()結果也一樣。
不同框架偵測變化的方式不一樣,例如 Vue 用 Proxy 追蹤修改,直接改也能被偵測到。但只要是靠 reference 判斷的地方,例如 memo 或快取,這套規則都成立。
Array copy methods 只複製外層,不是「不夠深」,而是剛好只換掉需要換的那一層。這也是為什麼每次更新資料如果都整份深拷貝,也並不是最好選擇。
打開 TC39 的 ECMAScript 規格,這四個方法的步驟寫得很長,但拆開來看,其實都只做三件事:
原陣列從頭到尾只被「讀」,沒有被「寫」,所以不會被改到。前面看到的幾個現象,也都能用這三件事解釋:
| 你看到的現象 | 規格裡的原因 |
|---|---|
| 原陣列不會被改 | 結果寫在新建立的 Array,原陣列只被讀取 |
| 新 Array 是淺拷貝(第四節) | 放進新 Array 的是「同一個值」,object 不會被複製一份 |
空位變成 undefined(第三節) |
一格一格讀的時候,讀不到值就是 undefined |
with() 超出範圍會報錯(第三節) |
建立新 Array 之前會先檢查 index,不合法就直接報錯 |
| 結果一定是一般 Array | 規格固定建立一般 Array,就算從 Array 的子類別呼叫也一樣 |
toSpliced() 不是「搬移」,是「照順序抄寫」splice() 只有原陣列可以用,插入元素時得把後面的元素往後搬,才有空位放新東西。
toSpliced() 不用搬,因為它是在一張白紙(新 Array)上照順序抄寫,分成三段:
以 ['A', 'B', 'C', 'D'].toSpliced(1, 1, 'X', 'Y') 為例(從 index 1 開始,刪掉 1 個,插入 'X'、'Y'):
| 階段 | 做什麼 | 新 Array 變成 |
|---|---|---|
| ① 抄前段 | 照抄 start 之前的元素 |
['A'] |
| ② 寫入新元素 | 寫入 'X'、'Y' |
['A', 'X', 'Y'] |
| ③ 抄後段 | 跳過被刪掉的 'B',從 'C' 開始抄到最後 |
['A', 'X', 'Y', 'C', 'D'] |
'C' 從 index 2 變成 index 3,並不是被搬過去,而是抄寫時自然往後排。
看到新 API 後,很容易得出過度簡化的結論:是不是會更動原始資料的操作,就都不對了?
以後不要再用
sort()、reverse()、splice()?
函數式程式設計(FP)裡的 pure function 觀念,剛好能幫我們判斷什麼時候可以直接修改。
一個函式要算是 pure,需要同時符合兩個條件:
| 條件 | 白話 |
|---|---|
| 同樣的輸入,永遠得到同樣的輸出 | 結果只由參數決定,不受外面的狀態影響 |
| 沒有 side effect | 不修改函式呼叫前就已經存在的東西,例如參數、全域變數、畫面 |
第二點就是這篇的重點:修改傳進來的 Array,就是一種 side effect。
回到開頭的排行榜,把排序包成一個函式:
function getRanking(users) {
  return users.sort((a, b) => b.score - a.score);
}

const ranking = getRanking(users);

console.log(users.map((user) => user.name));
// ['Mina', 'Rafael', 'Ivy']  ← 呼叫端的 users 也被排序了
呼叫的人只是想「拿到排行榜」,卻發現自己的 users 被改掉了。這就是 side effect:函式的影響跑到了函式外面。
function getRanking(users) {
  return users.toSorted((a, b) => b.score - a.score);
}
用 sort() |
用 toSorted() |
|
|---|---|---|
| 回傳的排行榜 | 正確 | 正確 |
呼叫端的 users |
被改掉 | 不變 |
| 有沒有 side effect | 有 | 沒有 |
| 是不是 pure function | 不是 | 是 |
兩個版本回傳的結果一樣,差別只在有沒有動到外面的資料。copy methods 讓「寫出 pure function」變得很自然。
pure function 看的是「外面看不看得到」,不是「函式裡有沒有任何修改」:
function getTopScores(users) {
  const scores = users.map((user) => user.score); // 自己建立的新 Array
  scores.sort((a, b) => b - a);                    // 只改自己的,外面看不到
  return scores.slice(0, 3);
}
scores 是函式自己剛建立的,還沒交給任何人。在這裡用 sort() 原地排序,外面完全看不到,users 也沒被動到。從外面看,getTopScores() 仍然是 pure function:同樣的 users 永遠得到同樣的結果,也沒有改到任何外面的資料。
這種「只改自己剛建立的資料」的做法,叫做 local mutation。它不算 side effect,因為修改從頭到尾都留在函式裡面。
這就是「資料的擁有權」:資料是你自己建立、還沒交出去的可以掌控修改;別人交給你的,就要考慮更動後的相關副作用影響。
| 這份資料是誰的? | 建議 |
|---|---|
| 函式內部自己建立、還沒交出去 | mutation methods 可以用,外面看不到 |
| 從參數傳進來的 | 用 copy methods 回傳新結果 |
| state、props、store、cache、API response | 修改的話,需要考量很多地方可能也在共用 |
這不是某個框架的規則,而是資料是否被共用的問題。
React、Vue、Redux、Pinia、selector 或 memoization 都會讓這個問題更明顯,但即使只是一般 JavaScript function,只要同一份 Array 被多個地方持有,就可能遇到。
ES2023 的 Change Array by Copy,解決的是很常見但容易被忽略的語意落差:
| 我想要的 | 適合的方法 |
|---|---|
| 得到排序後的資料,原本的不動 | copy methods:toSorted()、toReversed()、toSpliced()、with() |
| 就地改變原本的資料 | mutation methods:sort()、reverse()、splice()、array[i] = x |
而且新舊版本之間,沒改的部分會共用 reference。這讓「哪裡變了」可以用 === 快速判斷,也是前端偏好產生新版本的真正原因。
如果只記住一句話,可以記:
當你要從既有 Array 推導畫面、state 或下一步資料時,先問自己:我需要修改同一份 Array,還是需要一份更新後的新版本?
toSorted()、toReversed()、toSpliced()、with()
useState、memo — 以 Object.is 比較新舊值,相同就略過重新渲染


 iThome鐵人賽
 看影片追技術