
從 key、相等判斷與迭代順序切入,建立 Object、Map、Set 三種資料模型的選擇準則。
前置知識:會使用 Object、Array 與基本的 Map/Set;理解 iterable 可幫助讀懂建構子行為。
學習路線:理解不同資料模型的基礎。。
標籤:ES2015 ES2024 Object Map Set Data Model
SameValueZero 比較、依插入順序迭代,以及 new Map(iterable) 的規範行為Array.find() 或建 Map 索引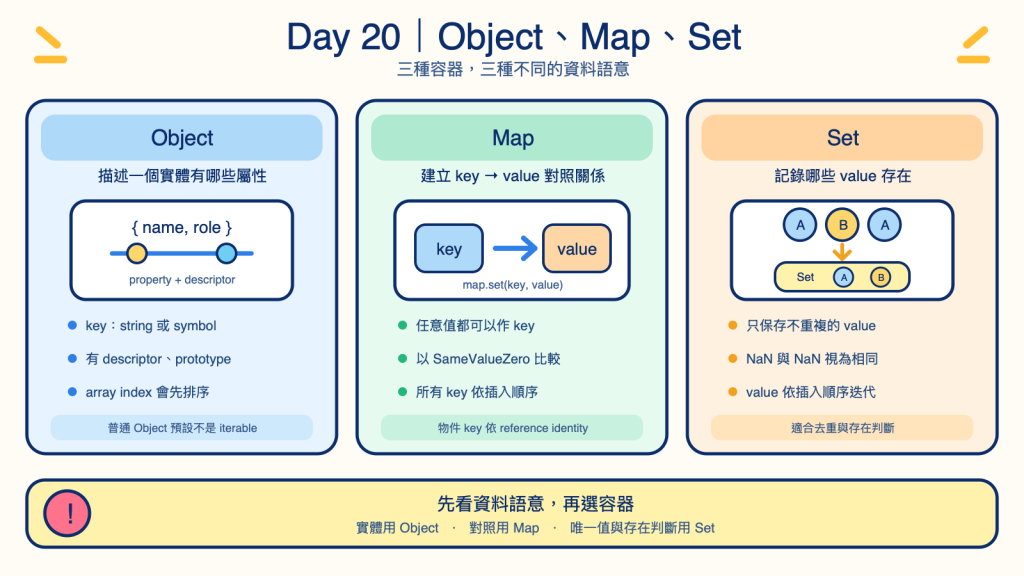
Day 19 已經把 Promise、Async Iterator 與 Stream 放回同一張非同步資料流地圖。接下來要從「資料怎麼來」,轉向「資料該怎麼存」,並為 ES2024、ES2025 的集合新 API 補上地基。
不過在踏入 Object.groupBy()、Map.groupBy() 與 Set 的新集合運等新的 JavaScript API 前,先放慢停一下:Object、Map、Set 看起來都能「存資料」,但它們其實遵守完全不同的規則。 這不只是 API 寫法不同;連 key 能放什麼、怎麼比較、怎麼迭代都有所不同,來複習看看之前被自己忽略的小細節。
在 JavaScript 的語言層級,Object、Map、Set 都是 object:
typeof {}; // "object"
typeof new Map(); // "object"
typeof new Set(); // "object"
但它們不是同一種資料模型。
| 容器 | 最核心的問題 |
|---|---|
| Object | 這個實體有哪些屬性? |
| Map | 某個 key 對應到什麼 value? |
| Set | 某個 value 是否已存在? |
例如一個使用者很適合用 Object 描述:
const user = {
  id: 1,
  name: "Rafael",
  role: "admin",
};
若要記錄每個使用者目前開啟的面板,Map 更符合問題:
const activePanelByUser = new Map();

activePanelByUser.set(user, "settings");
若只想記錄哪些使用者 id 已經讀了公告,Set 更直接:
const readUserIds = new Set([1, 3, 8]);

readUserIds.has(user.id); // true
我們常把 Object 當成字典:
const scores = {
  rafael: 100,
  amy: 90,
};
這種用途沒有問題,但 Object 的本質是「property 的集合」,每個 property 還附帶額外規則。
當你用 bracket notation {} 存取 Object 時,key 會先經過 ToPropertyKey 轉換,最終只能是 string 或 symbol。
const object = {};

object[1] = "number";
object[true] = "boolean";

console.log(object);
// { "1": "number", "true": "boolean" }
物件也一樣:
const key = { id: 1 };
const object = {};

object[key] = "資料";

console.log(object);
// { "[object Object]": "資料" }
出現這個現象不是 Object 壞掉😅,而是它本來就在做 property key 轉換。這由 TC39 的抽象操作 ToPropertyKey 在規範層級定義,步驟其實很短:
ToPropertyKey(key):
1. 先對 key 做 ToPrimitive(以 string 為 hint)
2. 若結果是 Symbol,直接當作 key
3. 否則一律 ToString,轉成字串 key
所以 object[1] 的 1 會被 ToString 成 "1";object[{ id: 1 }] 則先 ToPrimitive 呼叫物件的 toString() 得到 "[object Object]" 再當 key。「property key 只能是 string 或 symbol」不是慣例,而是這個規範步驟的直接結果。TC39:ToPropertyKey
一個 Object property 還可能有 descriptor:
const product = {};

Object.defineProperty(product, "id", {
  value: 1,
  writable: false,
  enumerable: true,
  configurable: false,
});
這組設定稱為 property descriptor(屬性描述子):
除了 資料value
Object.keys() 列出、能不能刪除;這表示 Object 天生適合描述資料欄位、getter、setter、可列舉與否等「物件屬性」。
此外,普通 Object 還有 prototype chain:
const user = { name: "Rafael" };

user.toString; // 來自 Object.prototype
所以判斷某個欄位是否真的屬於自己時,要分清楚 own property 與繼承而來的 property:
Object.hasOwn(user, "name"); // true
Object.hasOwn(user, "toString"); // false
這套「方法掛在 prototype、實例靠 prototype chain 取用」的機制,其實就是前面 Day 06 Iterator Helpers 能直接 .map()、.filter() 的原因,這些 helper 並不在每個 iterator 自己身上,而是掛在共用的 Iterator.prototype 上,靠 prototype chain 委派取用。
以前大概知道物件的 key 不會照資料插入順序,但忽略了不同key屬性之間的排列的規則:
整數型 property key 會排在一般字串 key 前面。
const data = {
  b: "B",
  10: "ten",
  2: "two",
  a: "A",
};

console.log(Object.keys(data));
// ["2", "10", "b", "a"]
普通 Object 的 own property key 順序是:
1. 整數索引型字串 key:由小到大
2. 其他 string key:依建立順序
3. symbol key:依建立順序
這個排序規則來自 OrdinaryOwnPropertyKeys,不是瀏覽器剛好這樣實作。TC39:OrdinaryOwnPropertyKeys
這個「依建立順序」是規範明訂的:
OrdinaryOwnPropertyKeys對一般字串 key 的用語是「以 property 建立的先後順序(ascending chronological order of property creation)」列舉。它要求的是可觀察的先後,並非引擎替屬性記了時間戳。
關鍵在於規範怎麼看「建立」與「刪除」:
obj.a = 3):a 這個 property 已存在,只更新它的 value,不會重新加入 property 清單,位置不變。delete obj.a):規範的 [[Delete]] 會把 a 這個 property 從物件的 property 清單整個移除。obj.a = 4):此時 a 已不存在,等於一次全新的「建立」,會被接到清單最後——於是它在列舉順序上排到現有 key 之後。所以改值不算重新建立,但 delete 後再加入會:
const obj = { a: 1, b: 2 };

obj.a = 3;        // 只改值,a 仍是原本的屬性
Object.keys(obj); // ["a", "b"]

delete obj.a;     // 移除 a
obj.a = 4;        // 重新建立 a
Object.keys(obj); // ["b", "a"]  ← a 排到 b 後面
但要注意這只適用於一般字串 key。整數索引 key 走的是「數字大小」那條規則,無論怎麼刪了再加,都仍按數字排序:
const idx = { 2: "二", 10: "十" };

delete idx["2"];
idx["2"] = "新的二";
Object.keys(idx); // ["2", "10"]  ← 整數 key 仍在前
簡單記:一般字串 key 看「這次建立的先後」,整數索引 key 看「數字大小」。
當你的資料真的需要「完全依加入順序迭代」時,Map 的語意通常更貼近需求。
Object 可以用 Object.keys()、Object.values() 或 Object.entries() 取出資料:
const user = {
  name: "Rafael",
  role: "admin",
};

console.log(Object.entries(user));
// [["name", "Rafael"], ["role", "admin"]]
要注意這三個方法抓的不是「物件上全部的 key」,而是自身、可列舉(
enumerable: true)、且 key 為字串的 property:繼承來的、被設成enumerable: false的、以及 symbol key 都不會出現。規範以抽象操作EnumerableOwnProperties定義這個篩選行為。TC39:EnumerableOwnProperties
const obj = { visible: 1 };
Object.defineProperty(obj, "hidden", {
  value: 2,
  enumerable: false, // 不可列舉
});

Object.keys(obj); // ["visible"]  ← hidden 不會出現
但這不代表普通 Object 本身支援 for...of:
for (const entry of user) {
  // TypeError: user is not iterable
}
因為普通 Object 預設沒有
[Symbol.iterator]。這裡其實有兩套容易混淆的走訪機制😅:
Object.keys()/values()/entries()、for...in,看的是 property 的 enumerable 旗標。for...of、展開運算子,看的是物件有沒有 [Symbol.iterator]。普通 Object 有可列舉的 property(所以 Object.keys() 列得出來),卻沒有 [Symbol.iterator](所以不能 for...of)——兩者是不同的規範機制。
Map 與 Set 則是 iterable:
const map = new Map([
  ["name", "Rafael"],
  ["role", "admin"],
]);

for (const [key, value] of map) {
  console.log(key, value);
}

const tags = new Set(["javascript", "es2025"]);

for (const tag of tags) {
  console.log(tag);
}
這也是三者的重要差異:Object 的 property 要先透過 Object.entries() 等 API 轉成可迭代資料;Map 與 Set 本身就是可迭代集合。
Map 解決的不是「一個物件有哪些欄位」,而是「我拿某個 key,能找到哪個 value」。
const cache = new Map();

cache.set("user:1", { name: "Rafael" });
cache.set("user:2", { name: "Amy" });

cache.get("user:1"); // { name: "Rafael" }
cache.has("user:2"); // true
cache.size; // 2
new Map(iterable):直接消費 key-value entry 的迭代來源new Map() 最常見的寫法是傳入巢狀陣列:
const map = new Map([
  ["name", "Rafael"],
  ["role", "admin"],
]);
不過這裡真正重要的不是 Array,而是 iterable。new Map(iterable) 會逐筆讀取外層 iterable,每一筆 entry 的第 0 個與第 1 個位置分別成為 key、value。
因此可以直接把 Object 的 entries 轉成 Map:
const scores = {
  rafael: 100,
  amy: 90,
};

const scoreMap = new Map(Object.entries(scores));
也可以直接消費 generator:
function* createEntries() {
  yield ["user:1", { name: "Rafael" }];
  yield ["user:2", { name: "Amy" }];
}

const users = new Map(createEntries());
概念流程是:
iterable 逐筆產生 entry
        ↓
entry[0] 作為 key
entry[1] 作為 value
        ↓
Map 依序 set(key, value)
每筆 entry 的第三個元素以後不會被 Map constructor 使用:
const map = new Map([
  ["name", "Rafael", "第三個值"],
  ["role", "admin", "也被忽略"],
]);

console.log([...map]);
// [["name", "Rafael"], ["role", "admin"]]
可以把它想成 Map 對每筆 entry 只做:
map.set(entry[0], entry[1]);
一個容易忽略的細節是:外層參數必須是 iterable;每一筆 entry 本身則必須是 object,並能取得 0、1 兩個 property。最常見的 entry 剛好是 [key, value] 陣列,但規範不是再次迭代或解構每一筆 entry。
換句話說:需要 iterable 的是外層資料來源,不是每一筆 entry。所以 entry 甚至不必是陣列,只要能讀到
"0"、"1"這兩個 property 就行:
const entry = {
  0: "name",
  1: "Rafael",
};

const map = new Map([entry]); // 外層 [entry] 是 iterable 就夠了
console.log(map.get("name")); // "Rafael"
反過來,若 entry 沒有 "0"、"1" 這兩個 property,Map 不會報錯,只會讀到 undefined:
const entry = { a: "name", b: "Rafael" };

const map = new Map([entry]);
console.log([...map]); // [[undefined, undefined]]
這修正了一個常見的錯誤心智模型:
錯誤理解:
outer iterable → entry 也要 iterable → 取前兩筆

實際流程:
outer iterable → 逐筆 entry object → Get("0") 當 key、Get("1") 當 value
TC39 將這段初始化流程抽成 AddEntriesFromIterable:它取得 iterator、逐筆拿 entry,再讀取 entry 的 "0"、"1" property 後呼叫 Map 的 set。TC39:AddEntriesFromIterable
Map 不會把 key 轉成字串:
const user = { id: 1 };
const cache = new Map();

cache.set(user, "使用者快取");

console.log(cache.get(user));
// 使用者快取
兩個內容相同但不同的物件,仍是不同 key:
const a = { id: 1 };
const b = { id: 1 };

const map = new Map();
map.set(a, "A 的資料");

console.log(map.get(b)); // undefined
這是因為 Map 對物件看的是 reference identity,不是深層內容是否相同。
SameValueZero 比較 keyMap 判斷兩個 key 是不是「同一個」時,用的是一套叫 SameValueZero 的規則。你只需要記住它跟 === 差在一個實用的地方:NaN 可以正常當 key。
用 === 時 NaN === NaN 是 false,所以若照這個規則,把 NaN 存進去就再也拿不回來;Map 讓 NaN 等於自己,因此存得進、也找得回(另外 +0 與 -0 也視為同一個 key):
const map = new Map();

map.set(NaN, "可找到");
console.log(map.get(NaN)); // "可找到"(換成 === 會是 undefined)
const map = new Map();

map.set("b", "B");
map.set(10, "ten");
map.set(2, "two");
map.set("a", "A");

console.log([...map.keys()]);
// ["b", 10, 2, "a"]
TC39 將 Map 定義為獨立的 keyed collection,使用 [[MapData]] 內部欄位描述資料;實際 engine 如何存放資料可以不同,但上述 key 與迭代行為是規範保證的。TC39:Map objects
Set 沒有 key-value pair。它只管理一組不重複的 value:
const tags = new Set([
  "javascript",
  "promise",
  "javascript",
]);

console.log(tags);
// Set(2) { "javascript", "promise" }
new Set(iterable):每一筆資料直接就是 valueSet constructor 和 Map 一樣接受 iterable:
function* createTags() {
  yield "javascript";
  yield "es2025";
  yield "javascript";
}

const tags = new Set(createTags());

console.log([...tags]);
// ["javascript", "es2025"]
但 Set 不會把每一筆資料再拆成 key、value,而是概念上直接做:
for (const value of iterable) {
  set.add(value);
}
因此字串本身也能直接建立 Set,因為字串是 iterable:
const letters = new Set("hello");

console.log([...letters]);
// ["h", "e", "l", "o"]
更有趣的是,Map 本身也是 iterable,且它每次迭代會產生 [key, value] pair:
const map = new Map([
  ["name", "Rafael"],
  ["role", "admin"],
]);

const pairs = new Set(map);

console.log([...pairs]);
// [["name", "Rafael"], ["role", "admin"]]
Set 會把整個 pair 當成一個 value;如果你的目標是 Map 裡的 value,應明確傳入 .values():
const values = new Set(map.values());

console.log([...values]);
// ["Rafael", "admin"]
最常見的操作是:
tags.add("es2025");
tags.has("promise"); // true
tags.delete("javascript");
tags.size; // 2
Set 和 Map 一樣採 SameValueZero:
const values = new Set([
  NaN,
  NaN,
  0,
  -0,
]);

console.log(values.size); // 2
console.log([...values]); // [NaN, 0]
物件則一樣依 reference identity:
const a = { id: 1 };
const b = { id: 1 };

const users = new Set([a, b]);

console.log(users.size); // 2
如果你要依 id 去重,要自行選出可比較的 primitive value:
const uniqueUsers = new Set(users);

// 這不能依 id 去重,因為 users 裡仍是物件

const ids = new Set([a.id, b.id]);
console.log(ids.size); // 1
Set 在規範中有自己的 [[SetData]] 內部欄位,也保證依插入順序迭代。TC39:Set objects
常見說法是「Map 一定比 Object 快」,但也可以先問自己需要哪一種資料模型。
「依插入順序」尤其值得注意。Object 的一般字串 key 會依建立順序列出,但整數型 key 會被提前按數字排序;Map 的所有 key 則一律依插入順序:
const object = {
  b: "B",
  10: "ten",
  2: "two",
  a: "A",
};

console.log(Object.keys(object));
// ["2", "10", "b", "a"]

const map = new Map([
  ["b", "B"],
  [10, "ten"],
  [2, "two"],
  ["a", "A"],
]);

console.log([...map.keys()]);
// ["b", 10, 2, "a"]
Array.find() 就夠,反覆查找再建 Map 索引選好資料模型之後,還有一個和它平行的問題:要不要為了查找而額外建一份索引? 資料放在陣列時,最直覺的做法是 Array.find():
const users = [
  { id: 101, name: "Amy" },
  { id: 102, name: "Bob" },
];

const user = users.find((u) => u.id === 102);
find() 最差是 O(n),但它的好處是查詢條件自由(id、name、age > 30 都行),資料只有幾十筆、又只查幾次時,為它多維護一個 Map 通常不划算。
真正會痛的是「反覆查找」。例如替每張訂單補上使用者名稱:
orders.map((order) => {
  const user = users.find((u) => u.id === order.userId);
  return { ...order, userName: user?.name };
});
orders 與 users 都大時,這是每張訂單都掃一次 users,複雜度 O(m × n)。此時先用第五節 new Map(iterable) 的寫法建一份以 id 為 key 的索引,就能把總成本壓到 O(n + m):
const usersById = new Map(users.map((u) => [u.id, u]));

const result = orders.map((order) => {
  const user = usersById.get(order.userId);
  return { ...order, userName: user?.name };
});
判斷的關鍵不是「超過幾筆就換」,而是 資料量 × 查找頻率:
20 筆、只找一次              → find() 很合理
1,000 筆、點一次按鈕才找一次  → find() 通常也夠
1,000 筆、另一批資料每筆都要查 → 先建 Map 索引
實務上前端先用最好懂的 find() 多半沒問題;真的遇到大量資料、巢狀查找出現效能瓶頸時,再改成 Map 索引即可。
今天從 key、相等判斷與迭代順序這些細節,重新把 Object、Map、Set 三種資料模型的基礎與容易忽略的規則整理了一遍。用一張表收斂各自的適用場景:
| 需求 | 較適合的容器 | 例子 |
|---|---|---|
| 描述一筆 JSON-like 資料 | Object |
使用者、商品、設定 |
| 以物件、函式或任意值作 key 查資料 | Map |
DOM element 對應 metadata、快取 |
| 去除重複值 | Set |
tag、ID、選取項目 |
| 判斷是否已處理/已讀/有權限 | Set |
已讀通知、permission codes |
| 需要 property descriptor 或 prototype 行為 | Object |
class instance、設定物件 |
之後章節希望介紹:
Object.groupBy(items, callback);
Map.groupBy(items, callback);
它們不是同一個 API 換個回傳型別而已:
理解今天這三種資料模型後,就能知道下一篇該選哪一種分組結果,而不是只看哪個方法名字比較短。


 iThome鐵人賽
 看影片追技術