
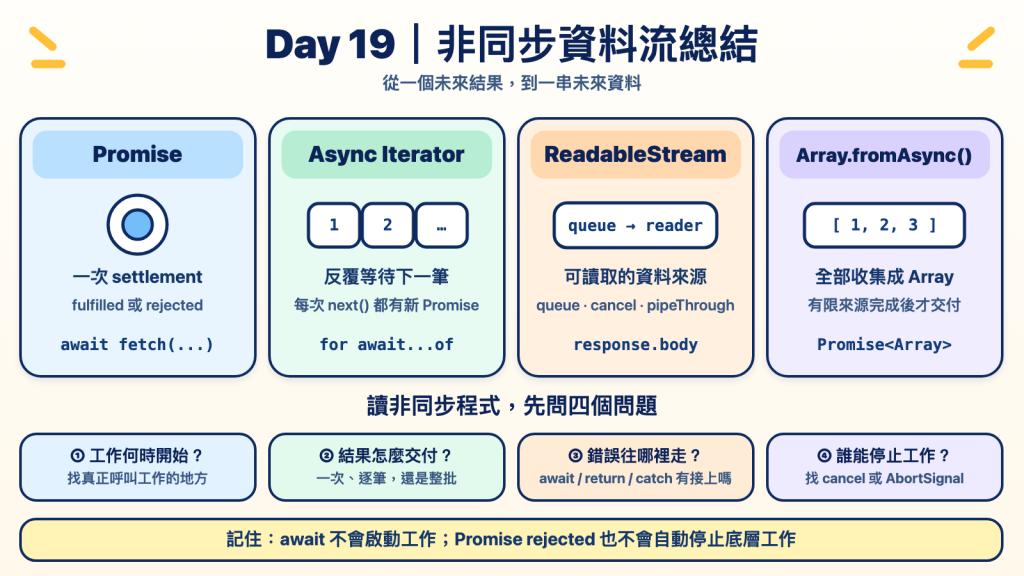
用「工作何時開始、結果如何交付、錯誤往哪裡走、誰能停止工作」四個問題,分清 Promise 的一次 settlement、Async Iterator 的反覆等待、ReadableStream 的資料來源,以及 Array.fromAsync() 的完整收集做一個學習回顧。
前置知識:建議先讀 Day 10–18,至少理解 Promise、await 與 iterable protocol。
學習路線:Day 09 曾經總結同步 Iterator;今天用同樣的方式收束非同步資料流。
標籤:Promise async/await Async Iterator ReadableStream Concurrency Error Handling Promise.try
今天只是希望暫緩一下腳步,回頭看看 Day 10 ~ Day 18 自己的觀念回顧、過程學到新東西和省思😇
Day 09 收束同步 Iterator 時,我們從 Collection Thinking 走到了「下一筆」:
不一定要先準備完整資料 Collection
使用者可以需要時才要下一筆
但當下一筆無法立刻拿到,問題就多了一個非同步時間維度:
Day 10–18 因此一路出現了 Promise、await、Async Iterator、Web Streams、SSE、Async Generator 與新的 Promise 邊界工具。
這些 API 名稱不同,但可以用四個問題重新放回同一張地圖:
- 工作何時開始?
- 結果是一個還是多個,怎麼交給資料使用端的 consumer?
- 失敗時,錯誤會往哪裡走?
- 不想再等了,誰能停止工作?
這算是理解 Promise 重要的起點之一,也是最簡單的範例:
const promise = fetch("/api/products");
const response = await promise;
在這個例子裡:
fetch(...)
→ 要求 host 啟動網路工作,立即回傳 Promise

await promise
→ 若結果還沒來,暫停目前 async function 的後半段
await 不是啟動器,也不是「把工作搬到背景」的開關。它只做一件事:在等待一個 Promise 的期間,先把控制權還給引擎,讓引擎這段時間去做別的事。
所以它能不能「不卡住主執行緒」,其實取決於它等的是什麼:
fetch() 這種由 host 環境在背景執行的工作 → 等待期間主執行緒是空的不會卡住,可以執行其他更重要的任務。await 不會把它移到背景:// 這行會卡住主執行緒好幾秒,await 幫不上忙
const total = await heavySum();
async function heavySum() {
let sum = 0;
for (let i = 0; i < 5_000_000_000; i++) sum += i; // 同步佔用主執行緒
return sum;
}
await 真正做的,是把函式後半段(拿到 total 之後的程式)先排進佇列,等主執行緒把目前這輪同步工作跑完、空出來,event loop 再把它排回來接著執行。換句話說,await 能決定的是「等待結束後何時回來」,卻管不到「回來之前那段同步計算要跑多久」。
一次建立多個 Promise 時,這個差別更明顯:
const requests = productIds.map((id) => {
  return fetch(`/api/products/${id}`);
});

const responses = await Promise.all(requests);
map() 會同步、一個接一個地呼叫每一次 fetch()。所以在程式還沒走到 Promise.all() 那一行之前,這幾個網路請求就已經全部發出、同時在路上了——
requests裡裝的,是一批都處於 pending 的 Promise。Promise.all()拿到的只是這批已經啟動的 Promise,它決定的是「等它們全部完成後一起交付」,而不是「現在才把它們並行送出去」。
反過來,只要把 await 放進迴圈,啟動時機就完全變了:
const responses = [];
for (const id of productIds) {
  // 這一筆回來之前,下一個 fetch 根本還沒被呼叫
  responses.push(await fetch(`/api/products/${id}`));
}
同樣是逐一 fetch(),這裡卻是串行的:每個 await 都擋住迴圈,等這筆回來才呼叫下一筆。並行或串行的差別,來自「fetch() 在哪一行、以什麼節奏被呼叫」,而不是有沒有用 Promise.all()。
Promise.all()負責的是「如何等待一組結果」,不是「何時啟動每一個工作」。
Promise 是一個未來結果狀態的容器:
這句話應該是當初文章寫完要下標題,比較感受深刻的一點體會吧~
pending
  ├── fulfilled(value)
  └── rejected(reason)
它的狀態只能往前走、最後交付一次,不會倒退回 pending。
const response = await fetch("/api/profile");
const profile = await response.json();
fetch() 有一個未來的 response;response.json() 也有一個未來的解析結果。這些未來結果並不是 JavaScript 引擎自己算出來的——
fetch 這類網路請求,是交給 host(瀏覽器 / Node)的 Web API 去執行;如果現在要等的不是 API 自己回傳的 Promise,或者不是「單純資料送到就結束」,而是要由未來的某個事件訊號來決定何時完成,昨天 Day 18 的 Promise.withResolvers() 就比較偏向這類應用:
現在先拿到一個 Promise
未來的 event 再完成它
但不論完成權在誰手上,最後真正呼叫 resolve 或 reject 時,單一 Promise 仍然只能指向一次最終結果。
但很多時候,資料不是一次到齊,而是多筆在不同時間陸續抵達——這時單一 Promise 就不夠用了,因為它一輩子只交付一次。
Async Iterator 的解法,是把同步 Iterator 原本「立刻回答」的 next():
iterator.next();
// { value, done }
改成回傳一個 Promise:
asyncIterator.next();
// Promise<{ value, done }>
這裡容易誤會:它不是「一個 Promise 裝著很多筆」,而是每呼叫一次 next(),就拿到一個屬於那一筆的新 Promise:
next() → Promise<第 1 筆>
next() → Promise<第 2 筆>
next() → Promise<結束>
手動一直「取得 next Promise、等待、檢查 done」很繁瑣,for await...of 就是把這個迴圈包起來:
for await (const message of messages) {
  renderMessage(message);
}
它還多做了一件事:提早離開時(break、return 或 throw),for await...of 會呼叫 iterator 的 return(),讓來源有機會關閉連線或釋放資源(Day 12)——這是它比手動 next() 更安全或靈活的地方。
反過來,如果 consumer 根本不想逐筆處理,只想等一個「最終會結束」的來源全部到齊、收成一個 Array,就輪到 Day 17 的 Array.fromAsync()——標準庫直接提供的收集 API:
const messages = await Array.fromAsync(messageStream);
for await...of
→ consumer 逐筆取得控制權

Array.fromAsync()
→ consumer 等來源全部結束後取得 Array
Promise 和 Async Iterator 並不是二選一的競爭關係的語法,而是各自回答不同的問題:
Promise
→ 描述一個未來結果

Async Iterator
→ 描述反覆索取下一個未來結果的協議
Async Iterator 提供 ECMAScript 的「反覆等待下一筆」協議;ReadableStream 則是 Web API 的可讀資料來源。它不只交付多筆值,還有自己的 queue、reader、正常 close、error 與 cancel lifecycle:
ReadableStream
→ queue 讓已準備好的值等待 consumer
→ cancel 讓 consumer 表達不再需要來源
→ pipeThrough() 讓來源可串接轉換 stages
最常見的 ReadableStream,就是 fetch() 的 response.body:await fetch() 先拿到 response,body 的 bytes 之後才一段一段抵達,而且每段 chunk 不會剛好對齊你要的資料邊界。
Streams API 大概就以下這些重要心法 :
getReader()、lock 如何釋放、close / error / cancel 的差別 → Day 14 的 reader lifecyclechunk、controller 深入 reader/writer 與 pull 型來源,再讀懂 Hono 的 StreamingApi → Day 16
老實說,ReadableStream 是我工作上比較少直接碰、這次才第一次認真學的東西。一開始以為照著 MDN 的說明就能上手,但那份文件讀起來更像規格書——字都看得懂,卻拼不出全貌。
真正比較有感,是到 Day 16 自己親手把一條 stream 從 producer 寫到 consumer 跑過一遍之後。先不論它日常實不實用——它其實可能天天都在跑,只是被包在 fetch、框架與 SDK 底下,太底層、也包裝得太好,平常反而看不見它。
Promise.all() 與 for await...of 在回答不同問題這兩個寫法常被簡化成「並行對上串行」,但更準確的差別在 consumer:
const products = await Promise.all(productPromises);
consumer 說:
這批結果全部完成後,再一次交給我。
for await (const product of products) {
  renderProduct(product);
}
consumer 說:
按資料來源定義的順序,一筆一筆交給我。
底層工作同時有幾個正在進行,則是 producer 的 concurrency 問題。
const requests = productIds.map(fetchProduct);
await Promise.all(requests);
這段程式會在 map() 期間呼叫所有 fetchProduct()。Promise.all() 不會自動把並行數限制為 3 或 5;要限制同時工作數,必須讓 producer 分批建立 Promise,或使用 worker pool。
這也是為什麼看到 Promise 程式時,不能只數 await 出現幾次,而要回頭看工作是在哪一行被建立。
順帶釐清一個常見的混淆:Day 17 的 Array.fromAsync() 最後也交給你「一個 Array」,很容易被當成 Promise.all() 的近親。但兩者在 concurrency 上正好相反:
Promise.all([...])
→ 一批已經同時在跑的工作,整批等它們完成(並行)

Array.fromAsync(asyncSource)
→ 逐筆 pull:這一筆 await 完,才向來源要下一筆(循序)
換句話說,Array.fromAsync() 的節奏其實站在 for await...of 這一邊,只是最後幫你收成 Array,並不會讓多個工作同時進行。想要並行、又收成 Array,仍得自己先把工作建成 Promise 陣列再 Promise.all(),而不是丟給 Array.fromAsync()(Day 17 第八節有完整例子)。
await 會把 rejection 帶回 async function 的暫停點,表現得像在原地 throw:
async function loadProducts() {
  try {
    const response = await fetch("/api/products");

    if (!response.ok) {
      throw new Error(`HTTP ${response.status}`); // catch
    }

    return await response.json();
  } catch (error) {
    console.error("載入失敗", error);
    throw error;
  }
}
但 try...catch 不會自動接住所有未來發生的錯誤:
async function loadProducts() {
  try {
    fetch("/api/products");
  } catch (error) {
    // 接不到 fetch Promise 未來的 rejection
  }
}
這個 Promise 沒有被 await、return 或連接 .catch(),它已經離開目前的錯誤處理邊界。這類程式常被稱為 floating Promise。
若要讓呼叫端決定怎麼處理,應該回傳它:
function loadProducts() {
  return fetch("/api/products");
}
若要在當前 async function 處理,就要等待它:
async function loadProducts() {
  try {
    return await fetch("/api/products");
  } catch (error) {
    reportError(error);
    throw error;
  }
}
前面談的都是「自己寫的」async 流程,錯誤路徑相對好掌握。但實務上,封裝層常常要呼叫一個外部傳進來的 callback——它可能來自 plugin、parser,或一個可替換的資料來源,行為完全不在我們手上:同一個 callback,可能同步回傳一個值、回傳一個 Promise,也可能在執行到一半時同步 throw,這三種我們都得接得住。
最容易漏掉的是「同步 throw」。舉個例子,一個從 localStorage 取資料的 callback,資料壞掉時就會同步 throw:
const getProducts = () => JSON.parse(localStorage.getItem("products"));
// 解析失敗會同步 throw
直覺上會想用 Promise.resolve(callback()) 把它收進 Promise,再統一用 .catch() 處理:
Promise.resolve(getProducts()).catch(handleError); // 接不到同步 throw
但這裡藏了一個順序陷阱:
getProducts()是在Promise.resolve(...)被呼叫之前就先執行完的。一旦它同步 throw,程式就在那一行當場中斷,Promise.resolve()根本還沒輪到,後面的.catch()自然接不上。
問題的根源,是我們在 Promise 邊界之外呼叫了 callback。真正需要的,是把 callback 包進 Promise 邊界裡面執行。你其實可以自己手寫一個包裝:
new Promise((resolve, reject) => {
  try {
    resolve(getProducts()); // 一般值、回傳的 Promise 都用 resolve 收
  } catch (error) {
    reject(error);          // 同步 throw 自己 catch 再 reject
  }
});
ES2025 的 Promise.try() 就是這段的簡寫,讓 callback 不論走哪一條路,都落回同一條 Promise 鏈:
Promise.try(getProducts)
  .then(renderProducts)
  .catch(handleError); // 一般值、同步 throw、回傳 Promise 都接得到
return 一般值   → fulfilled
同步 throw       → rejected
return Promise  → 跟隨該 Promise 的最終結果
它會立即同步呼叫 callback(不是排進 microtask),只是把 return 與 throw 統一轉成 Promise 結果——你不必再自己寫 try/catch + reject 那段樣板。
所以這類「行為由外部決定」的邊界(plugin hook、parser、可替換的資料來源)最適合用它;自己控制的
async function本來就把三種情況都收在函式裡,直接呼叫即可,不需要它。
Promise.all() 只要遇到第一個 rejection,它回傳的 Promise 就會 rejected:
await Promise.all([
  fetchProduct(1),
  fetchProduct(2),
  fetchProduct(3),
]);
但聚合 Promise 已經 rejected,不代表其他 request 自動停止。這些工作是由 host API 執行,Promise 只表示它們的結果。
這條邊界可以寫成:
Promise fulfilled / rejected
→ 告訴我們結果狀態

底層工作是否繼續
→ 由產生工作的 API 與它支援的協議決定
真正要送出停止訊號,得靠另一套機制——fetch 用的是
AbortSignal,跟 Promise 是兩回事。這裡先記住「結果與停止權分離」就好,取消原因、timeout 等 ~Promise 狀態容器並不會自動幫你取消 。
用表格收束:怎麼選、怎麼記,倒不用每個細節都記得很清楚,我覺得知道有這些工具像AI一樣有自己的 skill context 知識庫就行
| 模型 | 它表示的是什麼 |
|---|---|
| Promise | 一次 settlement:一個未來結果最後 fulfilled 或 rejected |
| Async Iterator | 反覆等待下一筆結果:每次 next() 都得到新的 Promise |
| ReadableStream | 排隊、可取消、可串接的來源:以 queue、cancel 與 pipeThrough() 管理資料流 |
Array.fromAsync() |
有限來源 materialize 成 Promise<Array>:逐筆讀取,完成後才交付完整 Array |
| 情境 | 主要工具 | 心智模型 |
|---|---|---|
| 等待一次 API 結果 | Promise + await |
一個未來結果 |
| 等待一批已啟動的工作 | Promise.all() |
整批結果全部完成再交付 |
| 反覆等待下一筆 | Async Iterator + for await...of |
每次 pull 都取得一個未來結果 |
| 將有限的非同步來源完整收集 | Array.fromAsync() |
Day 17:逐筆等待,全部完成後交付 Array |
| 分清串流端點與消費責任 | Web Streams | Day 13 的角色地圖與 Day 14 的 reader lifecycle |
| 接收完整 SSE 事件 | EventSource 或 SDK 的 Async Iterable |
Day 15:事件邊界由協定與 adapter 決定 |
| 處理 fetch body 的逐段資料 | pipeThrough() / pipeTo() |
Day 16:chunk/controller/reader/writer 與 pull,並解析 Hono StreamingApi |
| 先交出 Promise,未來由 event 完成 | Promise.withResolvers() |
Day 18:建立者與完成者分開 |
| 呼叫可能 return、throw 或回傳 Promise 的 callback | Promise.try() |
第六節:把外部 callback 的同步 throw 也收進 Promise 邊界 |
| 停止支援 signal 的工作 | AbortController / AbortSignal |
工作與停止權分離 |
這張表不是「只能選一個」。同一個功能常會組合它們:
fetch 產生 Promise<Response>
        ↓
response.body 提供 ReadableStream
        ↓
for await...of 逐 chunk 消費
        ↓
AbortSignal 在使用者離開時要求停止
這幾天下來不只是多認識幾個 API,而是把 JavaScript 的資料流從「現在的下一筆」擴展成「未來的下一筆」。
接下來會希望由「資料怎麼來和接收取用」轉向「資料該怎麼存」,也就是不同的資料型態像是Map/Set等的應用~還有11天,繼續自我探索的旅程🤗。


 iThome鐵人賽
 看影片追技術