
Day 5 講過,我自己一個人用 AI 做 code review 遇到的第一個困難,是「還有沒有問題」這個問法本身沒有終點,後來拆成三個角色分頭做,才有辦法真的停下來。那篇講的是一個人怎麼收斂。今天要講的是另一層問題,一個人可以靠自己對整個流程的理解去判斷什麼時候該停,但這件事要放大到一個團隊、放大到每天都會發生很多次,光靠一個人的判斷力,就不夠用了。
這兩篇之間的關係,我自己會用一句話簡單總結,一個人解決的是收斂的問題,團隊解決的是信任的問題。收斂靠的是對這個系統夠不夠熟悉,熟悉了自然知道什麼時候差不多了。信任靠的不是熟悉,是有沒有留下足夠的憑據,讓不熟悉這個系統的人,也能判斷這次審查到底做得夠不夠。這兩件事看起來都叫 code review,實際上分別對應到完全不同的痛點,也需要完全不同的解法。
我自己一個人用的時候,停下來的依據,說到底是一種對這個流程夠不夠熟悉之後產生的判斷,我知道這次的改動範圍大概多大,知道哪幾類問題是這個專案常見的地雷,這種判斷沒辦法直接複製給別人,因為它建立在我自己這段時間累積下來的經驗上。
一個人的時候,這種依賴經驗的判斷沒什麼問題,出錯了我自己承擔,下次調整就好。但放到團隊裡,同樣一句「這次審得差不多了」,換了不同的人來判斷,標準可能完全不一樣,有人比較嚴謹,有人比較寬鬆,這種落差團隊裡的人自己都感覺得到,只是平常沒有人把它講破。更麻煩的是,就算某一次審得很仔細,也沒有人能拿出具體的東西證明審過哪些範圍、對照過哪些規則,只能相信那個人真的有認真做。
這種落差不一定是誰偷懶造成的,很多時候只是每個人對「差不多了」這句話的理解本來就不一樣。同一份改動,經驗多的人可能一眼就看出關鍵風險在哪,判斷得快也判斷得準,經驗少一點的人可能得多花時間才能抓到同樣的風險,如果單純用審得快不快來評斷認不認真,反而會冤枉那些其實審得很仔細、只是還在累積經驗的人,這也是為什麼光靠個人自覺這件事,本身就撐不起一個規模夠大的團隊。
這種「只能相信」的狀態,在團隊規模小的時候還撐得住,因為互相熟悉,出了問題也容易追溯回去是誰負責的那一段。規模一大,這種靠信任撐著的默契會慢慢失效,沒有人記得上一次某個模組是誰審的、審了什麼,出問題的時候只能從頭排查,沒辦法直接翻紀錄找到當初的判斷依據。
這種失效通常不是一次爆發出來的,是慢慢滲進日常裡的。一開始只是偶爾有一兩次審得比較鬆,沒人特別在意,反正這次剛好沒出事。次數多了之後,鬆的標準反而變成一種沒人明講、卻大家心照不宣的默契,新加入的人會有樣學樣,覺得原來這裡的審查大概就是這種鬆緊度,於是標準又再往下滑一點。等到真的因為某次審得不夠仔細而出事,回頭想找出問題到底出在哪一次審查,才發現根本沒有留下足夠的線索可以回溯,只能靠大家的記憶拼湊,而記憶這種東西,越久越不可靠。
這種慢慢滑落的過程特別難察覺,是因為每一次鬆一點點,單獨拿出來看都不算什麼大事,真正累積成問題,往往要等到滑落了很長一段時間之後。這種性質的風險,跟前面講過的那種同一種錯誤反覆出現的訊號很像,都是那種在單次事件裡看不出嚴重性,只有拉長時間軸才會現形的問題,也因此特別容易被輕忽,覺得下次注意一點就好,卻沒有人真正去改變造成這件事持續發生的根本原因。
我自己最近認真測試過一套專門把 code review 流程工程化的開源工具,測試完之後想通的一件事是,團隊要解決的問題,跟我一個人解決的問題根本不是同一種問題。我要解決的是「什麼時候該停」,團隊要解決的是「怎麼讓每一次的審查都有辦法被查核,而不是只能相信」。
這兩個問題乍看很像,其實指向完全不同的解法。「什麼時候該停」解決的是效率跟精力分配的問題,答案可以因人而異、因時而異,沒有標準答案,只要那個停下來的判斷經得起自己事後回頭檢視就好。「怎麼讓審查可以被查核」解決的是信任怎麼在一群人之間建立跟延續的問題,答案不能只靠某個人的自覺,得靠一套不管換誰執行、結果都能被拿出來核對的機制,這種機制天生就沒辦法只靠個人的判斷力撐起來,得靠流程本身的設計。
那次測試,我特地找了一個小型的專案,故意埋進兩個真實的 bug,混在一個正常的改動裡,用同一顆模型,分別跑兩種做法,一種是工程化的審查管線,另一種是普通的、什麼都交給 AI 自己判斷的通用型 agent。結果兩邊都抓到了那兩個 bug,也都沒有誤報,普通的通用型 agent 反而跑得更快、用的資源更少。
會特地設計成故意埋 bug 這種測試方式,是因為我想確認的不是模型抓得到抓不到問題這種基本能力,這件事現在的模型基本上都做得到,我真正想知道的是,兩種做法在同樣抓到問題的前提下,過程留下的東西有什麼差別。如果只看最後有沒有抓到 bug,兩種做法看起來沒什麼高下之分,這也是為什麼我覺得單純比較抓到幾個問題,不是評估這類工具真正該看的指標。
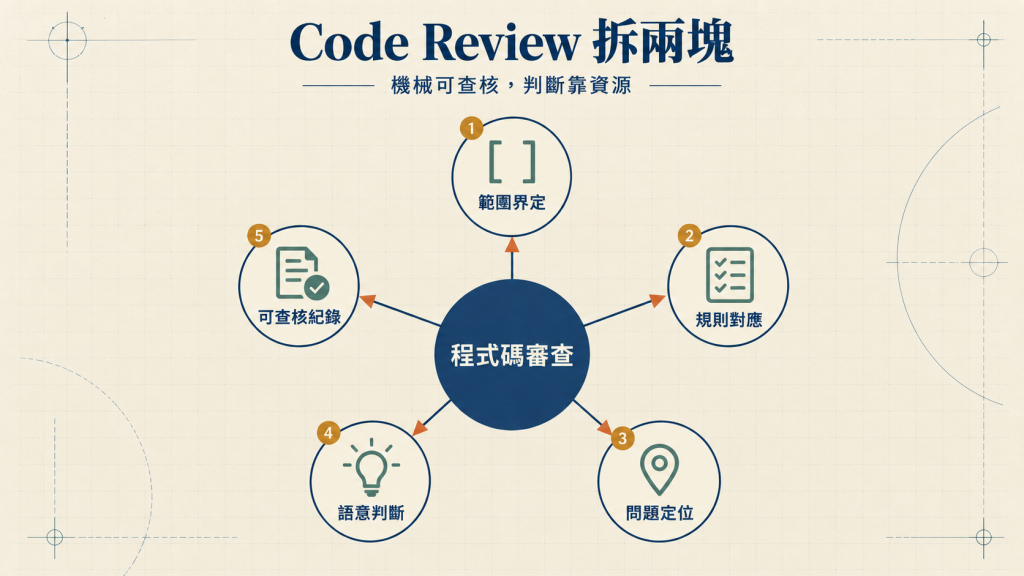
單看抓到多少問題,工程化的管線並沒有比較聰明,這個結果一開始讓我有點意外,原本以為專門設計過的流程應該會表現得更好,畢竟花了力氣特別去設計,直覺上總覺得應該要換來更好的結果,結果卻只是打平,速度還輸給更單純的做法。後來仔細比對兩邊實際跑的過程,才發現真正的差別不在抓到幾個問題,在於審查的過程能不能被攤開來看。工程化的那一套,會先明確列出這次審查涵蓋了哪些檔案、對應到哪幾條規則、每個發現的問題定位在程式碼的哪一行,這些東西全部都留下紀錄,可以事後拿出來核對。普通的通用型 agent,抓到問題的能力不輸人,但過程是黑盒子的,問它審了哪些範圍,只能拿到一段文字描述,沒辦法真的去核對它是不是真的把該看的地方都看過一遍。
這種差別在只跑一次的時候幾乎感覺不出來,因為那一次的結果剛好是對的,兩種做法看起來一樣可靠、一樣值得信任。真正的差別要在跑很多次、跨很長一段時間之後才會顯現出來,工程化的那一套,每一次的紀錄都可以疊加起來,變成一份可以回頭追溯的歷史。通用型的那一套,每一次的結果都是獨立的一次性判斷,這次做得好,不代表下次同樣做得好,也沒有辦法從過去的紀錄裡看出這個系統長期下來到底有哪些反覆出現的問題類型。
這個發現讓我重新想清楚一件事,code review 這件事本身,其實可以拆成兩種完全不同性質的工作。一種是機械性的,範圍要涵蓋哪些檔案、對應哪些規則、怎麼定位到程式碼的哪一行,這些東西可以交給程式明確地做,做完了留下清楚的紀錄,事後隨時可以核對有沒有漏掉。另一種是真正需要判斷力的,這段邏輯有沒有問題、這個改動的語意有沒有踩到不該踩的地方、幾個看起來很像的發現到底是不是同一件事,這種判斷還是得靠夠強的模型去做,沒辦法用固定規則取代。
這個拆分方式讓我想起自己在其他場景也一直在用的同一套邏輯,機械性的、可以明確講清楚步驟的事,用比較便宜的資源做就好,真正需要拿捏、需要理解全局的判斷,才值得花比較貴的資源。code review 一直被當成一件整體的事在談,好像審查這個動作本身就是一個不可分割的黑盒子,實際上把它拆開來看,裡面明明白白混著這兩種完全不同性質的工作,只是過去沒有人把它們分開處理過。
過去會把 code review 整包當成一件事來談,我猜是因為以前這件事完全靠人工做,一個人審查的時候,機械性的核對跟真正的判斷是同時發生在同一顆腦袋裡的,沒辦法拆開來看,久而久之,大家也就習慣把整個審查動作當成一件不可分割的事來討論。等到有了可以分別處理這兩種工作的工具,這個過去被視為理所當然的整體,才第一次真正有機會被拆開來檢視。
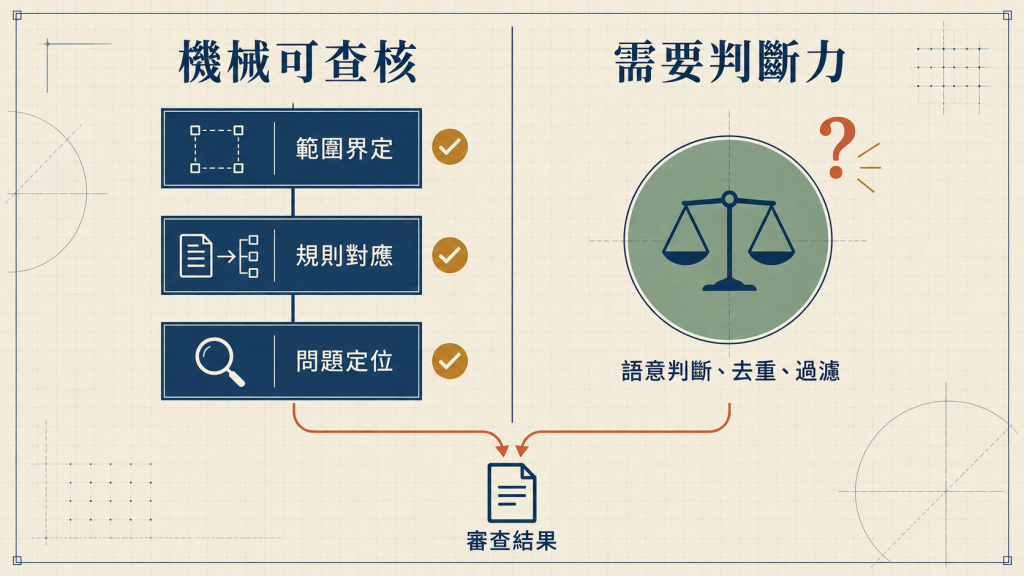
把這兩種工作分清楚之後,我才真正理解為什麼工程化的意義不在於抓得更準,在於讓機械那一塊變得可以被稽核。判斷那一塊本來就沒辦法完全消除誤判的風險,這是所有審查方式共同的極限,工程化解決不了這件事,也不應該假裝自己解決了。
我自己一開始會有點期待工程化之後連判斷的準確度也一起提升,測試完才發現這個期待本身就搞錯方向了。判斷力這件事沒辦法透過流程設計繞過去,模型還是有可能漏掉一個隱晦的邏輯錯誤,也還是有可能把兩個其實不一樣的問題誤判成同一件事。工程化真正能做到的,是讓「這次到底有沒有認真看過該看的地方」這個問題有明確的答案,至於看過之後判斷得準不準,仍然是另外一件事,兩件事不能混為一談,也不該互相取代。
把這兩件事分開看之後,我對「這次審查夠不夠好」這句話也有了不一樣的評估方式。以前這句話只有一個籠統的答案,現在我會拆成兩個問題分別回答,該看的地方是不是都看過了,看過之後的判斷有沒有明顯的疏漏。前者可以很有把握地回答,因為有紀錄可以核對,後者只能誠實承認沒辦法百分之百保證,這種誠實的區分,反而比籠統地說一句夠好了,更能讓人放心。
測試完之後,我沒有直接把原本的做法整個換掉,而是照著一個順序慢慢調整。第一步,先只看範圍對不對,這一步完全不呼叫模型,單純確認這次審查框出來的檔案跟規則,是不是真的涵蓋到該涵蓋的地方,範圍框錯了,後面不管模型判斷得多準都沒有意義。
第二步,我會特別留意同一個問題會不會因為程式碼行號稍微挪動,就被系統誤判成一個全新的問題。這件事聽起來瑣碎,實際上如果沒處理好,每次改動只要行數變了,舊的發現就會整批被當成新的重新冒出來,審查紀錄會很快就變得不可信,因為看起來一直有新問題,其實只是同一個問題換了個位置。
這種瑣碎的細節之所以值得認真對待,是因為它一旦出錯,傷害的往往不是單一次的審查結果,是整份紀錄長期累積下來的可信度。第一次看到同一個問題被重複標記成新的,可能只覺得系統有點笨,多看幾次同樣的情況,就會開始懷疑整份紀錄到底還能不能信,一旦這種懷疑冒出來,前面辛苦建立起來的可查核性,等於白費了一大半,因為沒有人會想去核對一份自己都不太相信的紀錄。
我自己會特別注意這種看起來瑣碎、實際上會侵蝕整體可信度的細節,是因為它跟前面除錯那幾天講過的道理是同一件事,機檢或工具留下的訊號,如果本身就會騙人,帶來的傷害比完全沒有訊號還要大,因為沒有訊號的時候,大家還知道要靠人工多查一次,有了會騙人的訊號,反而會讓人習慣性地信任它,慢慢忽略掉真正該保持的警覺。
第三步,才是真正決定要不要把原本什麼都交給 AI 自己判斷的做法,換成這種工程化的流程。這個決定我覺得沒有一個放諸四海皆準的標準答案,看的是這個團隊到底需不需要事後可以查核的紀錄。如果只是自己一個人快速迭代的小東西,通用型的做法可能反而比較划算,跑得快、設定也簡單。如果是牽涉到好幾個人、審查結果要留下來讓別人也能檢查的場景,工程化那一套換來的可查核性,就值得多花的那一點設定成本。
這個順序背後其實藏著一個我自己很在意的原則,先確認基礎的東西是不是牢靠,再談要不要往上疊加更複雜的機制。如果一開始範圍就框錯了,或者行號漂移這種基礎問題都還沒解決,就急著討論要不要換整套審查工具,等於是在還沒把地基打穩之前,就先在上面蓋房子,蓋得再漂亮,底下鬆動一次,上面的東西全部都會跟著垮下來。
這個判斷順序,其實跟我自己一直在用的另一個習慣是同一件事,先確認機械性的那部分有沒有做對,再決定要不要把資源花在更貴的判斷上。範圍跟定位這種可以工程化的步驟,我會用比較輕量的方式先跑過一遍確認,真正燒判斷力的地方,留到後面再處理,不會一開始就把最貴的資源砸在還沒確認過範圍的審查上。
這種先確認機械性基礎、再花力氣在判斷上的順序,聽起來像是常識,實際執行的時候卻很容易被跳過,因為機械性的步驟通常不起眼,不太會有人特別去注意它有沒有做對,大家的注意力自然而然會被判斷結果吸引過去,反而忽略了判斷結果建立在什麼樣的基礎上。我自己也犯過這種錯,一開始太急著看模型判斷得準不準,反而沒仔細確認範圍框得對不對,後來發現有幾次判斷之所以看起來怪怪的,根本原因不是模型判斷錯,是一開始給它看的範圍就漏掉了關鍵的檔案。
這種錯誤特別容易讓人誤判方向,因為表面上看起來像是判斷力不夠,直覺反應會是換一顆更強的模型,實際上換了模型,範圍還是漏的,問題自然還是解決不了。這跟前面除錯那幾天講過的道理是同一件事,同一種錯誤反覆出現,該檢查的往往不是最後那一步判斷,是更前面的基礎有沒有先打好。
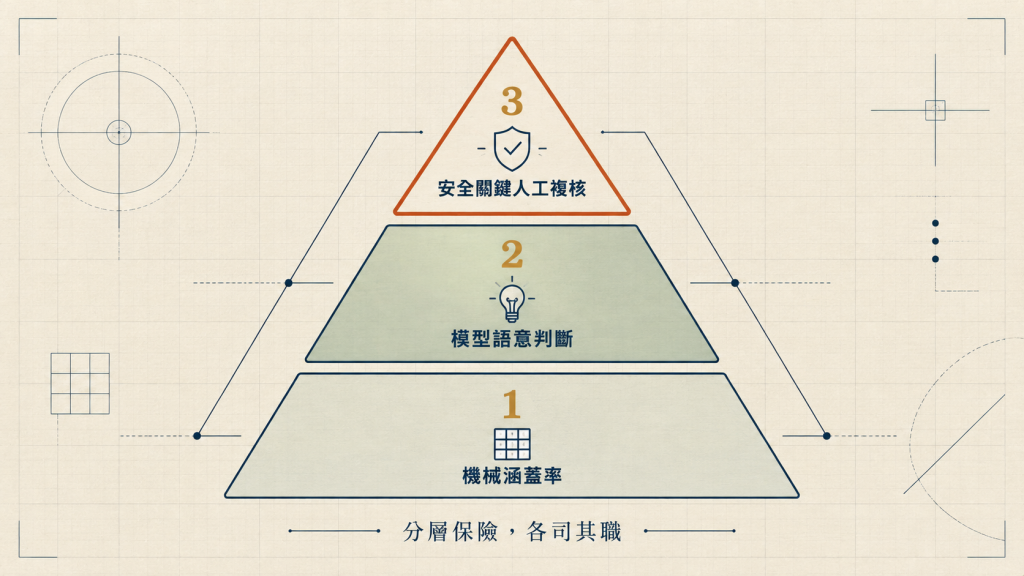
有一件事我自己特別提醒自己不要忘記,不管審查流程做得再怎麼工程化、再怎麼可查核,遇到真正安全關鍵的改動,我還是不會只靠這一套流程就放行。這種時候我會另外再跑靜態分析工具、確認測試有沒有涵蓋到,最後還是要有人真的坐下來讀一遍程式碼再拍板。
工程化這件事真正解決的是「這次審查到底有沒有真的涵蓋該涵蓋的範圍」這個問題,它沒辦法解決「這個系統的安全邊界到底設計得對不對」這種更深層的判斷,這種判斷牽涉到的東西太多,沒辦法只靠審查流程本身補回來,需要的是對整個系統的理解,跟審查工程化不是同一個層次的事。
這件事我自己會反覆提醒自己,是因為工程化做得越漂亮,越容易讓人產生一種錯覺,覺得既然流程都設計得這麼嚴謹,應該可以信任到底。這種錯覺特別危險,因為它會讓人不自覺地放鬆真正該保持警覺的那一層,把原本該留給人工複核的力氣,錯放到已經工程化的地方去加強,反而讓最需要判斷力介入的那一段,變得比原本更脆弱。工程化這件事本身沒有錯,錯的是誤把它的效果延伸到它根本管不到的範圍。
判斷一段改動算不算安全關鍵,我自己不會只看程式碼本身動了多少行,會去看這段邏輯出錯之後,實際上會影響到什麼。動的行數很少,但牽涉到權限判斷或者資料存取範圍的地方,我還是會當成安全關鍵處理,反過來,動的範圍看起來很大,但只是調整介面呈現方式的改動,就不需要疊上同樣重的那一層。這個判準比單純看改動大小更準確,因為風險的大小從來不是跟改動的行數成正比的。
這種判準需要一點對系統整體運作方式的理解才能拿捏得準,這正好呼應了前面提過的分層原則,機械性的範圍界定可以交給工具做,但決定哪些改動該被歸類為安全關鍵,本身就是一種需要判斷力的工作,沒辦法完全用固定規則取代,也是我自己到現在都還會親自把關、不敢完全放手的地方。
我自己會把這件事想成一種分層的保險,機械性的範圍跟定位工程化之後,可以確保基本的涵蓋率不會出包,這是最底層、最便宜的那一層保障。真正判斷力的部分,還是得留給夠強的資源去做,安全關鍵的變動再疊上一層人工複核,這幾層各自負責不同性質的風險,不能拿其中一層去取代另一層,也不該假裝其中一層可以單獨扛起全部的責任。
這種分層的想法,也讓我在跟團隊裡的人討論該投入多少力氣在審查上的時候,有一個比較具體的說法可以講。不是籠統地說這次改動很重要要多審幾遍,而是能明確指出這次改動屬於哪一層風險,機械性涵蓋率的部分有沒有做到,判斷力的部分找了誰來看,安全關鍵的部分有沒有另外走一輪人工複核。把責任攤開來講清楚,比一句模糊的多審幾遍,更能讓每個人知道自己實際上該對哪一段負責。
回頭看這整件事,團隊需要的東西,跟我一個人用的時候需要的東西,方向其實不太一樣。我一個人只需要對自己負責,判斷得準不準,自己心裡有數就好。團隊需要的是別人也能看得懂、能核對的東西,不管是誰在審、審了幾次,只要拿出紀錄,就能知道當初到底審過哪些範圍、對照過哪些規則、留下了哪些還沒解決的發現。
這個方向上的差異,我覺得也解釋了為什麼很多團隊在導入 AI 輔助審查的時候,一開始很興奮,後來慢慢冷下來。一開始大家看到的是模型能不能抓到問題,這件事確實讓人驚艷,效果好的時候,感覺比很多資深工程師掃得還仔細。但用久了之後,真正卡住的往往不是抓得準不準,是沒有人能明確講出這次審查到底做了什麼,出了問題也沒辦法回頭追。這種卡點,靠換一個更厲害的模型是解決不了的,因為問題根本不在判斷力夠不夠,在於整個過程有沒有留下能被查核的東西。
這也是為什麼我自己現在評估一套審查工具好不好用,不會只看它抓 bug 的能力,會特別去看它留下的紀錄夠不夠完整、夠不夠好查。抓 bug 的能力隨著模型進步,遲早會越來越接近,真正能拉開差距、決定一套流程適不適合放到團隊規模去用的,反而是這種平常不太起眼的紀錄品質。
這種紀錄留下來的價值,跟前面幾天講過的那種留紀錄的習慣是同一個道理,當下看起來只是多做一步、多花一點設定的力氣,真正的回報要等到事後有人需要回頭查、需要交接、需要重新理解當初為什麼做出某個判斷的時候,才會完全顯現出來。沒有這份紀錄,團隊每一次的審查都只能重新從頭建立信任,有了這份紀錄,信任才有辦法真正一次一次累積下去,而不是每次都得靠相信某個人的自覺。
這種累積信任的過程,說起來有點抽象,實際上有一個很具體的檢驗方式可以拿來對照,新加入團隊的人能不能只靠翻閱過去的審查紀錄,就大致理解這個專案在哪些地方特別容易出問題、哪些規則是每次都會被特別強調的。能做到這一點,代表這份紀錄真的發揮了它該有的作用,做不到,就算流程再怎麼工程化,實際上也只是把原本口耳相傳的默契,換了一種形式繼續靠人腦記憶,沒有真正解決問題。
我自己會用這個標準檢查任何一次流程調整值不值得做,如果調整完之後,紀錄反而比以前更難被一個陌生人看懂,那就算流程本身看起來再嚴謹、每個步驟都設計得很細緻,我也會覺得這個方向是錯的,值得停下來重新想一次,而不是繼續往下疊加更多細節,因為越複雜的流程,越容易在不知不覺間,變成只有設計它的那個人才看得懂的東西,最後反而違背了工程化最初想解決的那個問題。
這件事也讓我重新理解交接這件事真正的本質。過去覺得交接做得好不好,看的是有沒有把知道的事情講清楚,現在會多想一層,交接的內容能不能被拿去核對,而不是只能單方面地聽、單方面地信。一份能被核對的紀錄,交接起來的可靠程度,遠比一段憑印象講出來的說明高出許多,因為聽的人不用照單全收,隨時可以自己回頭查證,也不用擔心哪個細節在口頭轉述的過程中不小心被漏掉。
我自己現在會把這件事當成一個簡單的判準,決定要不要把審查流程再往工程化推進一步的時候,我會問自己,這次的審查結果,除了我自己以外,還有沒有別人需要拿出來用、需要事後核對。答案是需要的話,多花一點力氣把機械性的那一塊做成看得見的流程,長期來看一定划算,答案是不需要,那就沒必要為了工程化而工程化,把原本簡單就能解決的事情弄得更複雜,這個判準比任何抽象的原則都更容易在當下派上用場。
這件事也讓我對「規模化」這三個字有了不太一樣的理解。過去聽到規模化,直覺想到的是把同一件事做得更快、涵蓋更多案例,套用到 code review 上,很容易誤以為規模化就是想辦法讓 AI 抓到更多問題、審得更快。實際測試一輪之後才發現,真正卡住規模的瓶頸,從來不是抓問題的能力,是有沒有辦法讓每一次的審查結果,變成一份不管誰來看都看得懂、都能核對的東西。抓問題的能力,一顆夠強的模型基本上就有了,能不能規模化,看的是這份能力有沒有被包在一個可以被信任、可以被傳承下去的流程裡。
這個理解也讓我對接下來要不要投入更多時間打磨審查工具,有了比較清楚的優先順序。與其花時間去追更高的抓 bug 準確率,我會先把力氣放在讓紀錄更容易被陌生人看懂這件事上,因為前者的邊際效益已經很有限,後者才是真正決定這套流程能不能撐得住團隊規模的關鍵,也是接下來我會持續花時間打磨的地方。


 iThome鐵人賽
 看影片追技術