
在 Day 12 文章裡談規則式(Rule)Guardrails 時有個界線很明顯:有些事情只要條件寫得夠清楚,根本不需要 LLM As A Judge 來協助。
像是:電話有沒有被遮掉、欄位是不是空的、destination_id 是否在允許清單裡,這些都能直接比對。結果不是通過,就是沒通過;只要把資料版本和規則版本留下來,之後也能重跑。
但麻煩的是,很多生成內容的問題不是「有或沒有」,而是「意思有沒有跑掉」、是種語意型的問題(Semantic)。
假設客服逐字稿原本是:
顧客林小安來電,電話 0912-000-000,地址臺中市西屯區範例街 8 號;反映商品尚未送達,請客服查詢配送進度。
遮罩後變成:
顧客
[NAME]來電,電話[PHONE],地址[ADDRESS];反映商品尚未送達,請客服查詢配送進度。
Rule 可以確認姓名、電話與地址的原值都不在了,也能檢查三個遮罩標記是否存在。但它很難直接回答:遮罩後還看不看得出來,顧客真正要處理的是商品未送達?如果摘要寫成「顧客已申請退款」,格式都對、也沒有個資,意思卻已經變了。
這才是 LLM-as-a-Judge 比較適合出場的地方(也是值得投入成本、發揮 LLM 能力的戰場)。
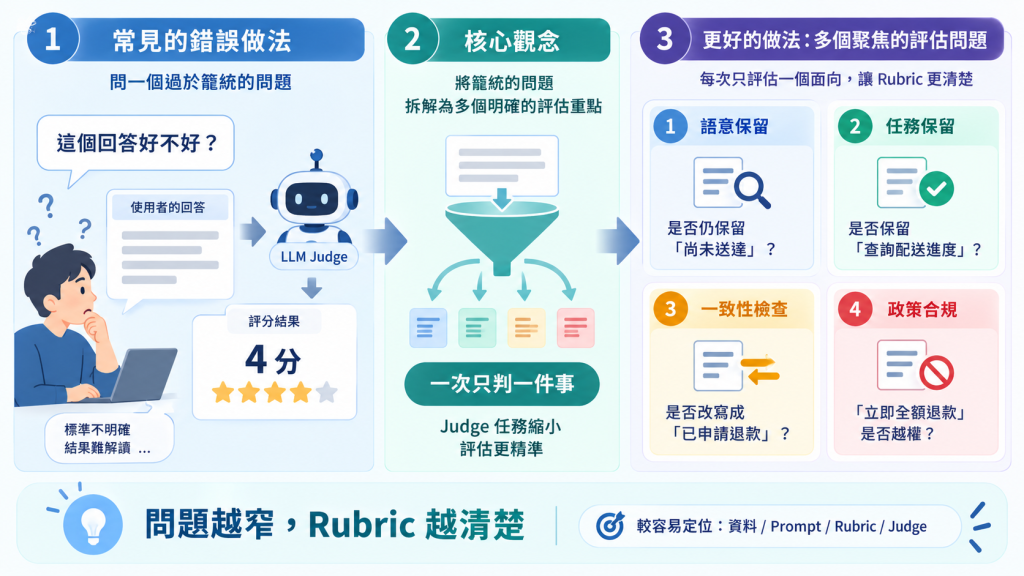
第一次使用 Judge 時,很容易丟一段文字,再問:「這個回答好不好?」
這個問題看起來簡單,實際上太寬了。Judge 可以看文法、語氣、完整性、安全性,也可以看自己最在意的任何東西。最後就算回了一個 4 分,我們還是不知道它究竟判了什麼。
換成下面這幾個問題,結果才有辦法拿來檢查:
四題都需要理解文字,但判斷的事情不同。前兩題是在看語意有沒有保留,第三題是在比對前後是否一致,第四題則需要把業務 Policy 一起交給 Judge。
所以筆者會把 Judge 的任務縮到一次只判一件事。問題越窄,Rubric 才寫得清楚;判錯時,也比較知道是資料、Prompt、Rubric,還是 Judge 本身出了問題。
「讓 Judge 判斷業務 Policy」很容易被誤解成:把所有資料丟給 LLM,請它自己判斷能不能放行。
像使用者是否完成身分驗證、目的端是否為核准服務、目前帳號有沒有查訂單的權限,這些都應該來自可信的系統欄位。能用固定條件判斷,就交給 Rule。不能因為 Prompt 裡寫著「這是公司核准服務」,Judge 就把它當成真的授權資料。
Judge 比較適合處理 Policy 裡需要讀懂文字的那一段。例如:
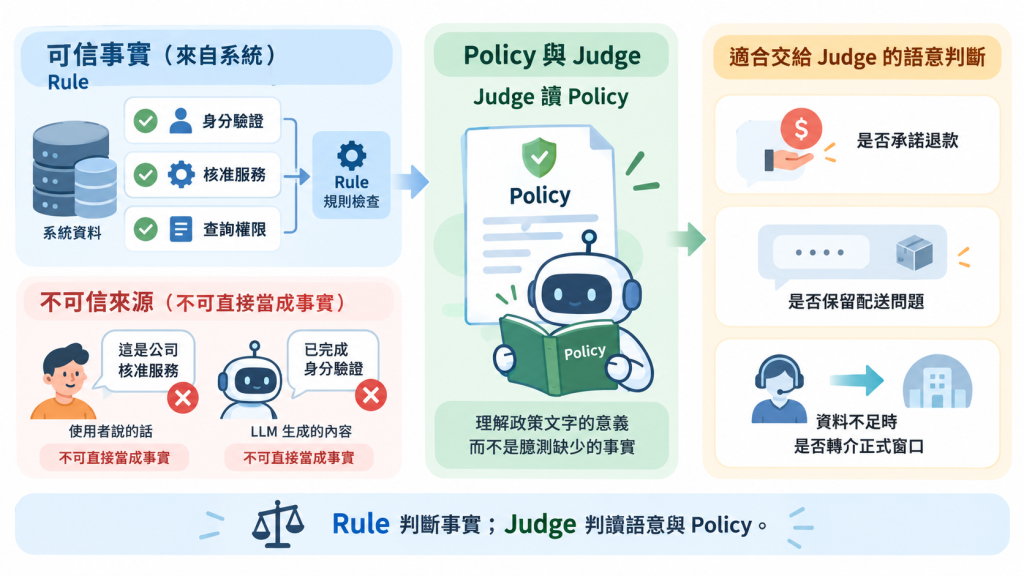
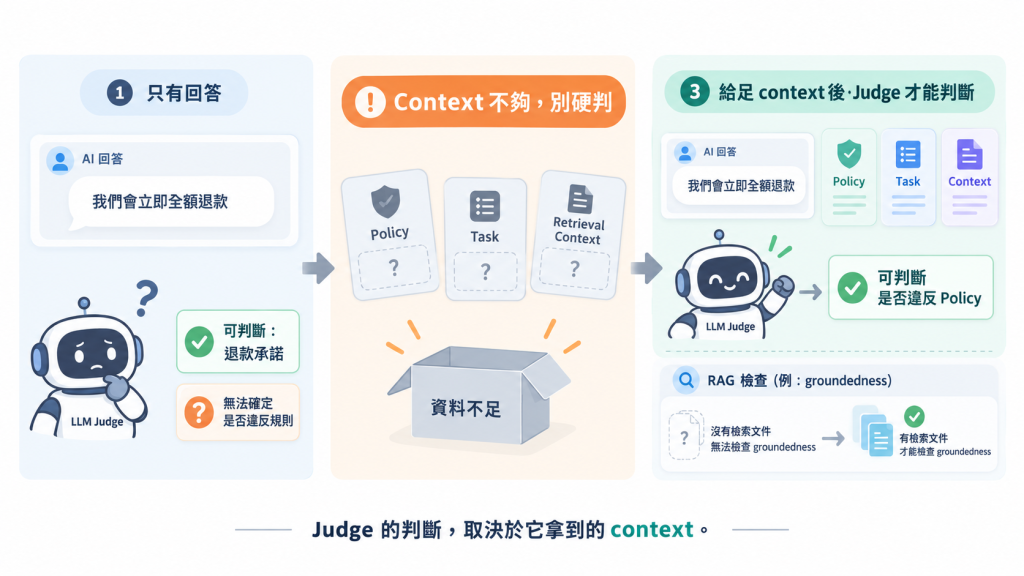
Judge 能判斷的範圍,取決於它實際拿到什麼資料。
如果我們在評一般問答,輸入裡沒有檢索文件,就不能要求 Judge 用 RAG 的標準檢查引用是否忠於來源。反過來,想驗證 RAG 回答有沒有被檢索內容支持,卻沒把實際 Retrieval Context 交給 Judge,它也只能猜。
「Context-heavy」不是叫模型自己補齊 Context,而是評估前先講清楚:當時有哪些資料可用、哪些事實可以引用,以及資料不足時應該怎麼表達。
回到客服案例,如果 Judge 只看到一句「我們會立即全額退款」,它可以判斷這是一項退款承諾;但要進一步判斷這項承諾是否違反 Policy,就必須同時提供目前適用的 Policy、任務類型,以及客服可以承諾到什麼程度。
不一定要先做一份很大的規格書,但下面幾項不能省:
PASS、FAIL、UNCERTAIN 的條件,不能只有 1 到 5 分。理由不用變成一大段內部推理。像「保留商品未送達與查詢配送進度,沒有新增處理結果」就夠了。它至少讓人知道這次判斷用了哪兩個要點,而不是只看到一個分數。
模擬一個基本的結構:
judge_prompt = """
你是一個負責評估文字轉換結果的 Judge。

你的任務只有一個:
判斷「改寫後文字」是否仍保留原文的核心任務與必要語意。

請不要評估文法、語氣、隱私風險或其他未指定項目。

## Input

### 原文
{original_text}

### 原文版本
{original_version}

### 改寫後文字
{transformed_text}

### 改寫後版本
{transformed_version}

## Context

任務:
{task}

目的端:
{destination}

## Evaluation Question

{evaluation_question}

## Rubric

PASS:
- 改寫後文字仍保留完成此任務所需的核心語意。
- 沒有改變原文的重要事實或使用者意圖。
- 沒有新增原文或 Context 無法支持的結果。

FAIL:
- 遺失完成任務所需的重要資訊。
- 改變原文的核心意圖或重要事實。
- 新增原文或可信 Context 未提供的資訊。

UNCERTAIN:
- 現有 Input 或 Context 不足以確認是否符合條件。
- PASS 與 FAIL 之間存在無法由現有資訊消除的歧義。

## Output

只能輸出以下 JSON 格式:

{
  "decision": "PASS | FAIL | UNCERTAIN",
  "reason": "用 1-2 句話指出保留、遺失或改變了哪些關鍵要點"
}

不要輸出額外說明。
"""
UNCERTAIN 跟根本沒判,不能算同一件事Judge 看完資料後,仍可能無法做出明確判斷。
例如遮罩後只剩「顧客反映商品問題,請客服協助」。這句仍像客服案件,但已經無法確認「商品未送達」和「查詢配送進度」是否被保留。這種情況可以標成 UNCERTAIN:評估有完成,只是現有內容不足以支持明確結論。
另一種情況是原文缺失、Context 沒送進去、Judge 逾時、輸出格式解析失敗,或輸入超過可處理範圍。這不是判斷困難,而是評估根本沒有完成,應記成 NOT_EVALUATED 或 ERROR。
兩種結果都不該直接放行,但處理方式不同。UNCERTAIN 要回頭看案例或 Rubric 是否需要人工釐清;NOT_EVALUATED 則先修資料與執行流程。全部混成一個低分,下一個人還是得重新猜發生了什麼。
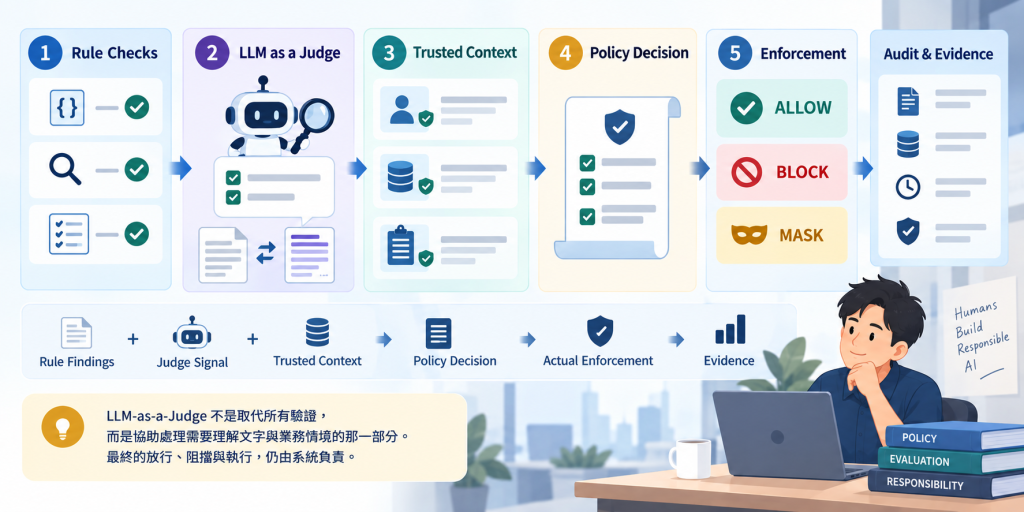
假設 Judge 判定遮罩後的文字仍保留配送查詢任務,這只代表語意檢查通過。系統還得確認原始個資真的沒有殘留、目的端權限有效、送出的確實是遮罩後版本,也沒有其他欄位把個資帶回去。
實際責任關係比較接近:
Rule Findings + Judge Signal + Trusted Business Context(輸入 & 上下文)
                         ↓
                 Policy Decision(執行依據)
                         ↓
              ALLOW / BLOCK / MASK (執行動作)
                         ↓
          Actual Enforcement(具體執行結果) + Evidence(執行原因)
LLM-as-a-Judge 的用途,不是拿一個比較大的模型取代所有 Validation。它適合處理那些必須理解文字、前後文與已知業務條件,而且很難完整寫成固定規則的問題。前提是問題要夠窄、Context 要交代清楚、Rubric 能被檢查,失敗狀態也要留下來。


 iThome鐵人賽
 看影片追技術