
「如果連記憶都無法 shared,那這跟未簽約的 NPC 有什麼兩樣?!」
昨天雖然成功在 ChromaDB 裡存了莉莉 Agent 的 Lore(設定集)和我討厭香菜、要考期末考的紀錄,但那些資料如果只是躺在 Vector DB 裡冷卻,Gemini 依然只是個「初次見面,請多指教」的金魚腦 AI。這就跟好感度明明滿了,結果劇情打回第一話一樣令人崩潰!
今天的任務就是把它們「串起來」!打造出一套專屬於陪伴型 Agent 的記憶檢索迴路:
Context(背景資訊),動態插入到給 Gemini 的 system_instruction 中!rag_builder.py)建立一個 rag_builder.py,專門處理「檢索 ⇒ 組裝 Context」的邏輯。這樣做的好處是程式碼很乾淨,未來不論切換什麼角色(莉莉或其它 Agent),這套 Prompt 組裝器都能通用!
import rag_memory

def build_rag_context(user_input: str) -> str:
    """根據使用者的輸入,自動檢索角色設定與使用者記憶,並組裝成 Prompt 補充包"""

    # 向 ChromaDB 檢索最相關的 1-2 條資料
    retrieved_lores = rag_memory.query_character_lore(user_input, n_results=1)
    retrieved_memories = rag_memory.query_user_memory(user_input, n_results=1)

    context_parts = []

    # 組合角色設定片段
    if retrieved_lores:
        lore_text = "\n".join([f"- {lore}" for lore in retrieved_lores])
        context_parts.append(f"【檢索到的角色相關設定】:\n{lore_text}")

    # 組合對使用者的記憶片段
    if retrieved_memories:
        memory_text = "\n".join([f"- {mem}" for mem in retrieved_memories])
        context_parts.append(f"【你關於該使用者的長期記憶】:\n{memory_text}")

    if not context_parts:
        return ""

    # 拼裝成乾淨的 Context 區塊
    full_context = "\n\n".join(context_parts)
    return f"--- [RAG 檢索輔助記憶] ---\n{full_context}\n請結合上述記憶資訊,以符合人設的方式自然回應。"
app.py 中整合 RAG 對話閉環接著回到 Streamlit 主程式 app.py,把這套 RAG 邏輯插進發送訊息的生命週期裡。這就跟在戰鬥中開啟「動態記憶注入」的主動技能一樣:
try:
    intent = router.classify_intent(client, user_input)

    if intent == "CHAT":
        delta = evaluator.evaluate_emotion(client, user_input)
        st.session_state.fsm.update_affection(delta)

        # 取得當前 FSM 狀態對應的動態 System Instruction
        base_instruction = st.session_state.fsm.get_system_instruction()

        # --- RAG 記憶檢索與 System Instruction 疊加 ---
        # 觸發 RAG 檢索:自動尋找相關記憶(查不到相關內容時會回空字串)
        rag_context = rag_builder.build_rag_context(user_input)

        # RAG 疊在 system_instruction 上,而不是塞進訊息本文。
        # 因為 send_message 送出去的內容會永久留在 chat history 裡,
        # 塞進本文的話那些「系統輔助訊息」會跟著每一輪重送、
        # 也會被存進 Firestore 汙染對話紀錄;
        # system_instruction 則是每輪獨立覆寫,不進 history
        final_instruction = base_instruction + ("\n\n" + rag_context if rag_context else "")

        response = st.session_state.chat.send_message(
            user_input,
            config=types.GenerateContentConfig(system_instruction=final_instruction)
        )
        ai_reply = response.text
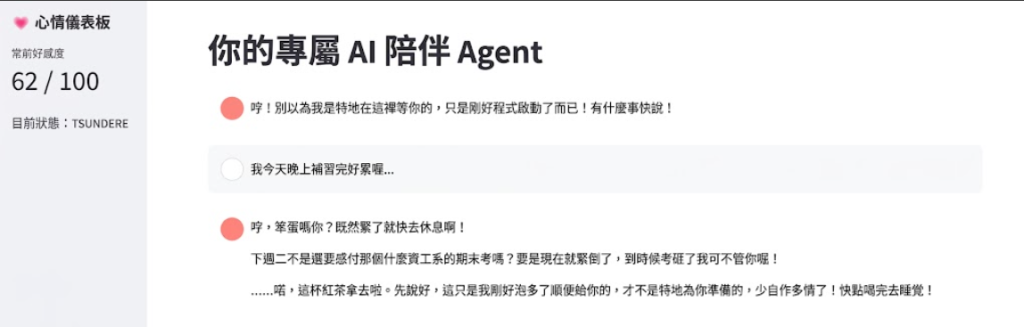
我輸入:「我今天晚上補習完好累喔…」
背景運作:RAG 自動檢索出 使用者在下周二 有資工系的期末考,最近壓力很大。
莉莉回應:
「哼,笨蛋嗎你?既然累了就快去休息啊!下週二不是還要應付那個什麼資工系的期末考嗎?要是現在就累倒了,到時候考砸了我可不管你喔!……喏,這杯紅茶拿去啦。先說好,這只是我剛好泡多了順便給你的,才不是特地為你準備的,少自作多情了!快點喝完去睡覺!」
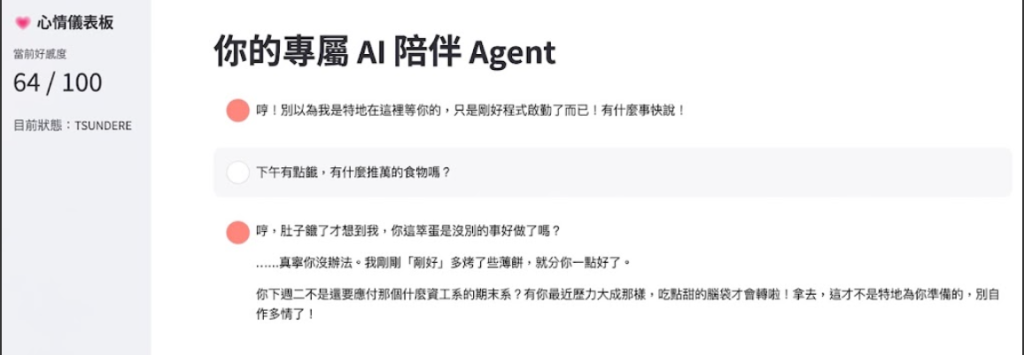
我輸入:「下午有點餓,有什麼推薦的食物嗎?」
背景運作:RAG 自動檢索出 莉莉非常擅長製作各種甜點與手工烘焙,特別是烤薄餅。
莉莉回應:
「哼,肚子餓了才想到我,你這笨蛋是沒別的事好做了嗎?……真拿你沒辦法。我剛剛「剛好」多烤了些薄餅,就分你一點好了。你下週二不是還要應付那個什麼資工系的期末考?看你最近壓力大成那樣,吃點甜的腦袋才會轉啦!拿去,這才不是特地為你準備的,別自作多情了!」
今天在調試 RAG 閉環時,我踩到了兩個極度隱蔽但傷害力極強的「天坑」:
辛苦算好了 final_instruction 與 prompt_with_rag,結果呼叫 send_message 時卻一個都沒帶到,訊息送的是原始 user_input,config 帶的還是舊的 current_instruction(而且 base_instruction 還重複呼叫了相同的 function)。
每輪默默花了 2 次 Embedding API 額度去查向量庫,AI 依舊失憶且完全不會報錯,查 bug 查到懷疑人生!
千萬別把 RAG 記憶用字串接在 f"{user_input}\n\n(記憶:...)"後面直接送出去。send_message 送出的字串會永久留存在 SDK 記憶體的 chat.history 中。
如果塞進本文,聊到第 5 輪時,模型還會看到前 4 輪拼接的舊記憶,導致 Context 長度與 Token 數量暴漲,且回答容易被過期檢索干擾。RAG 本來就是每輪動態查的,放進每輪獨立覆蓋、不進 history 的 system_instruction 才是正確姿勢!


 iThome鐵人賽
 看影片追技術