
當 Pod 被啟動之後,有時並不代表它已經做好準備,可能設定檔可能還沒載入,也可能下游 API 暫時不能用,並且做相關的處理(例如 Pod 重啟)
但換句話說,暫時性、瞬間的故障也不一定要重啟整個 container,而這就是設計 Probe 的一些重點。
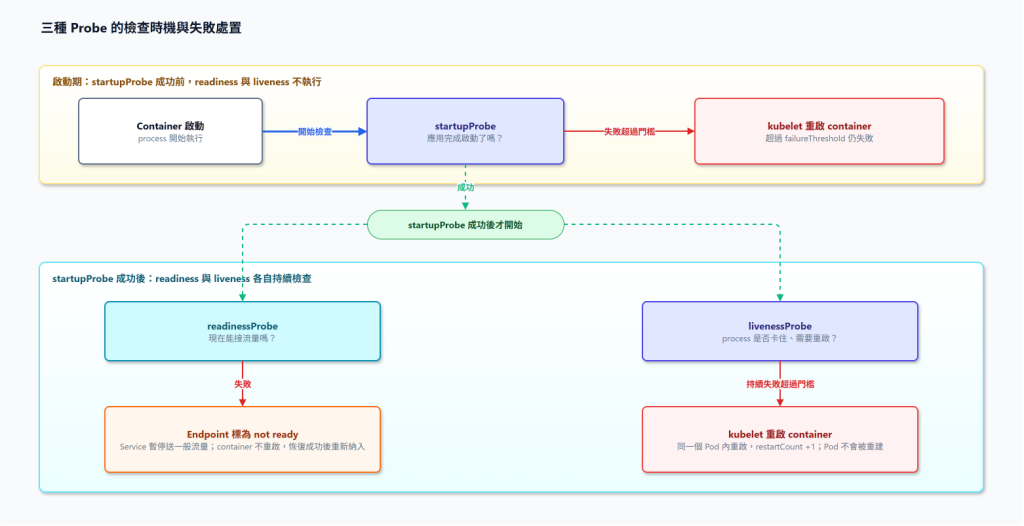
| Probe | 負責確認的點 | 失敗後的處理 |
|---|---|---|
| startupProbe | 應用完成啟動了嗎? | 超過門檻仍失敗,重啟 container |
| readinessProbe | 現在能接流量嗎? | Pod 暫時不列為 ready endpoint |
| livenessProbe | process 是否卡住、需要重啟? | 超過門檻仍失敗,重啟 container |
這些 Probe(探針) 是有一些優先順序性的。
有 startupProbe 時,liveness 與 readiness 會等它成功後才開始。
failureThreshold × periodSeconds 可以給啟動時間較長的程式一個緩衝時間,但並不是越大越好,必須依實際啟動時間去確認真實的啟動時間。
readiness 會持續偵測,當 Pod 暫時異常時,Service 會停止把一般流量導向該 Pod。
liveness 會聚焦在 Pod 本身是否能夠自行恢復。
假設 API 提供 /health/live 與 /health/ready,並監聽名為 http 的 port,可先在 Day 14 的 container 底下加入:
startupProbe:
  httpGet:
    path: /health/live
    port: http
  periodSeconds: 5
  failureThreshold: 24
readinessProbe:
  httpGet:
    path: /health/ready
    port: http
  periodSeconds: 5
  failureThreshold: 2
livenessProbe:
  httpGet:
    path: /health/live
    port: http
  periodSeconds: 10
  failureThreshold: 3
這些數字只是 lab 起點,應用若沒有對應 endpoint,probe 只會一直失敗。前端 nginx 的 /health 也應明確回應健康狀態,避免 SPA fallback 把任何不存在的路徑都回成 index.html 和 HTTP 200,製造假陽性。
驗證時一起看 Pod、EndpointSlice、Event 與 restart count:
kubectl -n team-a describe pod <Pod名稱>
kubectl -n team-a get endpointslices -l kubernetes.io/service-name=api-a -o yaml
kubectl -n team-a get pod <Pod名稱> -o jsonpath='{.status.containerStatuses[*].restartCount}'
若已實作上述 health endpoint 與三種 probe,可在隔離的 lab 中每次只把其中一種 path 改成不存在的路徑,比較失敗後的行為:
readinessProbe:在 startup 成功後,Pod 會變成 NotReady,該 Pod 不再是 Service 的可用端點;若沒有其他 Ready Pod,Service 就暫時沒有可用端點。container 不會單憑 readiness 失敗而重啟。livenessProbe:只改錯它的 path,且 readiness 仍成功時,Pod 在 liveness 達到失敗門檻前可能仍會接到流量;達門檻後 kubelet 會重啟 container,該 Pod 的 restartCount 會增加。若錯誤持續造成反覆重啟,才可能看到 CrashLoopBackOff。startupProbe:若從啟動時就檢查錯誤的 path,readiness 與 liveness 都不會開始,Pod 也無法 Ready;超過 startup 的失敗門檻後,kubelet 會重啟 container。每次觀察 Pod Event、EndpointSlice 與 restartCount 後都要把 path 改回來,確認新 Pod 恢復 Ready,再測下一種。這些是故障注入的預期結果;目前本系列的最小 demo 只提供 /health,尚未實作上述 endpoint 與 probe,不能直接用現有 demo 重現。專案先前曾在受控驗證中暫停應用 process,實際觀察到 Pod 由 Ready 轉成 NotReady;liveness 持續失敗後才觸發重啟。排障時先看是哪個 probe 失敗,別只看 Running 或 CrashLoopBackOff。


 iThome鐵人賽
 看影片追技術