
「CPU 用很高,為什麼 Pod 沒增加?」初次設定 HPA 時,很容易把 request、limit、usage 混在一起。
它們其實是處理不同面向問題:
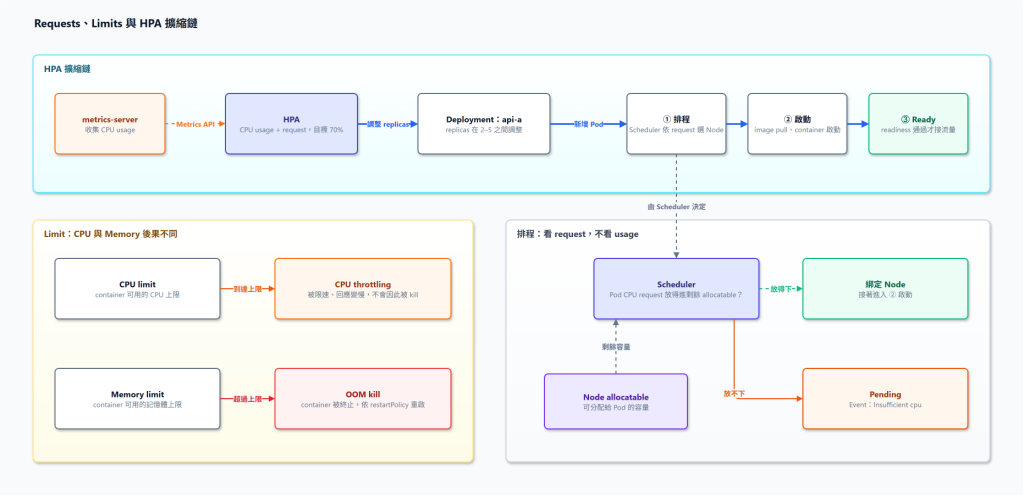
例如替 API 設定:
resources:
  requests:
    cpu: 100m
    memory: 128Mi
  limits:
    cpu: 500m
    memory: 256Mi
Scheduler 透過 request 判斷 Node 是否有空間放 Pod。
若 Pod 一直 Pending,Event 出現 Insufficient cpu,要看 request 與 Node allocatable;
確認是否為 Node 的資源不夠被拿去運作 Pod 了,而這跟 Pod 目前吃多少 CPU 是兩件事。
要用 CPU使用量作為 HPA 的規則,還需要可用的 resource metrics,以及 container 設定 CPU request。
下面把擴展規則設為 CPU request 的 70%,副本介於 2 到 5:
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: api-a
  namespace: team-a
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: api-a
  minReplicas: 2
  maxReplicas: 5
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 70
套用前先跑 kubectl top pods -n team-a 與 kubectl get --raw /apis/metrics.k8s.io/v1beta1,確認 metrics API 有資料。
k3d 環境中常有預設 metrics-server,如果沒有或是其他平台的話,也可以透過安裝 Prometheus 這種服務去搜集整個叢集服務的 Metric。
HPA 接手後,將 Day 14 manifest 裡手動維護的 spec.replicas 移除,避免後續重複 apply 把 HPA 調整過的數字蓋回去。
觀察時用 kubectl -n team-a describe hpa api-a,看目前 metrics、desired replicas、條件與 Event。
新 Pod 尚未 ready 或暫時缺 metrics 時,HPA 會採保守計算;擴出去的 Pod 也需要 image pull、啟動與 readiness 時間。
負載一降不會讓這些擴展出去的 Pod 立刻下架,中間還是有一些緩衝時間,當叢集確認目前負載已經過一段時間都不處於設定好的 HPA 規則後才會開始中斷擴展出去的 Pod 服務。
我在實際處理專案時,曾透過拉高 CPU 負載來驗證 HPA 是否正常運作,觀察到副本由 3 顆擴到 5 顆,停止負載後,持續一段時間才再回到 3 顆,中間大概五分鐘。
不過這樣只能驗證 HPA 的功能有正常運作中,POD 也有正常擴充並啟動,也能基本確認 Node 的資源是夠用的,不會因為沒資源而導致沒有擴充成功,後續也會針對如何做壓力測試等議題來深入說明。


 iThome鐵人賽
 看影片追技術