iT邦幫忙

2026 iThome 鐵人賽

DAY 15
0
佛心分享-SideProject30

營養師想做一個飲食建議產品系列 第 15 篇

Day15 - LLM 在 AI Diet 裡負責什麼、不負責什麼?

  • 分享至 

  • xImage
  •  

上一篇講完「為什麼」要用生成式 AI,這篇要更具體一點:AI 說要負責「理解語意」,但具體在這個系統裡,它實際上做了什麼、又刻意不做什麼?

🧱 地基概念

什麼是「呼叫一次 LLM」?

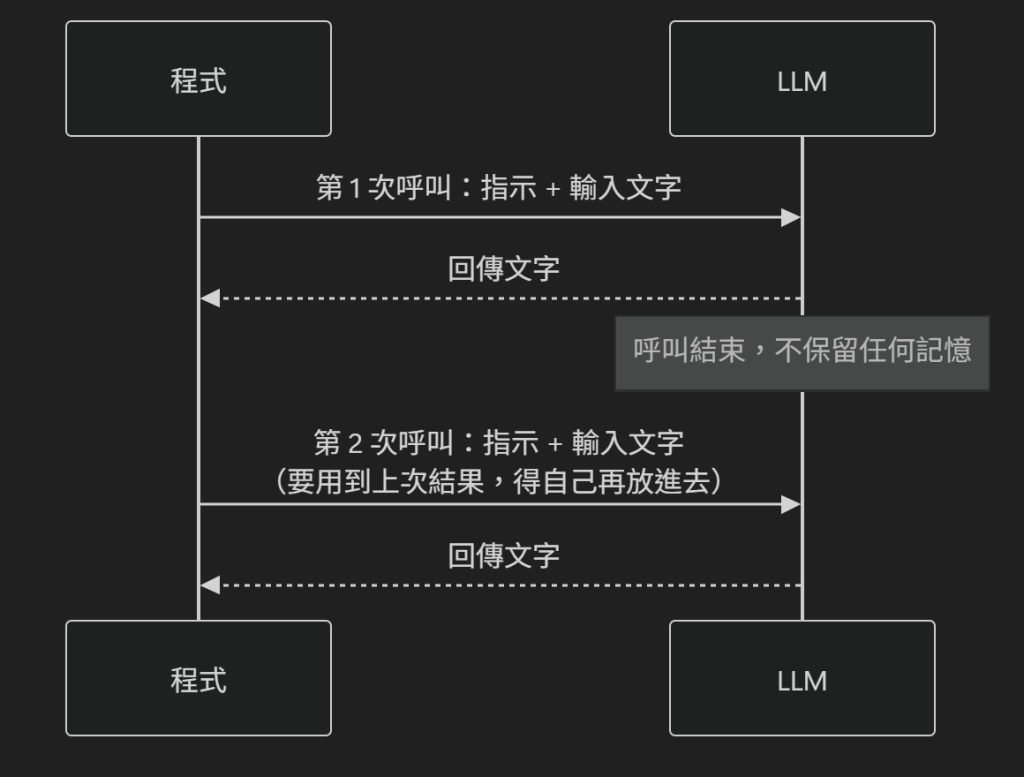
跟 LLM 互動的基本模式很單純:送一段文字(連同要它做什麼的指示)過去,它回傳一段文字——這一來一回,就是「呼叫一次」。每次呼叫都是獨立的,模型不會自己記得上一次呼叫發生過什麼事,除非把之前的內容也放進這次的輸入裡。

設計鐵律具體長怎樣

Day5 講了這個專案的設計鐵律:AI 不算營養數字。這篇要把這句話拆成程式碼裡實際發生的事——LLM 在這個系統裡,實際上只有兩種呼叫(其中第二次呼叫最多會重試一次)。
https://ithelp.ithome.com.tw/upload/images/20260928/20183959z6LmmFEpnv.png

第一次呼叫:freeText → DietaryAnalysis

  • 輸入:使用者的自由文字
  • 輸出:固定結構的 JSON(用餐型態、飲食觀察、外食型態、口味偏好)
  • 它不負責的事:不換算任何食物份量、不推算熱量,這步只做「語言理解」

第二次呼叫:DietaryAnalysis + 營養計算結果 + 候選食物清單 → Menu

  • 輸入:呼叫 “第一次” 的結果、Lambda 已經算好的六大類份數目標、從 Food DB 篩出的候選食物
  • 輸出:一份菜單,每一餐選用哪些候選食物(referencedFoodIds)、搭配一句自然語言建議
  • 它不負責的事:不算選中食物實際換算成幾份——這一步呼叫結束後,Lambda 會再用食物代換表公式重新精確計算一次,覆蓋掉 AI 自己的估算
  • 重試:如果其他餐次的份數加總超出當日目標,Lambda 會帶著超支資訊重新呼叫一次
  • 補齊:最後用「目標 − 其他餐次真實加總」的餘額,直接覆蓋「緩衝餐」的份數(定義見下方),保證加總對得上

什麼是「緩衝餐」?

真實食物的份數是固定值(一個便當就是固定幾份,沒辦法微調成剛好 0.3 份),AI 選完食物後,全天加總很難剛好等於目標。所以程式會指定一餐當「緩衝餐」,專門吸收這個落差:

  • 選哪一餐:優先順序是宵夜 → 早餐 → 晚餐 → 午餐,取當天實際有的第一餐(宵夜最不是「正式一餐」,彈性最高)
  • AI 只給大方向:這一餐不選具體食物,建議也保持清淡
  • 程式覆蓋份數:這一餐的每一類份數 = 目標 − 其他餐次的真實加總(最低為 0,四捨五入到 0.5 份),建議文字也由程式直接產生
  • 限制:只能補不足、不能扣超支(份數不會低於 0),所以才需要前面那個「超支重試」;油脂與堅果類不參與這個機制

中間所有「數字」相關的計算,全部發生在這兩次呼叫之外:BMR/TDEE/三大營養素/六大類份數目標的計算在第一次呼叫之前,試算食物的真實份數的double check計算在第二次呼叫之後。Food DB 目前還沒有介紹到,之後會再說明食物資料庫這一塊。

小結

LLM 在這個架構裡,說到底只做兩件事:把非結構化文字變成結構化資料,以及在有限選項裡做出貼近使用者需求的選擇——這兩件事剛好都是規則邏輯很難做、但語言模型天生擅長的地方;反過來,「算數字」是規則邏輯的強項、語言模型的弱項。這條界線劃在這裡,不是隨便決定的,是刻意讓每個工具做它真正擅長的事。下一篇要介紹的是這兩次呼叫實際打去的地方——Amazon Bedrock。


上一篇
Day14 - Generative AI : 讓後端開始"理解"使用者
下一篇
Day16 - Amazon Bedrock 是什麼?
系列文
營養師想做一個飲食建議產品 共 19 篇
圖片
  熱門推薦
圖片
{{ item.channelVendor }} | {{ item.webinarstarted }} |
{{ formatDate(item.duration) }}
直播中

尚未有邦友留言

立即登入留言