
上一篇講完 LLM 在這個系統裡的兩次呼叫,這篇要介紹這兩次呼叫實際打去的地方——Amazon Bedrock。
Bedrock 是什麼?
想要用生成式 AI,直覺的作法是去串某家AI 公司的 API——申請一把 API Key,貼進程式碼(或環境變數),用 HTTP 打過去。但若有使用到AWS的話,其實官方有提供另一個平台給使用者,也就是Amazon Bedrock:把各家基礎模型(涵蓋Anthropic、Meta、Amazon 等自家的模型)當成 AWS 內部的一個服務,用 IAM 授權,不需要另外管理金鑰。
之前在 Day12 講 IAM 時有提過了:Lambda 的執行角色被授權 bedrock:InvokeModel,程式碼裡不會出現任何 API Key 字串,大幅降低外洩風險(因為根本沒有可以外洩的密鑰),權限管理跟其他 AWS 服務(S3、CloudWatch)也是用同一套機制,整體使用上就像去菜市場挑選食材一樣,在 Amazon Bedrock 挑選想使用的模型。
Bedrock 不只是「呼叫模型」
這個專案用到的只是 Bedrock 最基礎的功能——InvokeModel:送一段文字進去、拿一段文字出來。但 Bedrock 其實是一整套平台,還有幾項這次沒用到、但值得知道的功能:
因為此專案的需求本來就很單純(把自由文字變成結構化資料、跟從Food DB裡挑選食物),用最基礎的 InvokeModel 就夠用了,沒有用到 Knowledge Bases 跟 Agents 這兩項功能。至於「這兩個工具到底適不適合這個專案」,留到 Day30 回顧整個專案時再詳細談(到那時候才有完整的 Food DB 結構與設計鐵律可以對照)。
我後來選擇的模型是 Anthropic 的 Haiku 4.0 模型,以下分享一些遇到的”採雷經驗”跟”要到主控台哪裡查詢AI設定”。
踩雷一:model ID 不能直接打,前面要多加一段前綴
一開始我直接把 model ID(例如 anthropic.claude-sonnet-5)填進程式碼呼叫,結果被拒絕。後來才發現,Claude 系列模型不能這樣「裸的」直接叫,前面要多加一段字,變成 global.anthropic.claude-sonnet-5 或 jp.anthropic.claude-haiku-4-5-20251001-v1:0 這種格式——這個東西叫「跨區域推論設定檔」,聽起來很專業,但白話講就是:Bedrock 不讓你直接指定「打去哪一台機器」,而是幫你把請求分配到目前比較有空的區域去處理,避免大家都擠在同一個地方。這也連帶影響到 IAM 的權限設定要多開一種格式(inference-profile/*,Day12 有提到),少開就會被擋下來。
踩雷二:光有權限還不夠,模型本身要先「訂閱」
IAM 給了 bedrock:InvokeModel 的權限之後,我以為就能打了,結果還是被拒絕。原因是 Anthropic 的模型不是 AWS 自己做的,是透過 AWS 的「模型市集」(Marketplace)上架的——這代表除了 AWS 給你的權限之外,帳號還要額外去 Bedrock 主控台,對這個模型完成一次「訂閱」,才算真正拿到使用資格。這步是帳號層級的設定,跟 IAM 權限是兩件不同的事:權限沒給,會擋在 AccessDenied;訂閱沒做,打的時候會直接被拒絕。
我設定的 AI,在 AWS 主控台哪裡看得到?
如果單純去 Bedrock 主控台找,是找不到一頁叫「我的 AI」的,原因是 Bedrock 是隨叫隨用的模型服務,所以我們並沒有建立任何「AI 資源」,只是讓 Lambda 去呼叫它。所以要看Bedrock的東西的話,會分散在不同服務裡,以下就一起來看看吧:
prompt 跟呼叫邏輯:Lambda → Functions → 選擇該方法
prompt 是寫在程式碼裡的,不是設定在 Bedrock 上,第一章截圖為程式碼裡的prompt,第二張截圖為部署上雲端後的樣子。
(截圖1 - 程式碼裡面的樣子)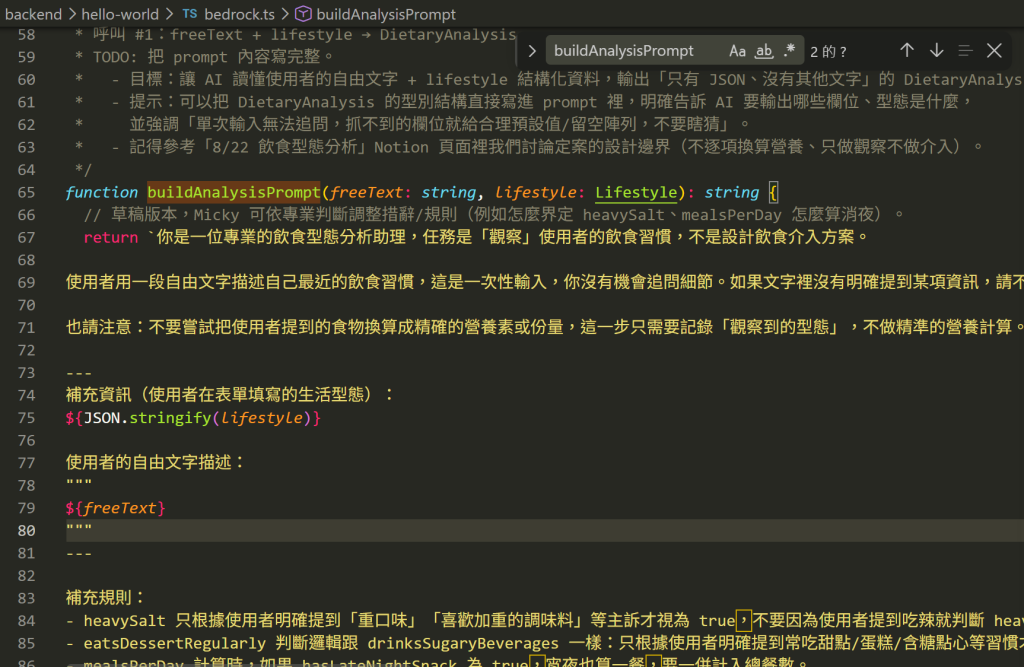
(截圖2 - 上雲部署後的樣子)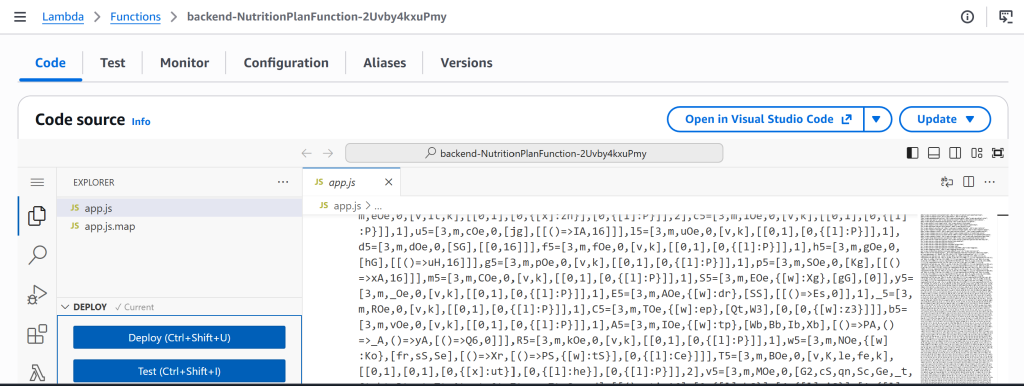
LLM模型:
專案使用的模型是寫死在檔案程式碼裡的 model ID 字串(截圖1);
該去哪裡挑選模型? 查看模型資訊? 可以到 Bedrock 主控台的模型目錄(截圖2)
(截圖1 - 本次專案使用的LLM模型,model ID 是從Bedrock主控台複製下來的,要到 Bedrock → Cross-region inference去找model ID )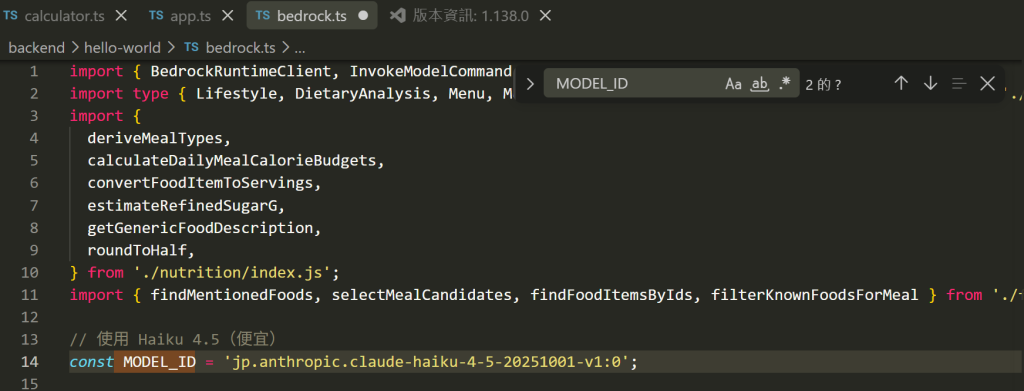
(截圖2 - 這裡本身可以有許多LLM模型的選用)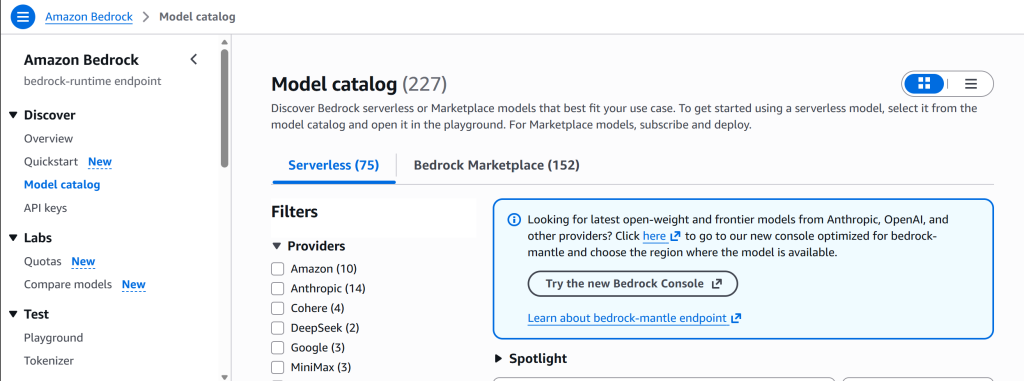
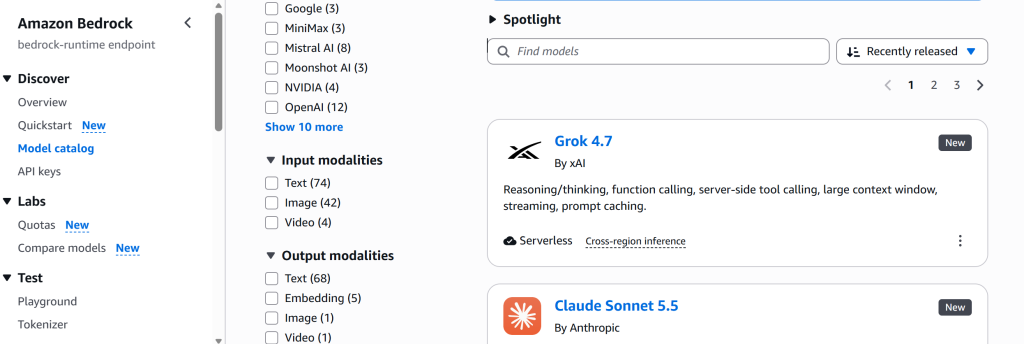
呼叫權限:Lambda → Configuration → Permissions → 執行角色
就是 Day12 講的那條 bedrock:InvokeModel。bedrock : InvokeModel授權在 inference-profile/* 和 foundation-model/anthropic.claude-* 兩種 ARN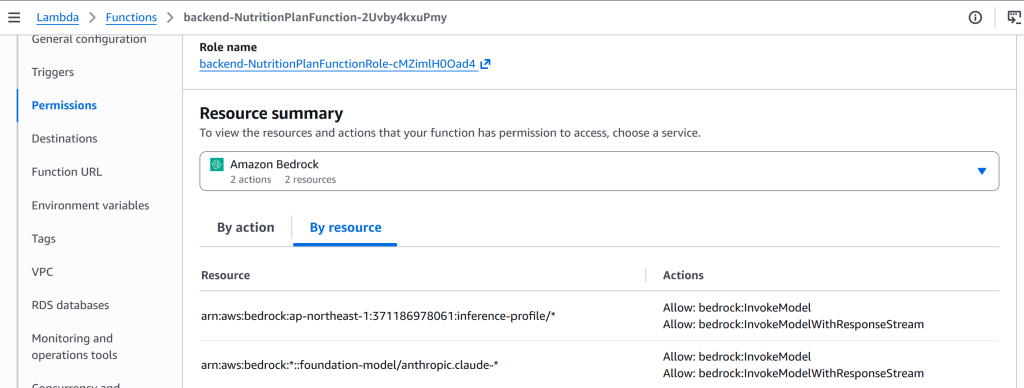
實際跑了什麼:
每次請求印出的 log 都在這裡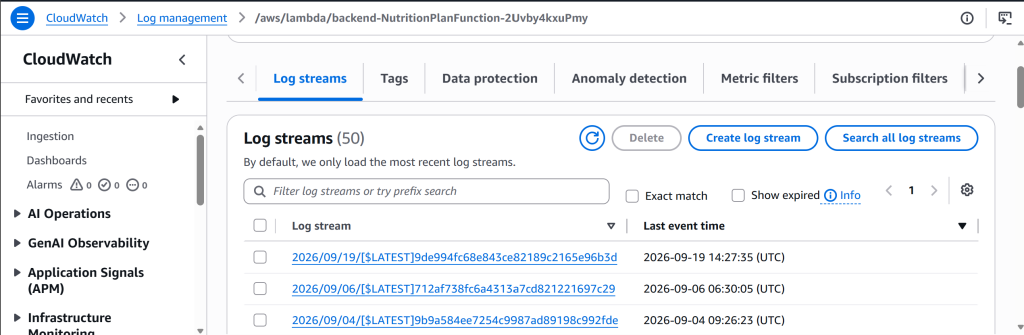
呼叫次數跟 token 用量:CloudWatch → Metrics → AWS/Bedrock
可以看到 Invocations、輸入/輸出 token 數,也就是每次呼叫大概花多少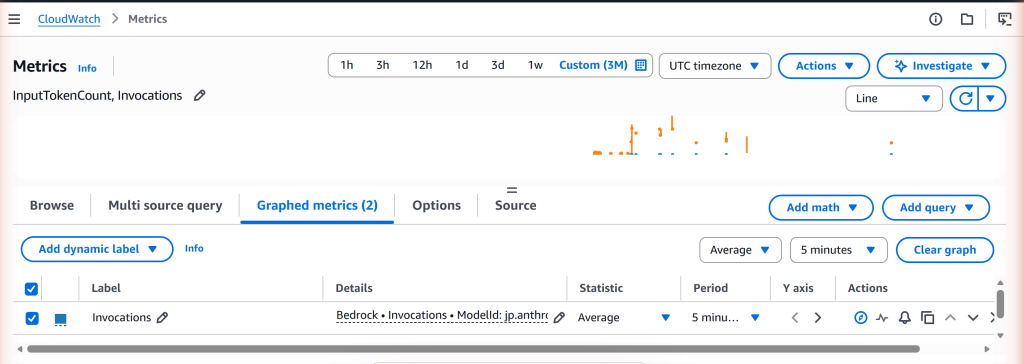
真正的花費:Billing → Cost Explorer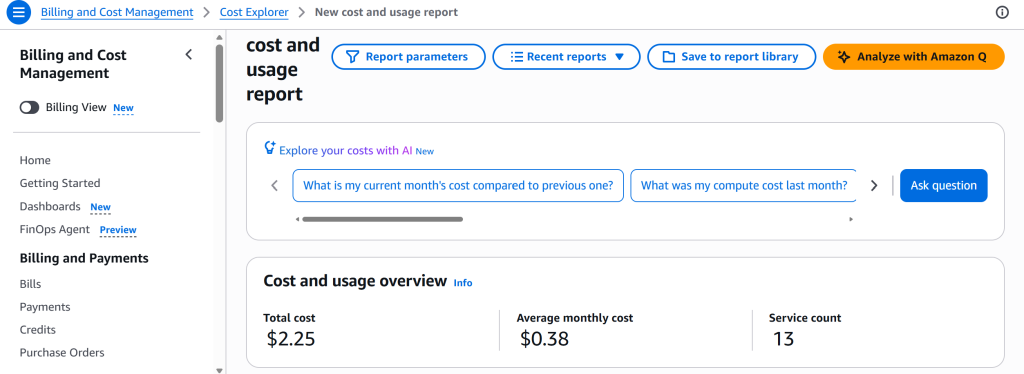
一句話總結:想看「跟 AI 講了什麼」去 Lambda,想看「實際發生了什麼、花了多少」去 CloudWatch 跟 Billing。
Bedrock 對這個專案來說,本質上解決的是「怎麼安全、低摩擦地用 AI」,平台選好、模型也叫得動了,下一篇要處理的是:怎麼跟這個模型「講話」,才能穩定拿到想要的結果。


 iThome鐵人賽
 看影片追技術