
昨天的發布包通過檢查,也能啟動了。但打包完成,就可以上 Production 了嗎?
一個人建立訂單、取消訂單,收到通知,看起來都正常。換成大家一起操作,回應會不會變慢?使用者等不及再按一次,會不會多發一份通知?如果一直有新訂單進來,記憶體又會怎麼變?
只看回應速度與錯誤率,很容易以為已經足夠。但這次補測,API 檢查全部通過,201 次取消卻只有 127 筆通知接收紀錄。這裡的「通知接收紀錄」,是接收通知的服務實際收到後,記下通知 ID 與收到時間,供我們逐筆核對;不代表使用者已讀。
取消請求成功了,整件工作卻還沒完成。 這個落差,正是上線前要查清楚的事。
這就是今天做壓測的目的。我拿 Day 14 的同一份發布包,請 Claude Code 協助盤點風險、寫 k6 腳本,再用本機 Grafana 看實際結果。先把上線判斷需要的依據補起來,不從一句「幫我壓看看」開始。
Day 6 問怎樣才算完成,Day 9 釐清需求,Day 10 把非功能性需求放進設計。到了上線前,這些約定得變成可以測的條件。
例如「取消訂單要快」,還不夠寫壓測。我得知道:平常多少人操作?尖峰集中多久?使用者可以等多久?通知晚到和重複寄送,哪一個會造成什麼影響?
這些答案不會全在 PM 或主管手上。
| 找誰一起確認 | 要補的答案 |
|---|---|
| PM/業務負責人 | 使用情境、尖峰來源、可接受等待時間與失敗影響 |
| RD/Tech Lead | 哪些資源共用、哪些動作不能重複、設計有哪些限制 |
| SRE/維運 | 現有流量、正式環境資源、SLO 與下游限制 |
| 服務 Owner | 沒達標時,延後、縮小範圍或接受哪些風險 |
有真實流量就從紀錄出發,沒有就把估計與待確認項目寫出來。第一次量到的數字是現況,不會自動變成大家可以接受的標準。 這也接回 Day 5:先把尺放好,不能跑完才挑一條會過的門檻。
我會把使用情境、要求與確認者留在 spec.md;
設計怎麼處理資源、通知與重試,放在 plan.md。
這次要測哪個版本、用什麼負載、多久、看什麼、何時停止,另外整理成 performance-test-plan.md。
這是本篇採用的檔名,重點是測試前有一份能一起確認的計畫。
這個教學服務沒有正式流量或公司 SLA,所以本輪先訂教學門檻:首次取消 p95 小於 250ms、HTTP 失敗率為零、行為檢查全部通過,而且預定工作不能漏送;若有漏送,還要分辨是 VU 不足、服務變慢或產生器資源限制。p95 表示約 95% 的樣本不超過這個時間;不是每一筆都低於它。
Day 10 畫圖是為了讓大家對設計有共同理解。現在把那張圖拿回來,就能討論:請求增加後,工作會經過哪些地方?哪裡可能等人、等鎖,或等下游?
我的做法是先釐清目標、對照架構盤點風險,再確認策略與接受條件,最後才產生腳本。Claude 可以提出草案,產品與技術負責人仍要確認承諾。
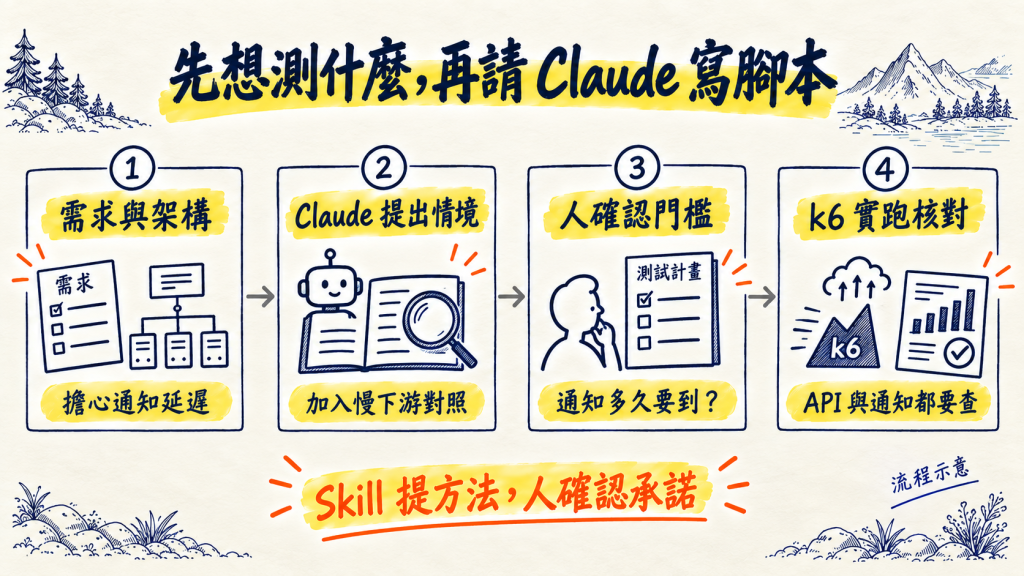
方法示意:Claude 提策略,人確認承諾;k6 量 API,通知接收紀錄由執行器另行核對。
這次先把取消路徑整理成文字,再請 Claude 對照這份發布包對應的 API、Domain 程式與壓測計畫查核:
訂單 API → 訂單狀態與取消規則 → 通知佇列 → 通知處理器 → 接收端
這次 Claude Code 有實際參與:它讀取兩份教學程式與計畫,回傳架構查核和可執行的 k6 腳本。它沒有取得修改或執行工具;收到腳本後,再由本機執行器啟動服務、跑測試、保存結果。
它指出了簡圖沒畫出的部分:日誌是同步寫入檔案,而且也有鎖。 只看 API 與通知的箭頭,很容易漏掉這段等待。
| 對照程式後要注意的地方 | 可以怎麼驗 |
|---|---|
| 不同訂單共用狀態儲存的鎖 | 增加不同訂單的操作頻率,觀察延遲 |
| 通知由背景處理器送出 | 同時看取消回應、佇列和實際接收紀錄 |
| 訂單保留在記憶體,沒有清除流程 | 持續建立訂單,對照資料量與記憶體變化 |
| 同步寫入日誌也可能等待 | 若延遲上升,再補查鎖等待與 I/O,不能直接認定根因 |
這些是程式查核得到的風險,不是已證明的瓶頸。原來三輪先測不同訂單的持續操作與短時尖峰;接著補慢下游對照。長時間資料累積不在本次驗證範圍。
換成自己的服務,可以先請 Claude Code 做這件事:
對照架構圖、實際程式、設定與非功能性需求,列出圖和實作不一致的地方。每個建議測試情境都指出它在驗哪個需求、哪個模組、什麼風險;缺少流量或接受門檻就列為待確認,不替我編數字。確認計畫後才產生腳本。
AI 幫忙把可能漏掉的路徑攤開,目標與接受條件仍要由負責的人確認。
這輪每次迭代都做四個動作:建立一張已付款、未出貨的新訂單,取消一次,再取消一次,最後查狀態。
第一次取消應轉換狀態並提出退款要求;第二次不再轉換,也不能新增通知。退款要求只是教學程式的旗標,沒有接金流,不會真的退款。
Day 14 已有同一張訂單的並行檢查。今天則是多張新訂單持續進來,每張順序重送取消。這兩種操作會碰到不同問題,不能拿其中一個替另一個背書。
先依風險選方法:
小負載確認腳本與量測;
尖峰測突然增加又退下來的流量;
長時間測資源是否逐漸累積。
如果想找容量上限,才需要繼續逐步加壓。不是每次都把所有測試跑一遍。k6 測試類型
本輪事前寫下三種設定:
| 情境 | 新工作進來的頻率 | 這次想確認什麼 |
|---|---|---|
| 小負載試跑 | 每秒 1 次迭代,20 秒 | 腳本、檢查與紀錄能不能對起來 |
| 短時尖峰 | 每秒 2 次、20 次、2 次,各 20、30、20 秒 | 負載突然增加與下降時,延遲和行為如何 |
| 短時持續負載 | 每秒 10 次迭代,120 秒 | 固定流量下的延遲、記憶體與通知狀況 |
一次迭代有四個 HTTP 請求,所以尖峰每秒 20 次工作,約對應每秒 80 個請求,不能寫成 20 RPS,也不代表 20 個同時在線的使用者。這裡用的是到達率模式,讓工作按計畫進來,再看系統是否接得住。
兩分鐘只叫短時觀察,不能叫長時間穩定性已驗證。真正的持續時間,要依活動長度、資料累積速度與要揭露的風險決定。
Claude 產生的腳本把門檻放進 thresholds;例如:
cancel_ms: ['p(95)<250'],
http_req_failed: ['rate==0'],
checks: ['rate==1'],
dropped_iterations: ['count==0'],
四行分別檢查首次取消延遲、HTTP 失敗、回傳內容,以及預定但沒能開始的工作。k6 會依門檻決定執行是否失敗;不能只看圖表判斷通過。k6 Thresholds
「發布包」就是已建置好、準備交付的程式與設定。這次直接啟動 Day 14 的 candidate-checked/package,版本為 delivery-hardening-local-r1,執行前後核對十個檔案的 SHA-256,不重新編譯另一份。
本機準備好 .NET 9、Python、k6 與 Docker,依操作附件啟動 Prometheus、Grafana 和指標轉送程式後,在專案根目錄執行:
python examples/sdlc-delivery/day15-lab/run-load.py my-spike --profile spike --k6 k6
my-spike 是新紀錄名稱,不能和既有資料夾重名;--k6 可換成本機執行檔路徑。這個入口會檢查發布包、啟動 API 與假通知接收端、呼叫 k6、對帳,再關閉本次服務。不是要求讀者手動貼一堆 Log 給 AI。
量測分成兩條路:k6 把請求指標送進 Prometheus;執行器每半秒讀取 API 的 /metrics,由本機轉送程式提供給 Prometheus。Prometheus 保存,Grafana 顯示。 通知 ID 則留在原始紀錄逐筆核對,不做成大量指標標籤。k6 Remote Write
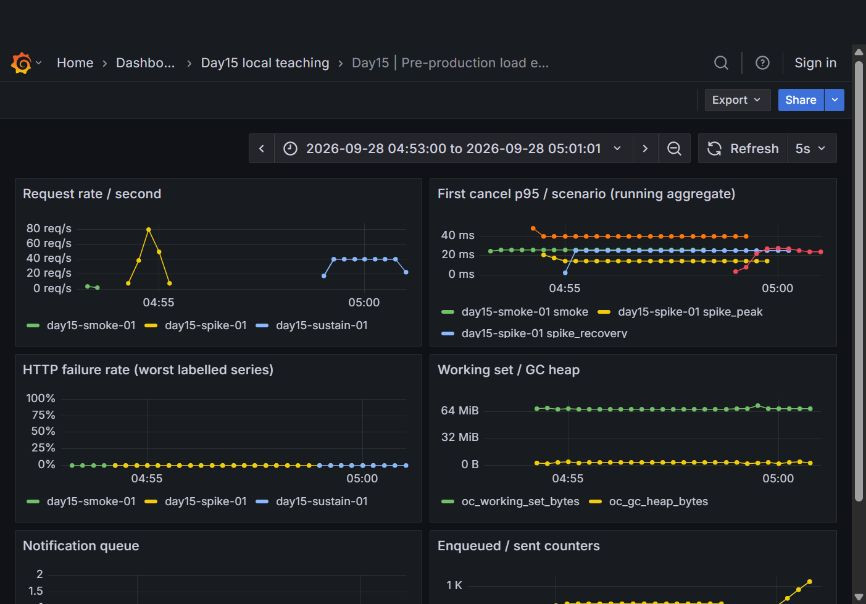
本輪實際儀表板,非示意圖。各輪重新啟動服務,因此計數器會歸零。p95 曲線是各情境累積統計,不是把不同情境的 p95 平均成整輪結果。
這一步也有踩到坑:小負載時,Windows 換行讓服務指標無法被 Prometheus 解析;改成 LF 後,後兩輪才接通。k6 原始結果和本機服務採樣仍有保存,不能把第一輪說成整條量測路都已成功。
另外,匯出的時間值與面板單位也要核對。我把取消延遲轉成毫秒顯示,整輪 p95 則以 k6 摘要為準。有 Dashboard,不代表尺就量對了。
| 情境 | 完成訂單/HTTP 請求 | 首次取消 p95 | 取消轉換/通知接收紀錄 |
|---|---|---|---|
| 小負載試跑 | 21/84 | 26.13ms | 21/21 |
| 短時尖峰 | 683/2,732 | 18.06ms | 683/683 |
| 短時持續負載 | 1,201/4,804 | 23.84ms | 1,201/1,201 |
數字取自各輪摘要與逐筆紀錄,不把「設定頻率乘時間」當實際完成數。到達率排程在時間邊界可能多開始一筆,這次就留下實際的 21、683、1,201。
三輪 HTTP 失敗率都是零,行為檢查全過,dropped_iterations 為零,發布包十檔雜湊也一致。尖峰這輪的 p95 比試跑低,只能描述觀察,不能推成負載越高越快。
我更在意的是通知:不只總數相同,還把每次狀態轉換、通知接收紀錄和 notify_sent 的通知 ID 逐筆比較,確認每個只出現一次。請求結束後最多等二十秒,讓非同步通知完成再對帳。本輪假接收端固定回 200,沒有驗下游失敗與重試。
把前面 Claude 列的四項風險拿回來,逐項對它這次有沒有被量到:
| 它事前指出的風險 | 這次量到什麼 | 算驗了嗎 |
|---|---|---|
| 不同訂單共用狀態儲存的鎖 | 三輪 p95 26.13/18.06/23.84ms,均低於教學門檻 | 未量測鎖等待,不能判斷鎖的影響 |
| 通知由背景處理器送出 | 通知 ID 逐筆對帳 21/683/1,201 全對,佇列深度 0–1(234 筆採樣) | 逐筆對帳未重複,截止時全部完成;採樣不能排除中間短暫堆積 |
| 訂單保留在記憶體,沒有清除流程 | 持續負載那輪工作集 58.9–71.7 MiB | 量到了,但沒驗成累積趨勢;兩分鐘看不出來 |
| 同步寫入日誌也可能等待 | 沒有收集 CPU、鎖等待與 I/O 指標 | 沒量到,它指的那一段完全沒有對應數字 |
通知完成有逐筆紀錄可以核對;鎖、記憶體與日誌等待,則還不能從這幾個數字判定根因。Claude 提出的風險,要有相應量測才能往下判斷。
但這三輪還有一個共同條件:接收端每次都立即回應。如果它變慢,前面的綠燈還能代表整件事完成嗎?
這輪換一個做法:載入 Grafana 官方的 k6-test-planner Skill(固定版本、附雜湊與載入紀錄),只給 Claude 教學需求與兩份程式,不給舊計畫與舊結果,請它重新提出策略。前面三輪是它讀我的計畫再產生腳本,這次是它自己規劃,兩次紀錄分開保存。安裝方式與版本見操作附件。
它列出的共用鎖與慢下游風險,前面已經看過;值得比較的是它建議怎麼驗,以及還漏了什麼。
| Claude 提出了什麼 | 我核對後怎麼處理 |
|---|---|
| 預先建單,單獨量首次取消 | 採用,讓負載集中在取消路徑 |
| 慢下游可能讓待送通知累積 | 選為補測情境,與立即回應的接收端對照 |
| 主要核對服務自己的送出紀錄 | 補上通知接收紀錄,逐筆核對通知 ID |
我原本就要求:不能只看訂單服務說「通知送出了」,還要核對接收通知的服務,是否真的收到每一筆。Claude 的計畫卻主要檢查送出紀錄,漏了接收端的核對。 Skill 能幫忙整理方法,但不能取代接受條件的核對。
我採用它的預先建單方式,再從它列出的慢下游風險選一組對照:同一份發布包,每秒首次取消 10 張訂單、持續 20 秒。一組立即回應,另一組刻意讓假接收端等待 300ms 才留下通知接收紀錄並回應。這個延遲是教學設定,不是正式環境數字。
腳本與執行器在策略確認後由我編寫、本機 k6 執行 : Skill 只出策略,沒有代跑測試。 兩組先寫好相同的 API 門檻,負載結束後最多等二十秒,再逐筆核對通知 ID。結果如下:
| 對照情境 | 首次取消 p95 | API 檢查 | 取消轉換/截止時通知接收紀錄 | 整體結果 |
|---|---|---|---|---|
| 接收端立即回應 | 5.99ms | 全部通過 | 201/201 | 通過 |
| 接收端延遲 300ms | 13.37ms | 全部通過 | 201/127 | 通知未在期限內完成,未通過 |
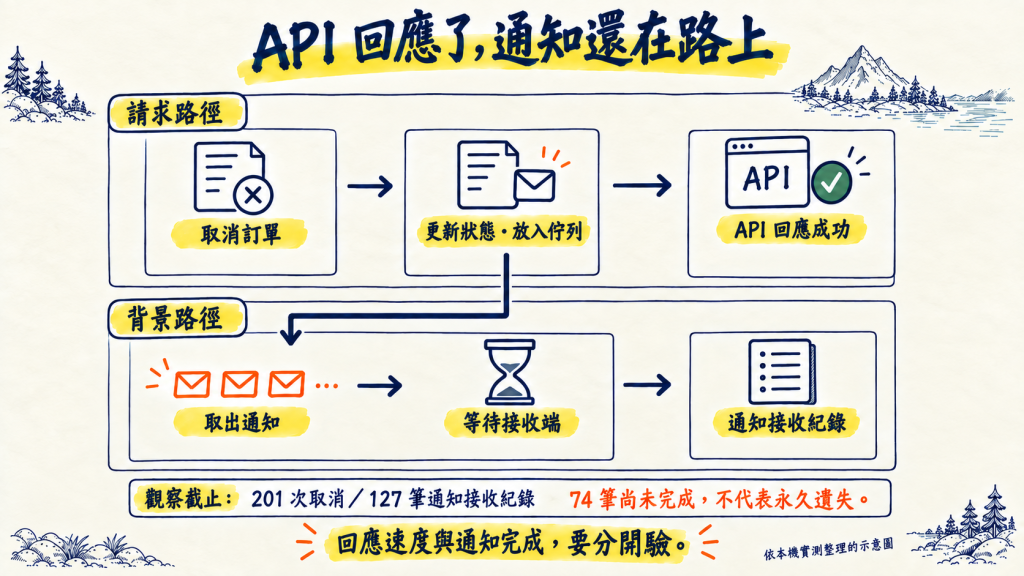
依本機實測整理:上面是請求回應的完成時間,下面是背景通知的完成時間;兩條線的落差就是那 74 筆。
為什麼通知慢,API 還能很快?這份程式在取消時把通知放進佇列,就可以回應;背景處理器再逐筆送出。因此接收端變慢時,取消請求仍可能很快,後面的通知卻正在排隊。
k6 這次檢查的是 API 回應與內容,通知接收紀錄則由執行器另外對帳。前者通過,後者在期限內沒完成,整體就不能算通過。
兩組 HTTP 失敗與漏送工作都是零,十個發布檔案的雜湊也沒變。慢下游那組,k6 的 API 門檻仍通過,但外面的通知對帳回傳失敗:截止時還有 74 筆沒有通知接收紀錄。它們不能直接算永久遺失;本次到截止就停止服務,沒有繼續等到全部送完。
這個實驗說明兩種完成時間不能混為一談。二十秒是事前設定的教學觀察期限;是否違反產品要求,還需要真正的通知完成期限。這次也不是在比較有沒有 Skill 就變快,因為新舊測試的工作組合不同。補測的原始結果與服務採樣另存,沒有混進上面的舊 Grafana 截圖。
這輪讓我改變的是上線判斷:不能只約好 API 要多快,還得約好通知多久要完成。 下一步應找產品與服務 Owner 確認下游延遲及接受期限,再決定設計要怎麼調整,不能把等待時間放寬到測試變綠就算解決。
我把同一份測試計畫、兩組結果、通知接收紀錄與兩份教學程式交給 Claude Code,限制它只能讀取與搜尋。這次要它把結果對回程式,提示重點是:
讀取測試計畫、正常與慢下游的結果、通知接收紀錄及相關程式。追出取消回應到通知送出的路徑,附檔名與行號;分開列已確認事實、推論與尚缺量測。先不要改程式,也不要把未完成直接判成永久遺失。
這次 Claude 完成了唯讀分析,指出取消回應與背景通知是兩條不同的完成路徑。我再核對它引用的程式位置與測試紀錄,整理如下:
程式位置(src/Api/Program.cs) |
核對到什麼 | 能解釋什麼 |
|---|---|---|
| 87–92 行:寫入通知佇列後回傳 | 本次未啟用同步通知,API 不等接收端完成 | API 回應快,不能代表通知已送達 |
| 224–246 行:背景處理器逐筆取出並等待 HTTP 回應 | 這個處理迴圈要等目前通知的送出結果,才繼續下一筆 | 接收端每次等 300ms,會限制這條送出路徑的速度 |
258–259 行:成功回應後留下 notify_sent |
送出成功另有紀錄,再與通知接收紀錄核對 | API 成功與通知完成,需要各自的依據 |
只算每筆 300ms 等待,這條逐筆處理路徑每秒最多約 3.3 筆,還沒算其他耗時;這是依實作估算的上限,不是容量實測。輸入每秒 10 筆,自然可能比送出速度快。它能解釋本次排隊方向,不能單靠這個估算推導精確的 127 筆結果。
Claude 也提醒:它只抽樣讀取部分通知接收紀錄,還不能宣稱逐筆核對完成。我另外核對完整資料,確認慢下游的 127 筆接收紀錄與 127 筆 notify_sent 的 ID 一致;其餘 74 筆在截止時沒有接收紀錄。這項完整對帳是另外做的,不算成模型已完成的工作。
模型提到 await PostAsync 會「阻塞」同一輪,我改成「等待 HTTP 結果後,這個迴圈才處理下一筆」,避免誤解為執行緒被阻塞。這次定位的是人為慢下游如何影響這份實作,沒有發現未知的 Production 根因。
下一個查核是每筆通知的等待與送達時間,再對照共同確認的完成期限。是否增加處理並行度,還得考慮下游限流、順序與重複通知;這篇先定位風險,沒有修改服務或宣稱修復。
這次能回答:同一份版本,在這台機器、這三種短時負載與正常假下游下,取消與通知守住了事前的教學門檻。
補測也顯示,慢下游時 API 通過與通知完成是兩件事。仍不能回答正式上線。服務把訂單存在記憶體,沒有正式身分驗證;真實下游、正式環境差異、資料備份與回復也沒驗。這些不是把 k6 跑久一點就會自動解決。
回到團隊,下一步是把教學數字換成共同確認的目標,在接近正式配置的測試環境,用同一份包重跑,再由 Owner 連同資安、資料與回復條件一起決定。壓測結果是上線依據的一部分,不是整張通行證。
今天從需求出發,問上線前該承受什麼;之後若線上真的出問題,才從事故條件出發,重現它、驗修法、補回歸。都可以用 k6,但它們回答不同問題。
Claude 幫我把程式風險變成測試策略,k6 跑出結果;真正影響上線判斷的,是我有沒有把整件工作的完成條件驗到。
上線條件釐清後,還有更新這一關:出了問題,退回舊版就真的恢復了嗎?
參考資料:
sdlc-delivery/day15-lab 保存事前計畫、Claude 原始回覆、腳本與儀表板設定;runs/day15-smoke-01、day15-spike-01、day15-sustain-01 保存摘要、原始樣本、通知接收紀錄、服務採樣與雜湊。操作附件列重跑步驟。補測另存於 day15-skill-lab,包含來源版本、提示、Skill 呼叫、策略與事前計畫;runs/day15-skill-control-01、day15-skill-slow-01 保存正常與慢下游對照;day15-skill-lab/diagnosis-02 保存追加唯讀分析與人工核對。以上在系列 repo的位置是 days/day14/lab-delivery/——Day 14–17 共用同一份交付包,所以路徑掛在 day14。

 iThome鐵人賽
 看影片追技術