

今天是第三條主線「可以切換、也可以復原的服務」的收尾。Day19~28 已經依序建立服務身分、PostgreSQL 高可用性、固定服務入口、公開 HTTPS 與備份復原。服務具備切換與復原能力後,維運者還需要在使用者回報以前看見異常,並快速回答三個問題:哪一條服務路徑受到影響、故障從哪一層開始,以及現在是否已經恢復。
今天會從最底層的觀測資料開始,依序介紹時間序列、Exporter、Prometheus、PromQL、告警規則、Alertmanager 與 Grafana,最後把它們組成一條可以實際觸發、觀察及恢復的監控鏈,並回顧第三條主線完成了什麼。
本文閱讀方式
- 完整理解監控與告警流程:依序閱讀全文。
- 掌握完成部署所需的基本概念:優先閱讀標有「⭐」的章節。
- 快速了解當天的部署內容:閱讀文末的 Lab/實作章節。
- 跟著系列建立完整系統:依照 GitHub 詳細部署文件 的天數順序操作。
可觀測性(Observability)是利用系統輸出的資料推斷內部狀態。實際排錯通常會同時使用下列資料:
| 資料 | 內容 | 作用 |
|---|---|---|
| 指標(Metrics) | 按時間收集的數值 | 錯誤率、延遲、容量與可用性何時開始變化 |
| 日誌(Logs) | 帶有時間與上下文的事件 | 哪個元件回傳了什麼錯誤 |
| 追蹤(Traces) | 一次請求跨服務的處理路徑 | 延遲發生在哪一段呼叫 |
| 外部探測(Probe) | 從指定位置主動發出的連線或請求 | 使用者入口是否能完成 DNS、TLS 與 HTTP 流程 |
今天主要建立指標與外部探測。逐筆 SQL、HTTP 與稽核事件適合交給日誌保存。請求跨越多個服務的處理路徑則由追蹤串接。
Prometheus 是以時間序列為核心的開源監控與告警工具。Prometheus Server 依照抓取設定(Scrape Config)定期向應用程式或 Exporter 的 HTTP Endpoint 抓取 Metrics,將樣本保存到時間序列資料庫(Time Series Database,TSDB),再由 Prometheus 查詢語言(Prometheus Query Language,PromQL)查詢、彙總與比較資料。內建的規則引擎(Rule Engine)也會定期計算記錄規則(Recording Rule)與告警規則(Alerting Rule)。
Prometheus 負責收集、保存、查詢與判斷告警條件。Exporter 將既有系統狀態轉成 Metrics,Grafana 查詢 Prometheus 並呈現儀表板(Dashboard),Alertmanager 則接收 Prometheus 送出的告警,執行分組、路由、抑制與通知。這些元件各自負責一段工作,共同組成完整的監控與告警流程。
圖(一)Prometheus 是以數值型時間序列為核心的開源監控與告警工具
一筆 Prometheus 樣本(Sample)由時間戳記與數值組成。同一個指標名稱及同一組標籤(Label)構成一條時間序列(Time Series)。以下範例代表 10.77.20.31:9100 的根檔案系統目前可用位元組數:
node_filesystem_avail_bytes{
  instance="10.77.20.31:9100",
  mountpoint="/",
  fstype="ext4"
} 32100000000
標籤讓同一個指標可以按節點、工作、掛載點或狀態篩選與彙總。每一種不同的標籤組合也會建立新的時間序列,因此 user_id、完整 URL、查詢文字等持續增加的值不適合直接成為標籤。這類高基數(High Cardinality)資料會同時增加記憶體、儲存空間、查詢與網路成本。
Prometheus Client Library 提供四種核心指標類型:
| 類型 | 數值特性 | 常見用途 | 常用查詢方式 |
|---|---|---|---|
| 計數器(Counter) | 持續增加,程序重啟時可歸零 | 請求、錯誤、處理位元組累計 | 以 rate() 或 increase() 計算一段時間的變化 |
| 量測值(Gauge) | 可以上升或下降 | 目前連線數、剩餘容量、複寫延遲 | 直接比較數值或使用時間範圍函式 |
| 直方圖(Histogram) | 將觀測值累計到區間(Bucket),並保存總和與筆數 | 請求延遲、回應大小 | 由 Bucket 計算分位數或門檻內比例 |
| 摘要(Summary) | 在程式端計算滑動時間窗的分位數(Quantile) | 單一 Instance 的延遲分位數 | 直接讀取程式端產生的 Quantile |
Counter 的累計值本身通常缺少時間意義。例如 http_requests_total 為 100 萬,只代表從程序啟動後累積的請求。rate(http_requests_total[5m]) 才能回答最近五分鐘每秒增加多少請求。
Prometheus 需要先取得可以讀取的數值資料。常見來源可分成三類:
| 指標來源 | 指標取得方式 | 本次使用方式 |
|---|---|---|
| 程式內建量測(Instrumentation) | 程式直接維護並公開自己的指標 | Patroni /metrics、HAProxy Prometheus Exporter |
| Exporter | 讀取作業系統或既有服務,再轉成 Prometheus 格式 | Node Exporter、PostgreSQL Exporter、Textfile Collector |
| 黑箱探測(Blackbox Probe) | 從外部主動執行 HTTP、TCP、DNS、ICMP 或 gRPC 探測 | 從公開主機名稱檢查 Cloudflare HTTPS 路徑 |
Node Exporter 從 Linux 核心與虛擬檔案系統取得 CPU、記憶體、檔案系統及網路資料。PostgreSQL Exporter 使用受限的資料庫帳號讀取統計檢視,再把結果公開成 Metrics。主機上的批次工作或腳本若無法直接輸出 Prometheus 格式,可以定期寫入 .prom 檔案,再由 Node Exporter 的 Textfile Collector 讀取。本次會用它輸出兩台 Proxy 的 Origin Certificate 到期時間。
Blackbox Exporter 站在探測端發起完整請求。probe_success=1 代表該次探測符合設定條件,還可以同時取得 DNS、連線、TLS 與 HTTP 各階段時間。它反映的是探測位置看到的結果,還要搭配內部指標定位故障原因。
Prometheus 也會為每個監控目標(Target)產生 up:
up=1:Prometheus 成功讀取這個 Target 的 Metrics Endpoint。up=0:這次 Scrape 失敗。up=1 只證明 Metrics Endpoint 可被抓取。應用程式能否提供服務,還要觀察 pg_up、patroni_primary、HAProxy Backend 與 probe_success 等服務指標。
Prometheus 預設採用拉取(Pull)模型,依 Scrape Config 定期向 Target 的 HTTP Endpoint 取得 Metrics。Target 可以由服務探索(Service Discovery)動態提供,也可以像本次 Lab 一樣以 Static Config 明確列出。
scrape_configs:
  - job_name: patroni
    static_configs:
      - targets:
          - 10.77.30.11:8008
          - 10.77.30.12:8008
          - 10.77.30.13:8008

  - job_name: postgres
    static_configs:
      - targets:
          - 10.77.30.11:9187
          - 10.77.30.12:9187
          - 10.77.30.13:9187
job 表示同一類工作,instance 通常表示實際 Target。Prometheus 每次 Scrape 會保存樣本,並以 PromQL 查詢、彙總或比較時間序列。Rule 也會定期執行 PromQL,因此設定時要同時理解兩個週期:
本次會使用下列查詢回答不同問題:
# 哪些 Metrics Target 無法抓取
up == 0

# 哪些檔案系統的可用比例低於 15%
node_filesystem_avail_bytes{fstype!~"tmpfs|overlay"}
/
node_filesystem_size_bytes{fstype!~"tmpfs|overlay"} < 0.15

# 目前能取得的 Patroni Metrics 是否回報一個 Primary
sum(patroni_primary) != 1

# 公開 HTTPS 探測是否失敗
probe_success{job="public-web-https"} == 0
這些 PromQL 可以先貼到 Prometheus 的查詢介面確認結果。需要讓 Prometheus 持續判斷並產生告警時,則要把 Expression 寫入 Rule File。首先在 /etc/prometheus/prometheus.yml 載入規則目錄:
rule_files:
  - /etc/prometheus/rules/*.yml
再將告警名稱、PromQL、持續時間與標籤寫入 /etc/prometheus/rules/iron-lab.yml。以下把前面的四個查詢實際轉成告警規則:
groups:
  - name: iron-lab
    rules:
      - alert: InstanceDown
        expr: up == 0
        for: 2m
        labels: { severity: critical }

      - alert: FilesystemLow
        expr: node_filesystem_avail_bytes{fstype!~"tmpfs|overlay"} / node_filesystem_size_bytes{fstype!~"tmpfs|overlay"} < 0.15
        for: 10m
        labels: { severity: warning }

      - alert: PatroniHasNoLeader
        expr: sum(patroni_primary) != 1
        for: 30s
        labels: { severity: critical }

      - alert: PublicHttpsDown
        expr: probe_success{job="public-web-https"} == 0
        for: 2m
        labels: { severity: critical }
寫入後先檢查 Prometheus 主設定與 Rule File,再重新載入服務:
sudo promtool check config /etc/prometheus/prometheus.yml
sudo promtool check rules /etc/prometheus/rules/iron-lab.yml
sudo systemctl reload prometheus
查詢介面適合暫時分析。Rule File 才會讓 Prometheus 按照 Evaluation Interval 反覆計算 Expression,並依 for 推進 Pending 與 Firing 狀態。完整 annotations、Runbook 與另外兩條憑證到期規則放在文末實作文件中。
sum(patroni_primary) != 1 用來判斷目前可取得的 Patroni Metrics 是否呈現單一 Primary。Target Scrape 失敗則由 up == 0 處理。若所有 patroni_primary 時間序列都消失,sum() 會得到空結果,因此要同時搭配 up 告警。需要讓角色規則本身涵蓋完全缺少資料的情況時,可以再加入 absent(patroni_primary)。這組訊號能區分單一監控入口失效與目前可見的 Primary 數量異常。
公開網站的成功請求會跨越多個元件:
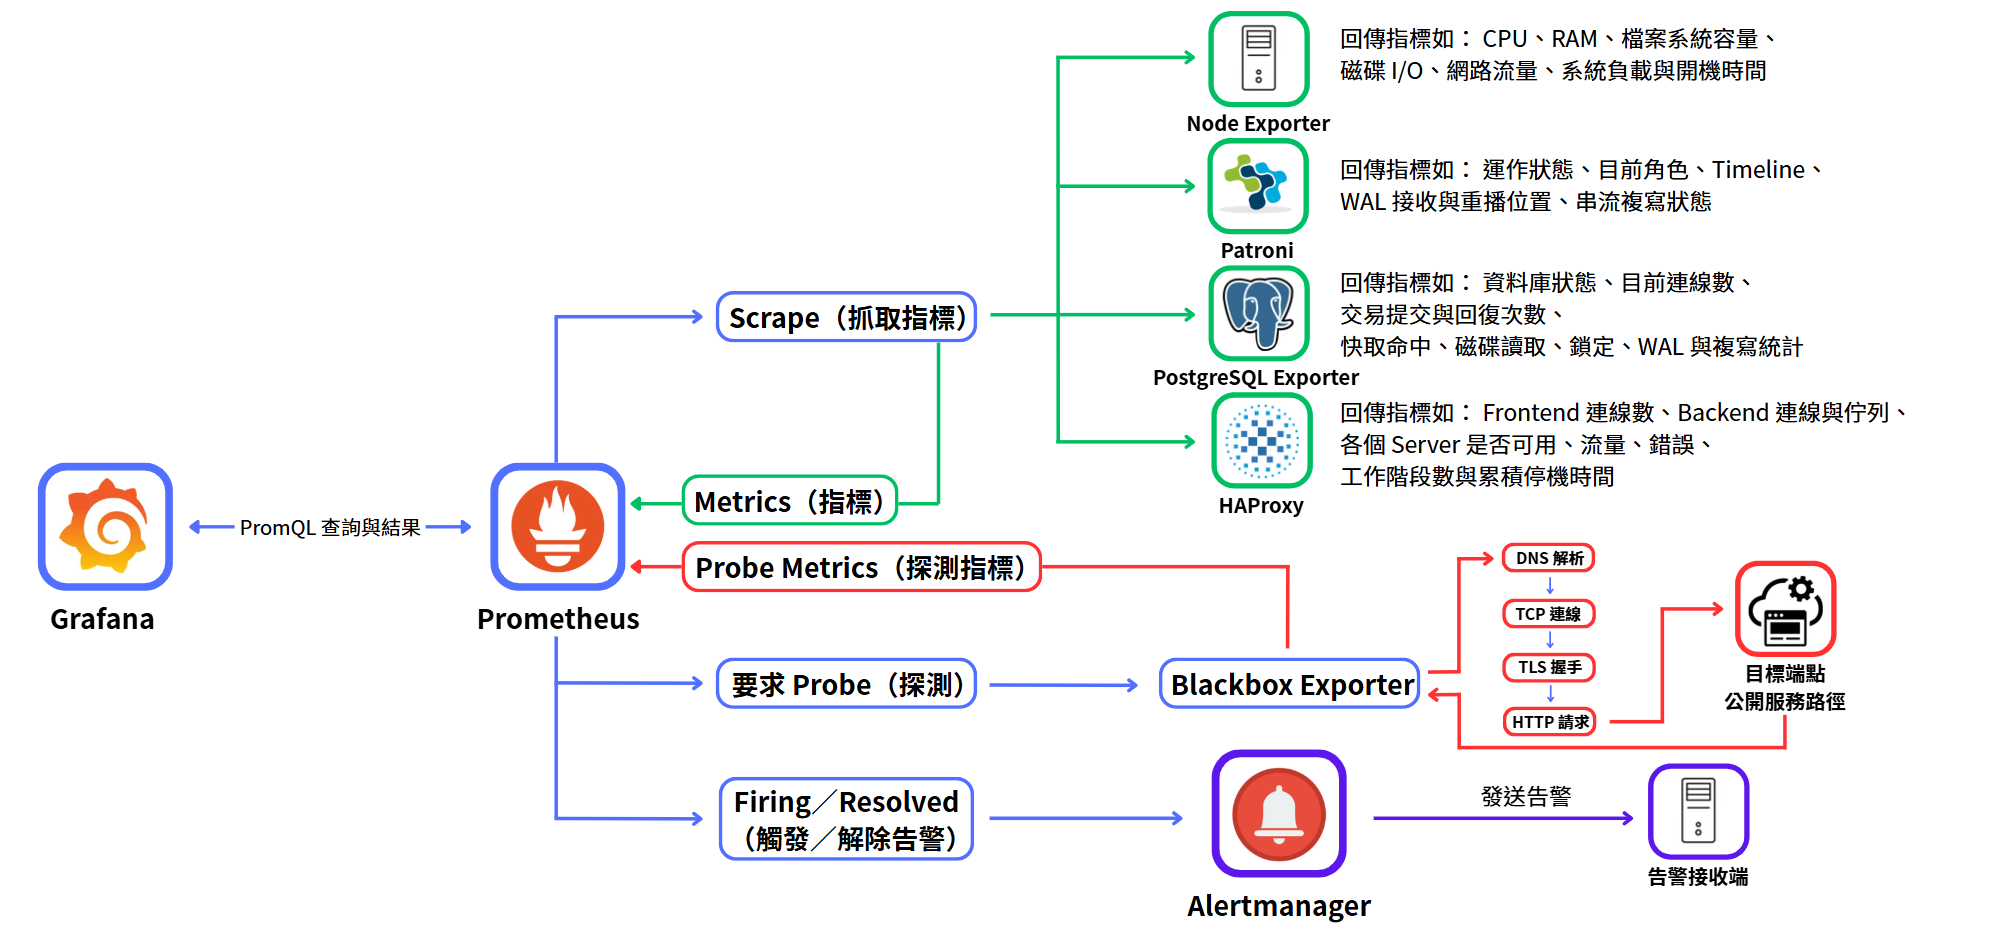
圖(二)使用者請求沿服務路徑抵達 PostgreSQL。單一 Prometheus 從內部 Metrics Endpoint 與 Blackbox Exporter 收集 Metrics,供 Grafana 查詢並將告警交給 Alertmanager。
內容傳遞網路(Content Delivery Network,CDN)由分散在不同地區的 Edge 節點接收使用者請求。公開網域啟用 Cloudflare Proxied 後,DNS 會把使用者導向 Cloudflare 的 Anycast IP,再由合適的 Edge 處理連線。Edge 可以回傳快取內容,也可以把請求送往 Origin。
公開 Probe 看到 HTTP 200 時,還要辨認回應是由快取提供,還是沿 Origin 路徑取得:
| 觀測結果 | 判讀 | 需要搭配的訊號 |
|---|---|---|
公開 HTTPS 成功且為 HIT |
DNS、Edge TLS 與 Edge 快取可以服務 | Origin、Nginx 與 App 的內部指標 |
DYNAMIC 或 BYPASS |
Cloudflare 未用 CDN 快取滿足請求 | Origin Request ID、存取日誌或內部服務指標 |
MISS |
目前 Edge 找不到可用快取 | Tiered Cache、Origin 日誌與後端服務指標 |
| 內部 Metrics 正常 | Origin 端元件目前可被監控 | 公開 DNS、Edge TLS 與外部連線探測 |
因此,監控公開服務時要同時保留外部 Probe 與內部 Metrics。本次 Blackbox Probe 使用 /health。這個 Endpoint 應回傳 Cache-Control: no-store,或由 Cache Rule 明確略過快取。CF-Cache-Status 用來判讀快取決策,Origin Request ID、存取日誌與內部指標才用來確認請求是否抵達服務。結果為 HIT 時,HTTP 200 只證明 Edge 快取可以回應。
告警應優先反映使用者可感受到的錯誤、延遲與不可用,再使用元件指標說明原因。規劃服務指標時,可以先從延遲(Latency)、流量(Traffic)、錯誤(Errors)與飽和度(Saturation)四個方向檢查:請求是否變慢、流量是否異常、失敗比例是否上升,以及資源是否接近容量上限。只監控 CPU 會漏掉憑證過期、DNS 錯誤、後端路由錯誤與資料庫角色異常。只做外部 Ping 則無法判斷 TLS、HTTP 與 SQL 是否完成。
本次用不同層次的訊號建立最短排查路徑:
| 層次 | 觀測訊號 | 判讀 |
|---|---|---|
| 公開服務 | probe_success、公開 TLS 到期時間 |
使用者能否從公開 Hostname 完成 HTTPS? |
| 代理入口 | HAProxy Frontend/Backend 指標 | 代理是否有可用資料庫後端? |
| 資料庫協調 | Patroni Role、Primary 數量 | 叢集目前由哪個節點提供寫入角色? |
| PostgreSQL | pg_up、連線與複寫統計 |
Exporter 能否連入資料庫,資料庫負載是否異常? |
| 主機資源 | CPU、記憶體、檔案系統、網路 | 元件異常是否來自主機容量? |
| 憑證 | Edge 與 Origin Certificate 到期時間 | 對外與回源兩段 TLS 是否接近到期? |
Cloudflare 終止用戶端 TLS,因此公開 Probe 看到的是 Edge Certificate。Nginx 使用的 Origin Certificate 位於 Proxy 節點,必須在 proxy01、proxy02 分別輸出期限。兩種憑證要以不同指標與門檻監控。
Alertmanager 是 Prometheus 生態系中的告警處理工具。它以獨立服務執行,接收 Prometheus 送出的告警,再依設定完成分組、去除重複、路由、抑制與靜默,最後將通知交給 Email、Slack、Webhook 等通知接收端(Receiver)。Prometheus 負責判斷告警條件,Alertmanager 負責整理告警並決定通知方式。
圖(三)Alertmanager 接收 Prometheus 送出的告警,負責整理、路由與通知
Prometheus Alerting Rule 以 PromQL 判斷條件。for 是告警規則中的持續時間條件。例如 for: 2m 表示 PromQL 條件必須連續成立兩分鐘。條件首次成立時進入 Pending,持續滿足 for 指定的時間後進入 Firing。若在期限內恢復,則直接回到 Inactive。省略 for 時,條件在一次規則評估中成立便可進入 Firing。Prometheus 將 Firing Alert 傳給 Alertmanager,條件解除後再通知 Alertmanager 結束這筆 Alert。Alertmanager 會把它移出 Active Alert,並在 Receiver 啟用 send_resolved 時送出 Resolved 通知。
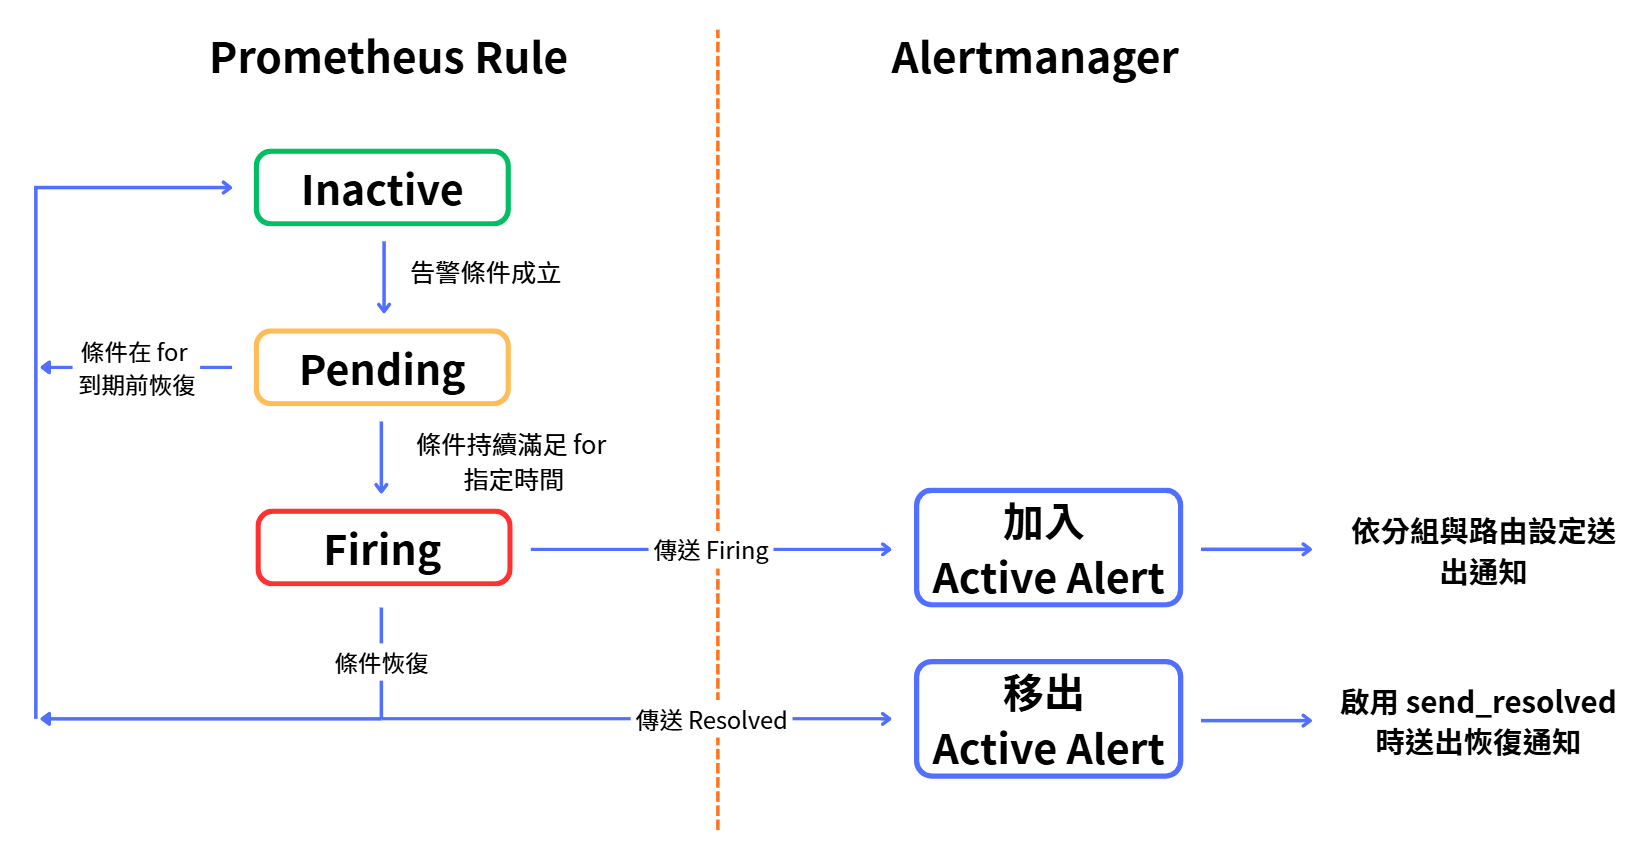
圖(四)Prometheus Rule 管理 Inactive、Pending 與 Firing。進入 Firing 後才由 Alertmanager 接手 Active Alert,條件恢復時再收到 Resolved。
前面的 InstanceDown Rule 使用 for: 2m,表示 up == 0 連續成立兩分鐘後才進入 Firing。
從停止服務到 Firing 的時間,還會受到 Scrape Interval、Evaluation Interval 與兩個週期的對齊位置影響。若後面還有外部通知,Alertmanager 的 group_wait 與通知通道也會增加時間。完整量測應分別記錄故障注入、Pending、Firing、恢復操作、Target Up、Prometheus 回到 Inactive,以及 Alertmanager 清除 Active Alert 的時間。for: 2m 只是其中一段等待條件。
Alertmanager 接收 Prometheus 送出的 Firing/Resolved 告警,負責後續整理:
| 功能 | 作用 |
|---|---|
| 分組(Grouping) | 將同類告警合併成一組通知,降低大量故障產生的通知風暴 |
| 去除重複(Deduplication) | 避免相同告警被重複通知 |
| 路由(Routing) | 依 severity、服務或團隊送到對應 Receiver |
| 抑制(Inhibition) | 上游重大故障成立時,抑制由它引發的下游通知 |
| 靜默(Silence) | 在維護窗口暫停符合條件的通知 |
靜默與抑制只影響通知處理,原始指標與 Prometheus 告警狀態會繼續保留。正式環境的告警規則應附上負責人(Owner)、嚴重程度(Severity)、摘要(Summary)與操作手冊(Runbook),讓收到告警的人知道影響、責任與下一步操作。
圖(五)Grafana 將 Prometheus 查詢結果整理成圖表、表格與狀態畫面
Grafana Data Source 是連向資料儲存後端的查詢連線。本次 Grafana 使用 Prometheus Data Source,Panel(面板)透過 PromQL 取得資料,再以圖表、表格或狀態值呈現。Metrics 與 Rule 的來源是 Prometheus。
Dashboard 適合把公開探測、主機資源、Patroni Role、PostgreSQL 連線及 HAProxy Backend 放在同一時間範圍。它能協助判讀趨勢與關聯,告警條件要保存成可版本控制、可由 promtool 驗證的 Rule File。
一張有效的 Dashboard 應先回答使用者入口是否正常,再逐層呈現服務與資源原因。大量彼此無關的圖表會增加排錯時間。每個 Panel 都應具有明確單位、時間範圍、查詢與判讀目的。
Prometheus、Alertmanager 與 Grafana 是三個獨立的開源專案,也會分別安裝、設定與執行。在本篇建立的監控生態系中,Prometheus 提供 Metrics、查詢結果與告警狀態,Alertmanager 接手告警通知流程,Grafana 查詢 Prometheus 並呈現 Dashboard。三者分工獨立,實際運作時高度整合。
同一個元件在 Metrics、Dashboard、Alert 與 Runbook 中應使用一致的 job、instance、節點名稱與服務名稱。所有主機也要保持時間同步,才能把故障注入、第一次 Scrape 失敗、Firing、服務恢復、Prometheus 回到 Inactive 與 Alertmanager 清除 Active Alert 排成同一條時間線。
告警內容至少應回答:
當一個狀態只需要留在 Dashboard 觀察,且沒有對應的立即行動,就不適合直接成為叫醒維運人員的告警。
本篇定位是一套最基礎的可觀測性入門架構:以 Metrics 與 Probe 觀察已知的服務狀態,用 Dashboard 集中判讀,再以告警規則通知維運者。它足以驗證服務路徑與告警生命週期,尚未涵蓋集中式 Logs、Distributed Tracing、跨訊號關聯、OpenTelemetry 遙測標準、持續效能剖析(Continuous Profiling)、長期儲存、取樣策略與監控平台高可用性。
若想繼續了解 Logs、Traces、Profiles、訊號關聯及正式環境的設計考量,可以延伸閱讀第 15 屆 iThome 鐵人賽 Cloud Native 組冠軍系列《時光之鏡:透視過去、現在與未來的 Observability》。這也是我很推薦的可觀測性系列。若篇幅允許,我也很想完整介紹這個主題。
服務層級指標(Service Level Indicator,SLI)是實際量測到的服務品質,例如成功請求比例、回應延遲或可用性。服務層級目標(Service Level Objective,SLO)則替 SLI 設定時間範圍與期望門檻,例如最近 30 天內成功請求比例至少達到 99.9%。因此要先從使用者在意的服務行為定義 SLI、SLO 與告警目標,再決定需要收集哪些資料。
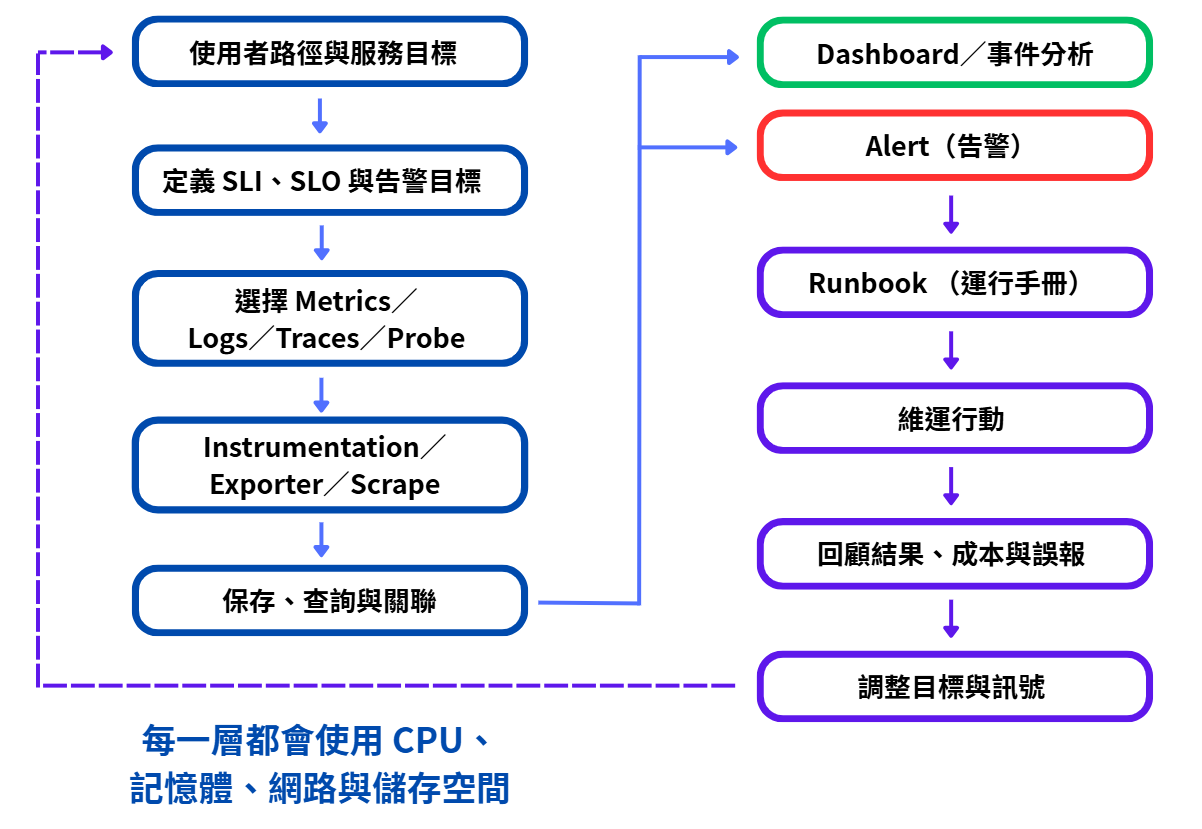
圖(六)可觀測性從服務目標開始,經過訊號選擇、收集、保存、告警與維運行動,再依結果調整目標與訊號。觀測管線的每一層都需要容量規劃。
觀測資料會消耗資源。程式內的 Instrumentation、Exporter、Scrape、Rule Evaluation、Dashboard Query,以及日誌與追蹤資料的傳送和保存,都會使用 CPU、記憶體、網路與儲存空間。縮短 Scrape Interval、延長資料保留期間(Retention),或把使用者 ID、完整 URL 等高基數資料放入 Label,還會進一步放大時間序列數量與查詢成本。
| 規劃面向 | 需要先回答的問題 |
|---|---|
| 觀測目標 | 哪些使用者路徑最重要?要用哪些 SLI 與 SLO 判斷服務品質? |
| 資料範圍 | Metrics、Logs、Traces 與 Probe 各自需要保留哪些訊號? |
| 資源成本 | Target 數量、Scrape Interval、標籤基數與 Retention 會產生多少負載與容量需求? |
| 告警行動 | 哪些狀況需要通知?由誰處理?Runbook、升級條件與 Silence 如何執行? |
| 平台可靠性 | Prometheus、Alertmanager、Grafana Database、歷史 Metrics 與 Receiver 如何跨故障域保存? |
Metrics Endpoint 可能揭露主機名稱、檔案系統、服務角色與版本。Exporter 應只允許 Prometheus 來源連入。跨 VLAN 流量由 OPNsense 限制,同 VLAN 流量再由主機防火牆補足。PostgreSQL Exporter 使用具有 pg_monitor 的專用帳號,不使用資料庫超級使用者。
Prometheus 的保存時間、啟用的 Collector、Target 數量、Scrape Interval 與標籤基數共同決定 CPU、記憶體及磁碟需求。監控平台本身也要觀察 Scrape 失敗、Rule Evaluation 錯誤、TSDB 容量與 Alertmanager 狀態。
本系列將 Prometheus、Grafana 與 Alertmanager 集中在單台 monitor01,方便建立完整流程。這項配置也讓 monitor01 成為監控單點。單機監控失效時,受監控服務可能繼續運作,管理者則會暫時失去 Metrics、Dashboard 與告警處理能力。
完整操作步驟請參考 Day 29 詳細實作文件。本次沿用 monitor01,建立下列觀測路徑:
vpn-monitor01 開放 Grafana 與 Prometheus 管理介面。Prometheus Targets 頁應分別顯示:
prometheus:1/1 Up。node:11/11 Up。patroni:3/3 Up。postgres:3/3 Up。haproxy:2/2 Up。public-web-https:1/1 Up。同時由 monitor01 對 Metrics Endpoint 執行正向測試,再從未授權的 client01 執行負向測試。這組結果可驗證 Prometheus 具有讀取權限,也可驗證同 VLAN 的 Metrics Port 沒有對一般用戶端開放。
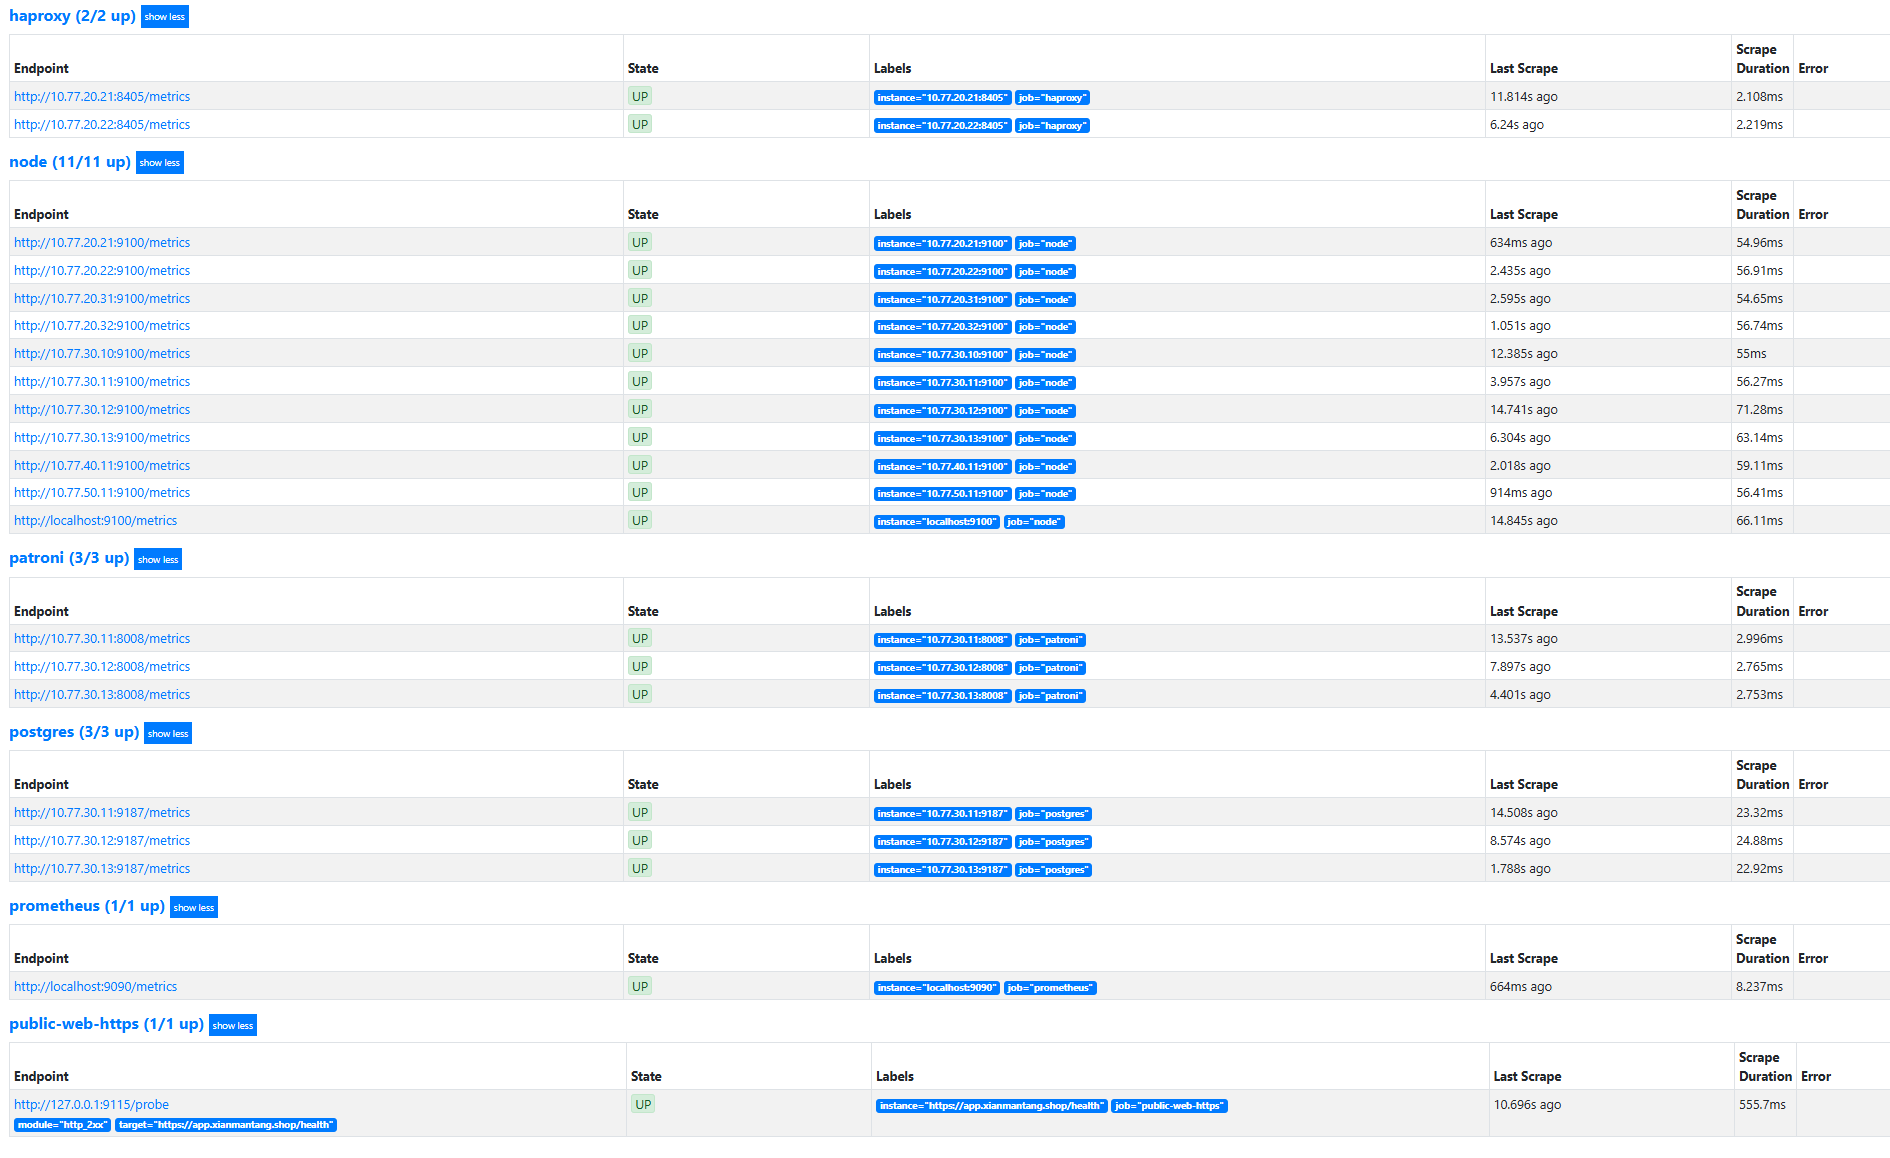
圖(七)Prometheus 已收集六個 Job。node、patroni、postgres、haproxy、prometheus 與 public-web-https 均達到預期的 Up 數量。
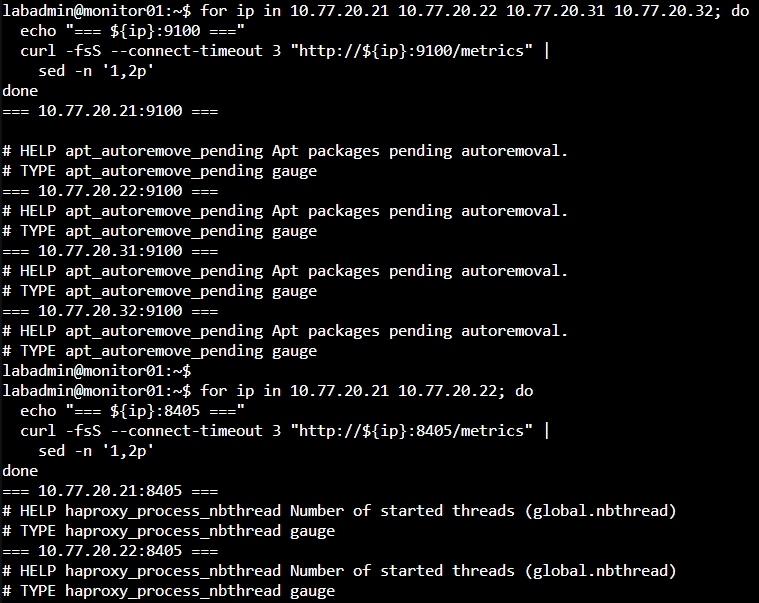
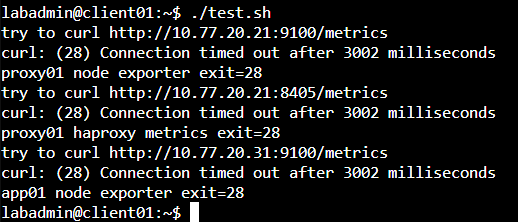
圖(八)monitor01 可以讀取 Node Exporter 與 HAProxy Metrics。同 VLAN 的 client01 連入相同 Port 時逾時,驗證主機防火牆只授權監控來源。
Grafana 加入 Prometheus Data Source 後,匯入 IRON-LAB Overview Dashboard。畫面應包含 Node CPU、Memory、Filesystem、Patroni Role、PostgreSQL Connections、HAProxy Backend 與 Public HTTPS Probe 七個 Panel。
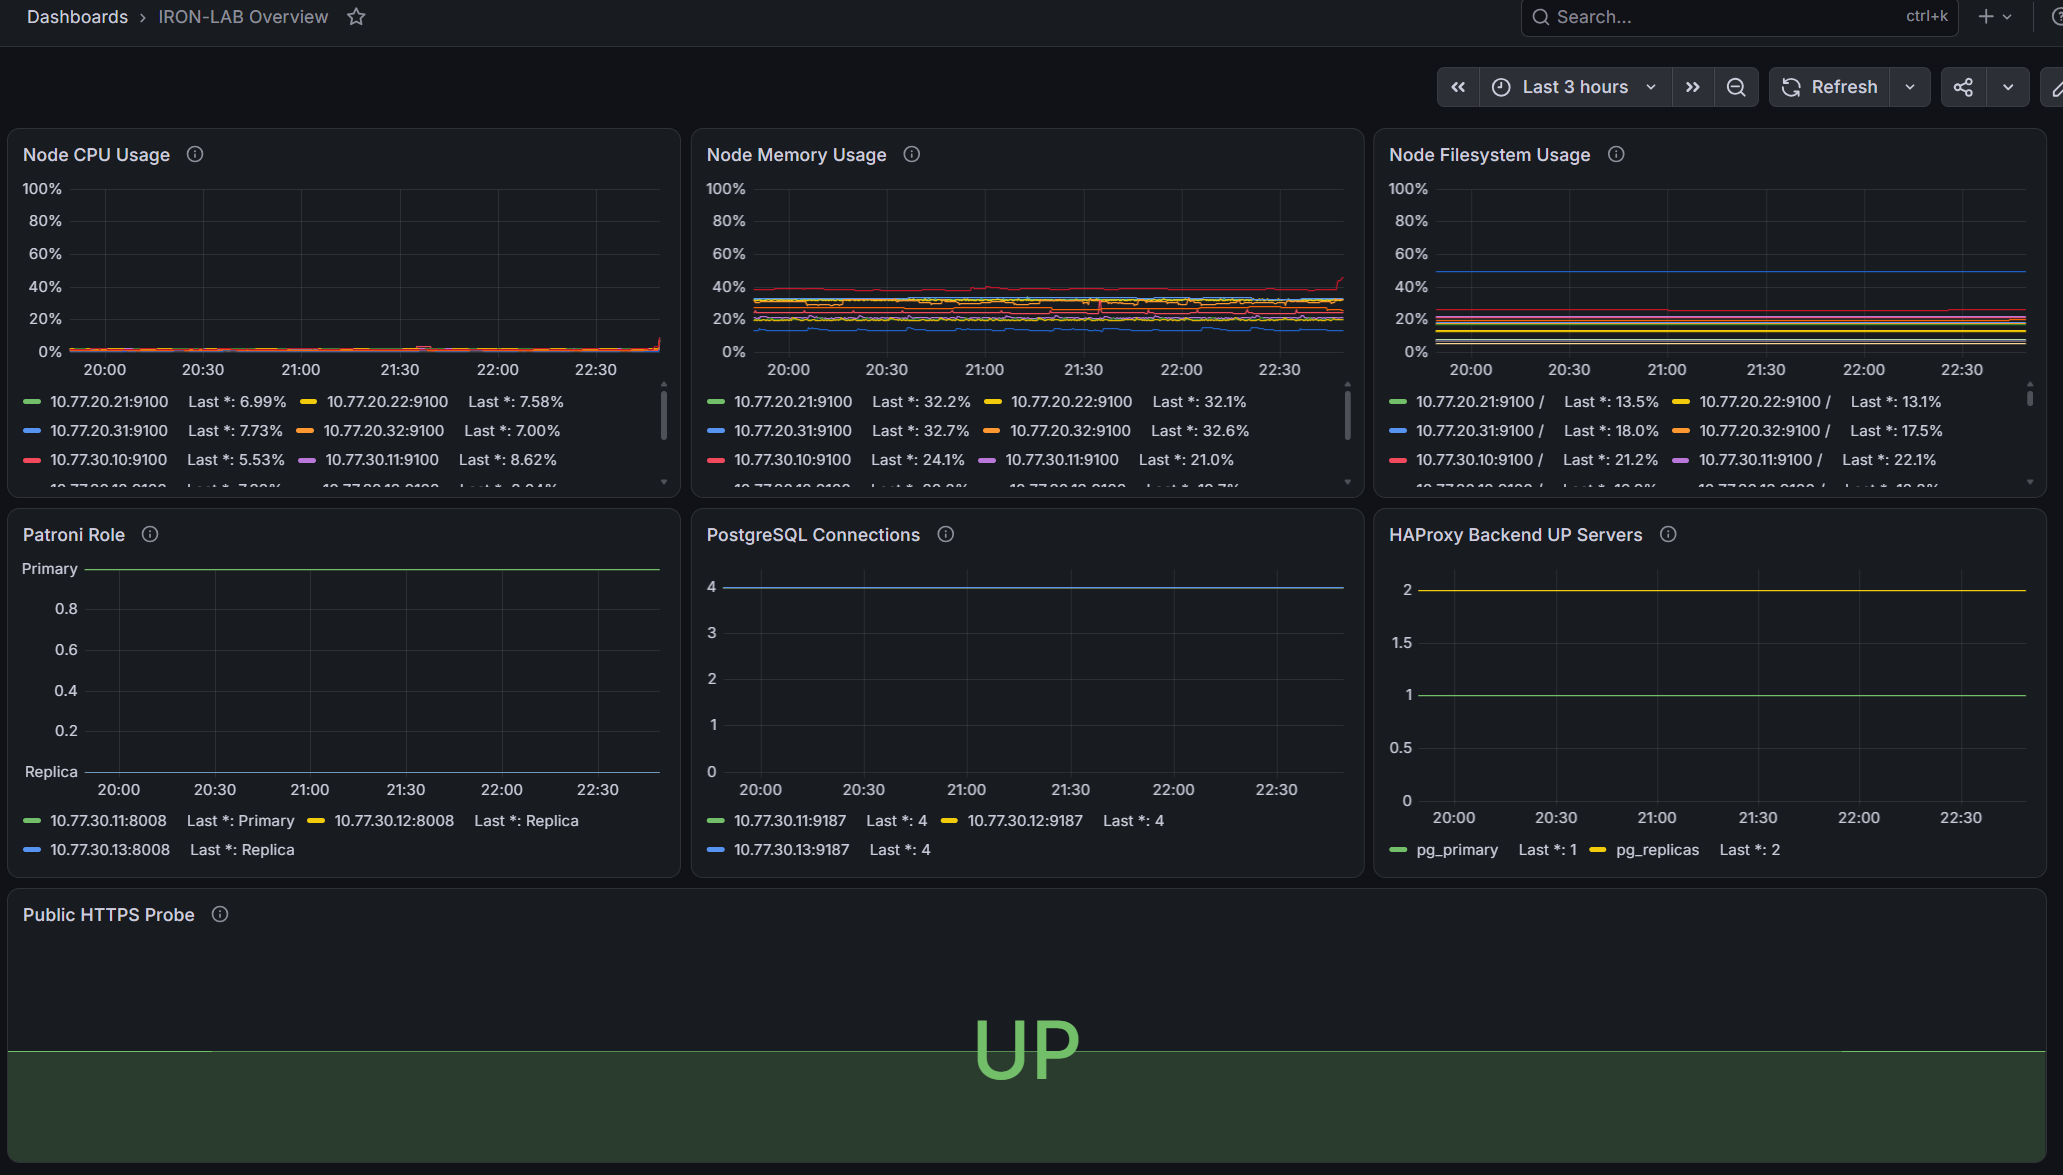
圖(九)Dashboard 在同一時間範圍呈現七組訊號,公開 HTTPS 為 Up,Patroni Role、PostgreSQL Connections 與 HAProxy Backend 也都有資料。HAProxy Panel 先計算每台代理看見的可用 Server,再跨代理取最大值,因此正常狀態下應顯示一個 Primary 與兩個 Replica。
for 會把持續異常從 Pending 推進到 Firing先保存目前時間,再停止 app02 的 Node Exporter。Prometheus 下一次 Scrape 會將該 Target 標示為 Down,InstanceDown 先進入 Pending。條件持續超過兩分鐘後才進入 Firing,Alertmanager 隨後收到這筆 Alert。
恢復 Node Exporter 後,Target 回到 Up,Prometheus Rule 回到 Inactive,該筆 Alert 再從 Alertmanager 的 Active Alert 清單消失。本次證據可確認 Alertmanager 已收到告警,Routing Tree 也已通過 amtool 路由測試。本機 Receiver 沒有設定 Email 或 Webhook,因此不涵蓋外部 Firing 或 Resolved 通知送達。
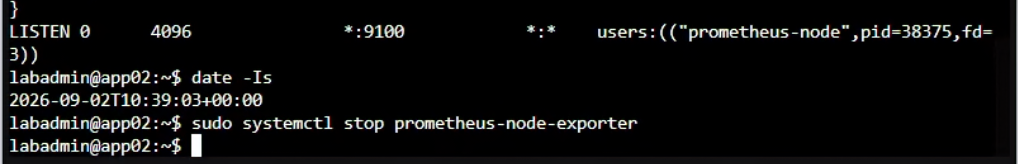
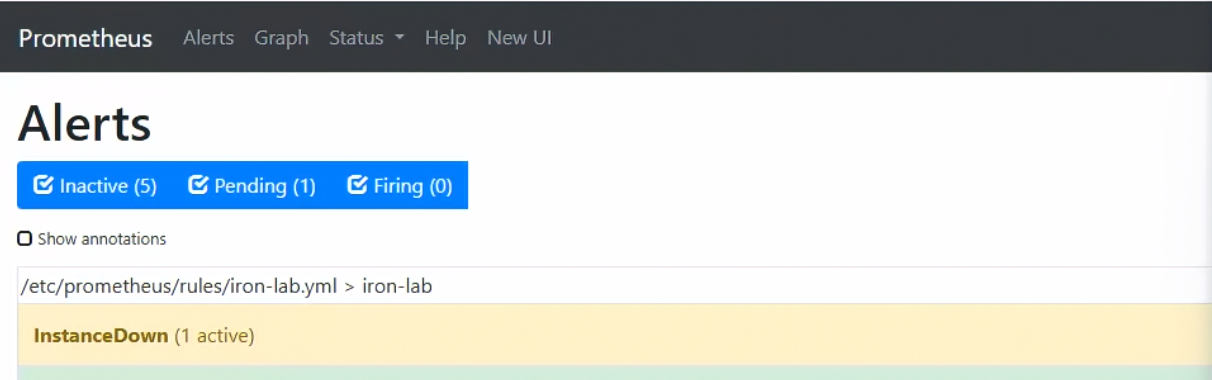
圖(十)app02 在 10:39:03 UTC 停止 Node Exporter。Prometheus 隨後將 InstanceDown 標示為 Pending,尚未進入 Firing。
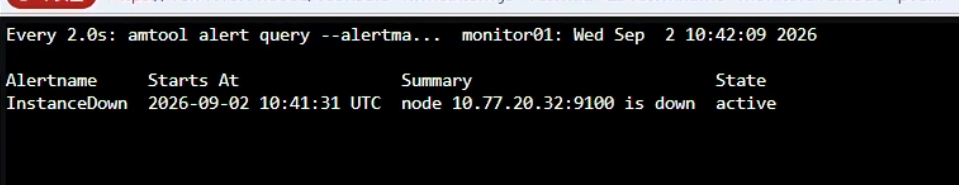
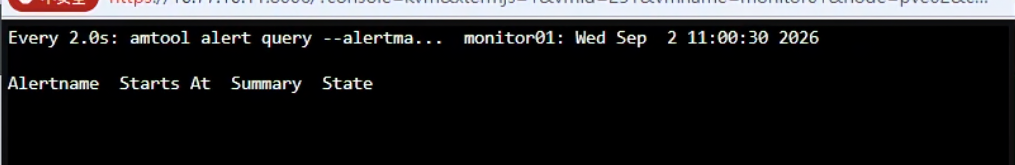
圖(十一)Alertmanager 顯示 app02 的 InstanceDown 從 10:41:31 UTC 開始 Active。後續查詢只剩欄位名稱,代表 Active Alert 已清空。
本次畫面可量化故障注入到 Firing/Active 起點的時間,也能證明 Alertmanager 已收到 Alert。恢復操作起點沒有留下時間,因此只能確認告警已清除,不計算恢復耗時:
| 里程碑 | 時間 | 可計算結果 |
|---|---|---|
| 停止 Node Exporter | 10:39:03 UTC |
故障注入起點 |
InstanceDown 進入 Pending |
已觀察,未保存精確時間 | 證明 for 等待期間確實存在 |
| Firing/Active 起點 | 10:41:31 UTC |
故障注入到 Firing/Active 為 148 秒 |
| Alertmanager Active Alert 清空 | 11:00:30 UTC 前 |
恢復操作起點未記錄,因此不計算恢復耗時 |
先由 patronictl list 找出當下的 Replica,再停止其中一台的 Patroni。該節點的 Patroni Target 應變成 Down,並在兩分鐘後觸發 InstanceDown。其餘節點持續回報剛好一個 Primary,因此 PatroniHasNoLeader 應維持 Inactive。
重新啟動 Patroni 後,要等該節點回到 Replica/streaming、時間軸與 Primary 一致,才算完成恢復。這組測試證明 Target 可達性與叢集角色是兩種獨立訊號,也驗證告警可以指出單一節點故障而不誤報整個叢集失去 Primary。
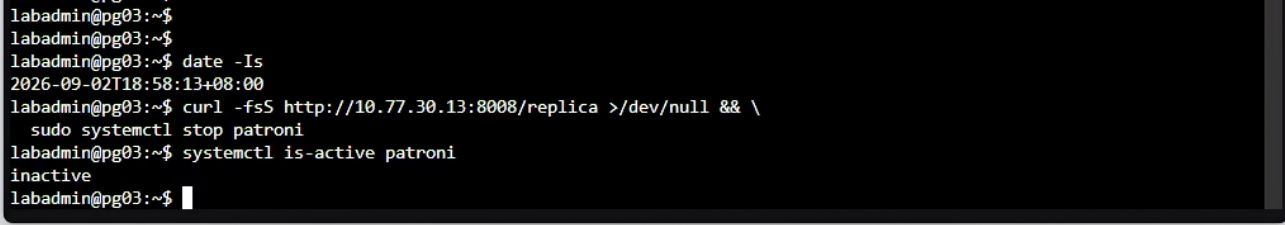
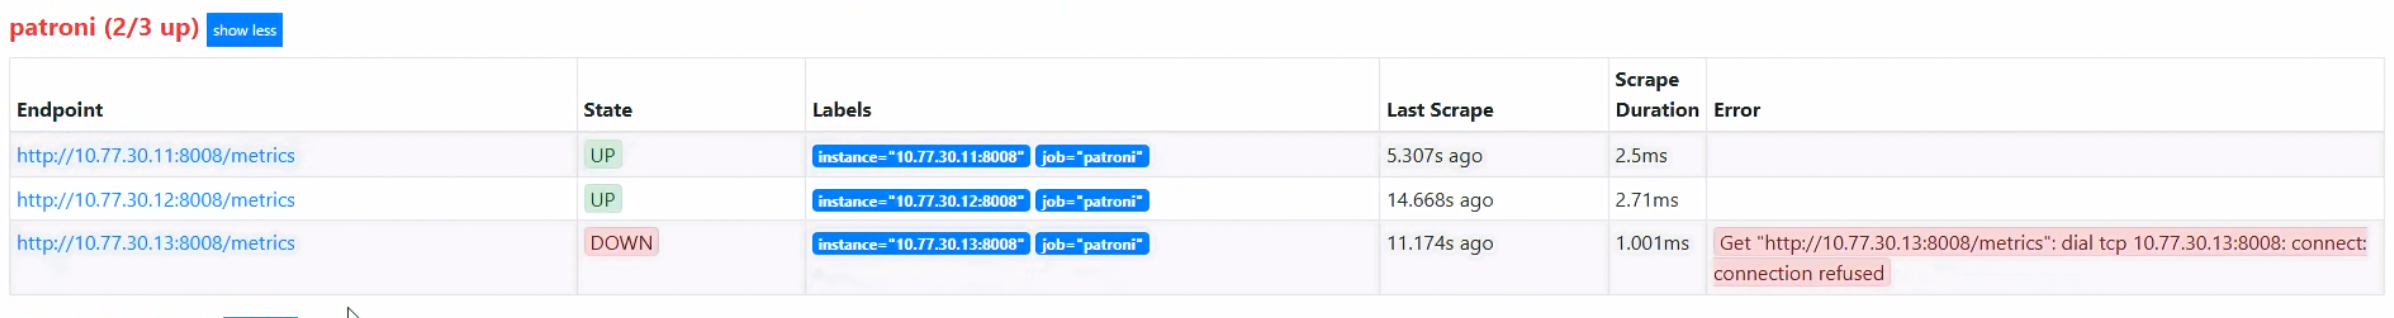
圖(十二)/replica 回傳成功後才停止 pg03 的 Patroni。Prometheus 隨後顯示 Patroni Target 為 2/3 Up,pg03 因拒絕連線而 Down。
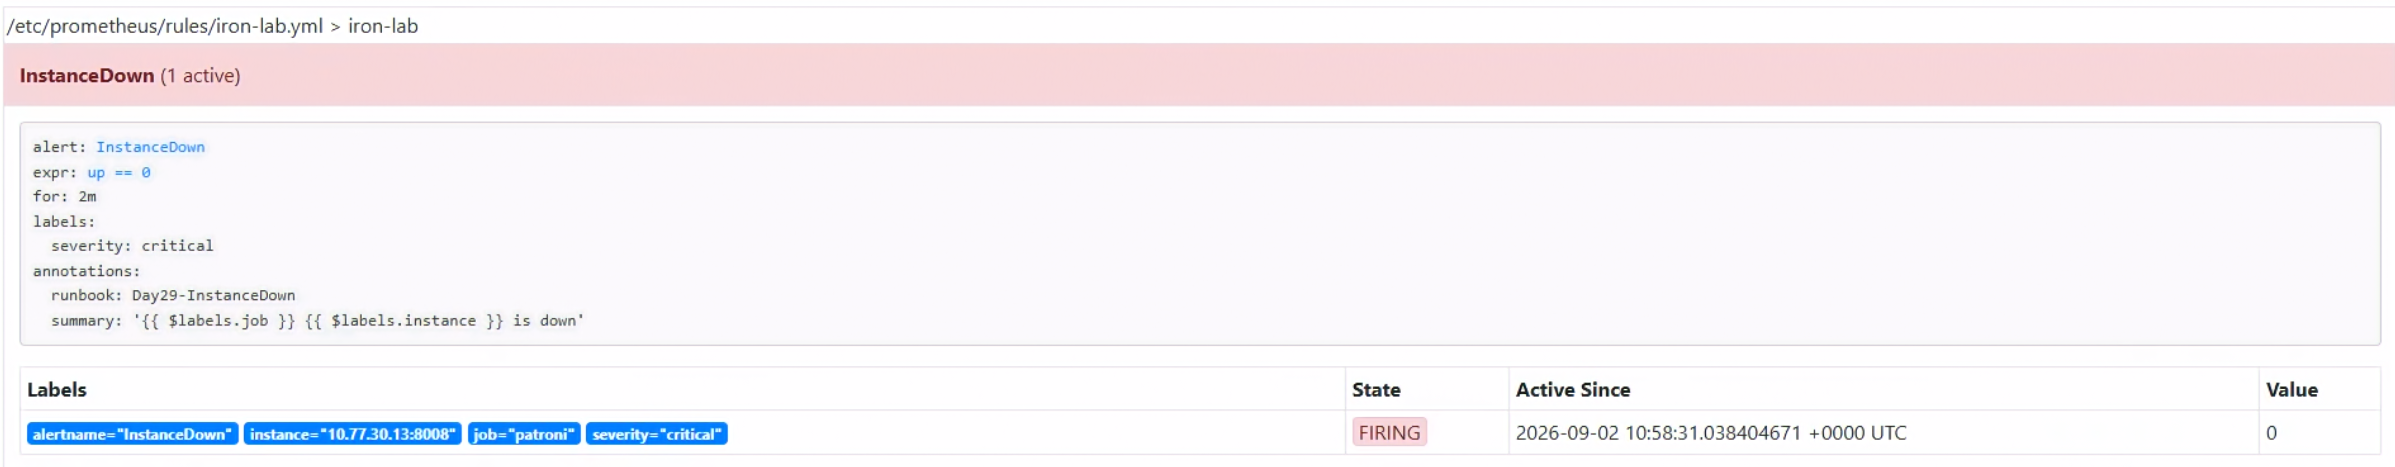
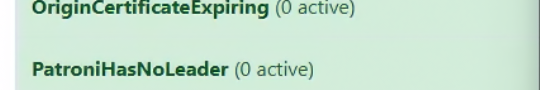
圖(十三)pg03 的 InstanceDown 已進入 Firing,PatroniHasNoLeader 同時維持 Inactive。單一 Replica 失效會觸發節點可達性告警,運作中的 Primary 則讓叢集角色告警保持正常。
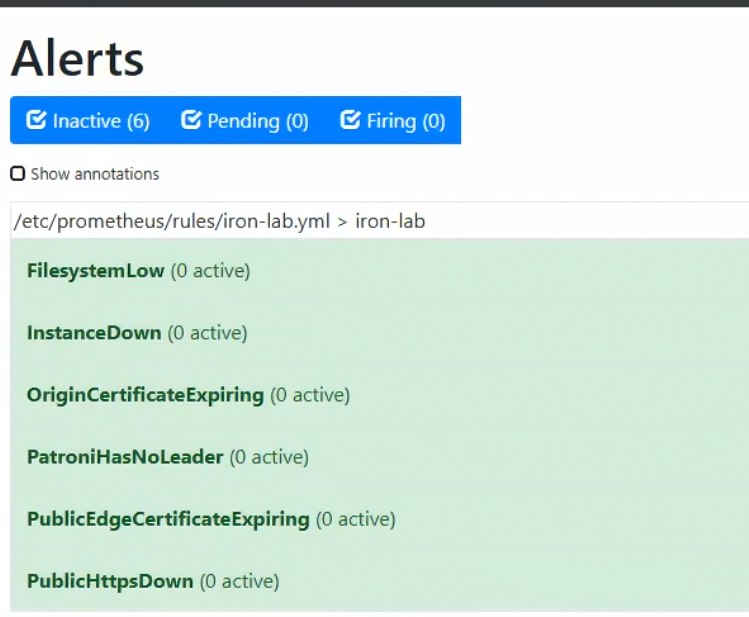
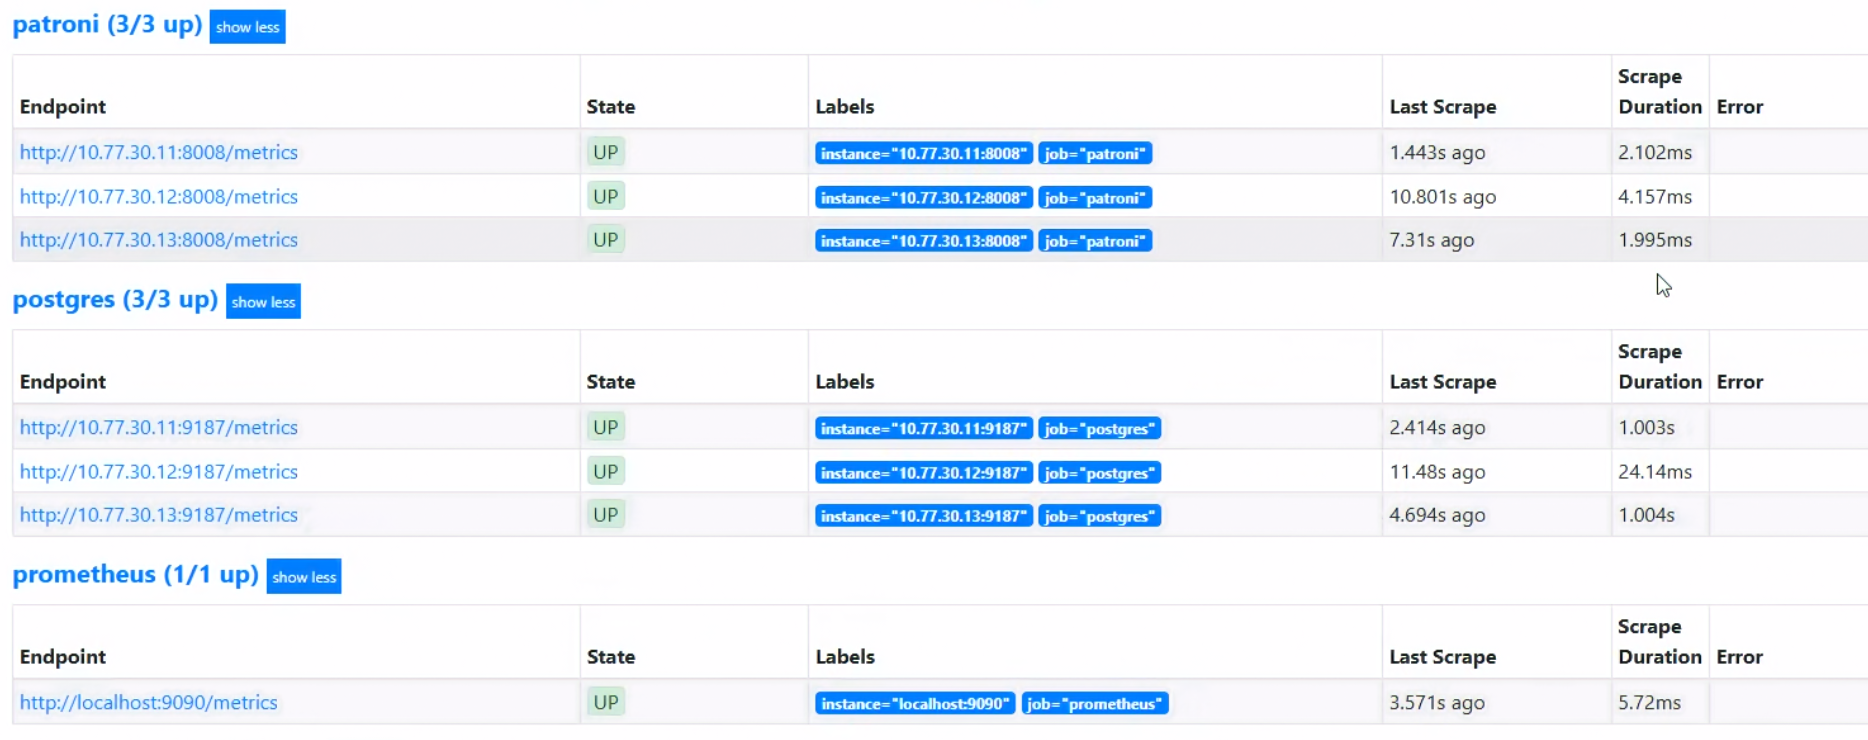
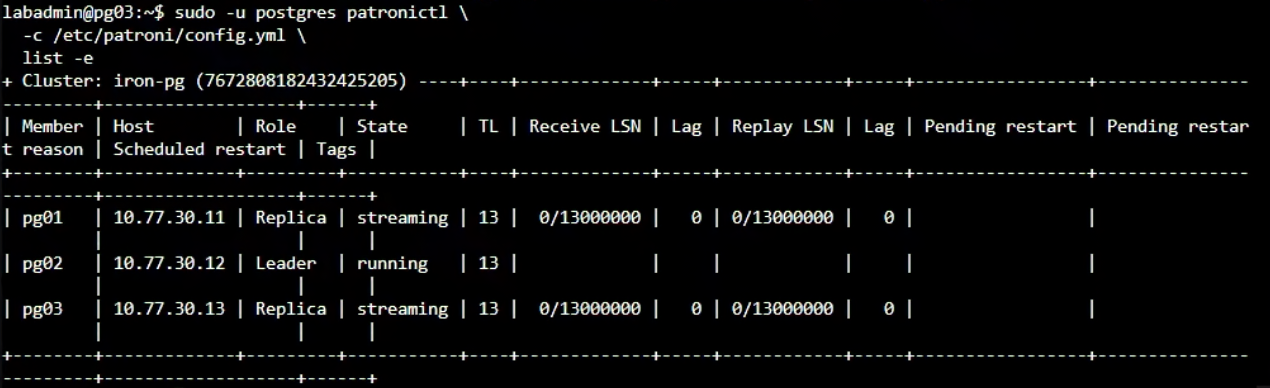
圖(十四)恢復後檢查顯示六條 Rule 全部 Inactive,Patroni 與 PostgreSQL Target 回到 3/3 Up。pg02 為 Leader,pg01、pg03 為 Replica/streaming,三台 Timeline 皆為 13,Replication Lag 為 0。
| 項目 | 主要證據 | 可以得到的結論 |
|---|---|---|
| 驗證一:Target 收集與存取限制 | Prometheus Targets、正向與負向連線測試 | 預定 Metrics 可由 monitor01 收集,未授權來源無法讀取指定 Metrics Port |
| 驗證二:Dashboard | Grafana 七個 Panel | Prometheus 資料可以在同一時間範圍分層呈現 |
| 證明一:告警生命週期 | 故障時間、Pending、Alertmanager Active 與清空結果 | for 會等待持續異常。恢復後 Prometheus 回到 Inactive,Alertmanager 清除 Active Alert |
| 證明二:Replica 故障 | Patroni Role、兩條 Alert 狀態與重新加入結果 | 單一 Replica Target Down 不等於叢集失去 Primary |
至此,第三條主線已經完成。下圖以藍色虛線框標示目前建立完成的服務與支援元件。完整服務入口與故障觀察位置會在 Day30 最終驗收時另外整理。
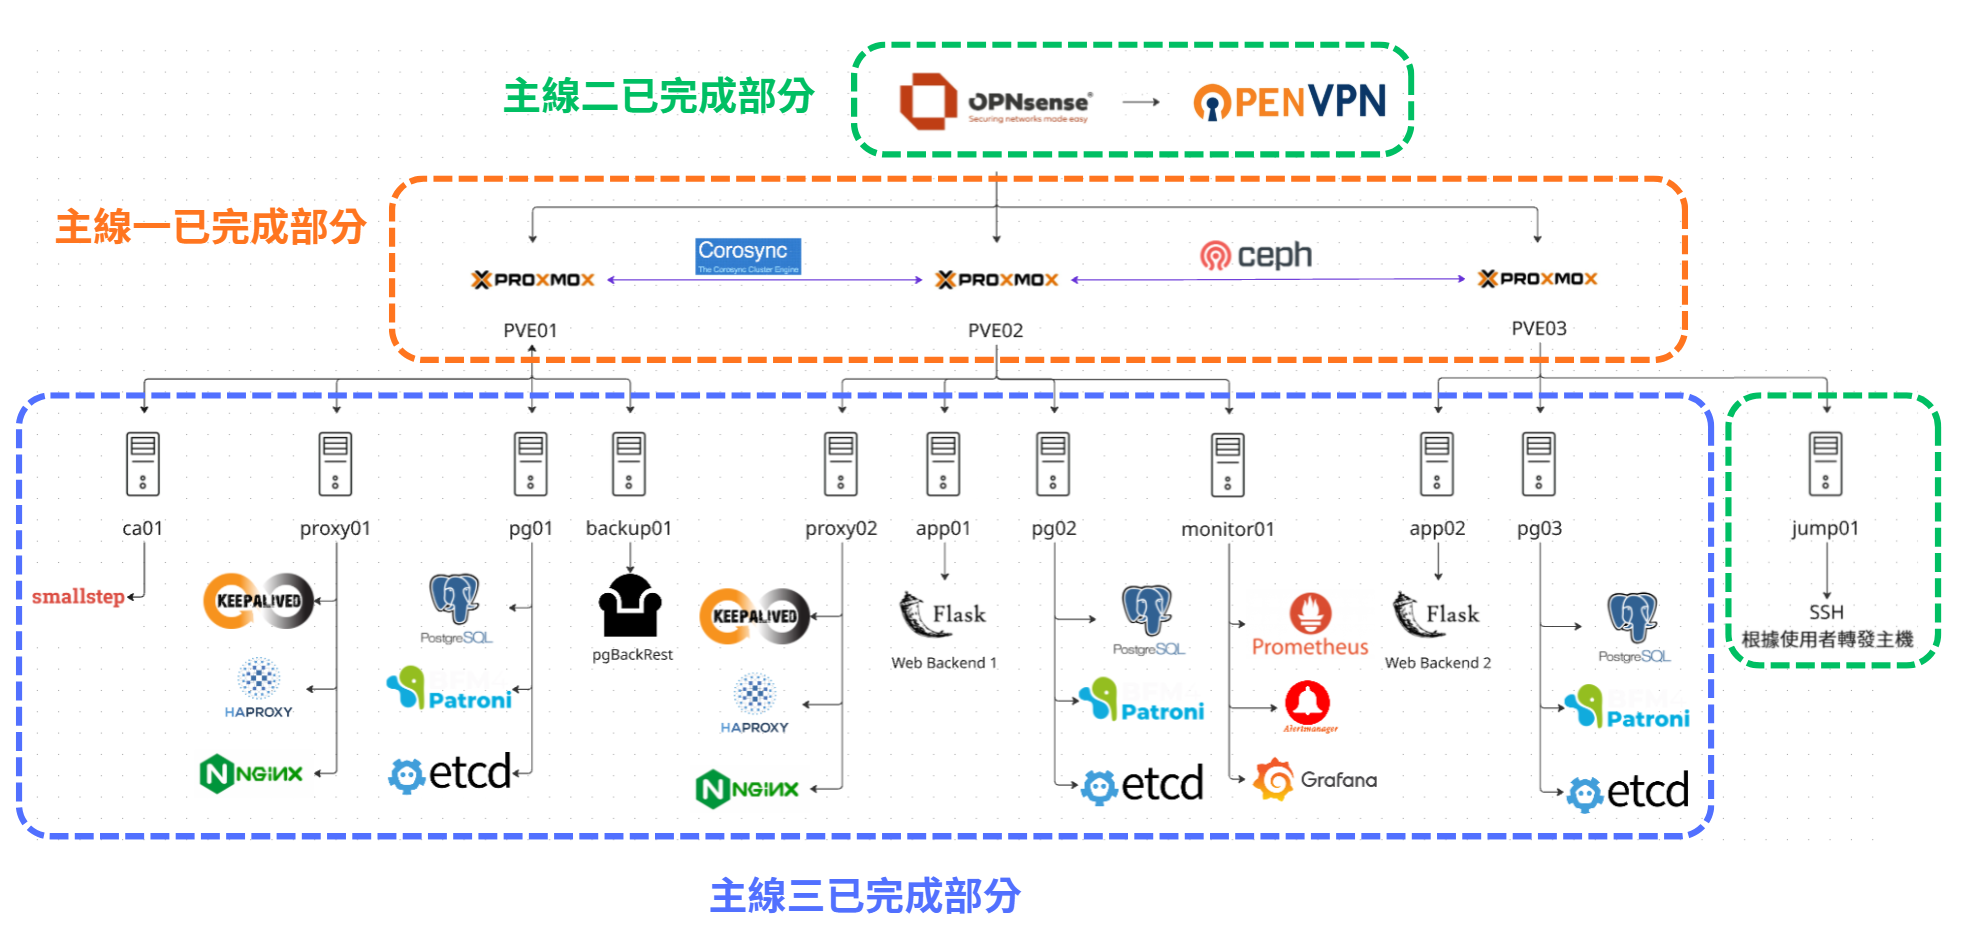
圖(十五)主線三完成內部 CA、PostgreSQL HA、固定代理入口、備份復原與可觀測性元件
這十一天建立的服務身分、高可用性、固定入口、備份復原與可觀測能力包括:
pg_hba.conf 與 SCRAM-SHA-256,建立可驗證身分且受控的 PostgreSQL 連線。pg_rewind,並從用戶端觀察服務中斷及恢復。下一篇進入全系列的最後驗收階段。Day 30|最終驗收:用 Game Day 檢查安全邊界、服務切換與資料復原會沿用今天建立的監控與告警,把三條主線完成的虛擬化平台、網路與存取控制,以及服務切換與資料復原放進同一套驗收表。屆時會標明每項測試的觀察位置與計時邊界,再將實測結果和事先設定的目標比較。


 iThome鐵人賽
 看影片追技術