
最近做 AI Product,在準備正式上線前,Team 提到除了原本的功能測試之外,還要再測一件事:
Token Consumption。
也就是實際跑過一輪使用情境之後,看看:
不同 Task 會消耗多少 Token?
平均耗量多少?
有沒有特別異常的 Case?
整體耗量是否在合理範圍?
這件事讓我開始重新思考:
AI Product 的測試,不只是「做不做得到」,還要確認「用了多少資源才做到」。
這其實跟我以前做企業內部平台時,很在意的一件事情很像:
不要浪費資源。
做企業內部 System 時,很多成本 User 其實看不到。
例如不同 Team 都需要:
權限管理
通知
流程簽核
共用資料
基礎 Component
如果每一個 Project 都重新做一次,
功能可能都可以上線,
但從整個 Organization 來看,其實是在重複消耗:
Engineer Time
Development Effort
Maintenance Cost
Infrastructure
所以我們會做:
共用 Component、Service、中台、Reusable Capability。
目的不只是讓開發比較快。
背後其實是一個很基本的概念:
同樣的資源,不要一直重複花。
以前這個「資源」比較常是:
人力、開發時間、System Capacity。
到了 AI Product,
我發現這件事情變得更直接了。
以前要做一個複雜的功能,
可能需要寫很多 Rule、Logic、Workflow。
現在接上 Model,
很多事情看起來突然變簡單:
User Input
↓
Model
↓
Answer
但這個「簡單」不是免費的。
一次看似普通的 AI Task,背後可能包含:
System Prompt
+
User Input
+
Conversation History
+
Retrieved Documents
+
Model Output
如果是 Agent,還可能有:
Planning
Tool Call
Intermediate Result
Retry
每一次執行,都需要資源。
而 Token Consumption,就是我們觀察這些資源消耗的一個重要訊號。
所以在上線前測試 Token,
本質上其實是在回答:
這個 AI Feature 現在的資源使用合理嗎?
簡單來說,Model 處理文字時,不是直接按照「幾個中文字」計算,而是拆成 Token。
對 PM 來說,我覺得一開始不用鑽進 Tokenization 的技術細節。
比較重要的是知道:
Input Context 越多
→ 通常需要處理更多 Token

Output 越長
→ 通常產生更多 Token

Model Call 越多
→ 整體資源消耗增加

Retry 越多
→ 同一個 Task 可能重複消耗資源
所以測 Token 的目的,也不是看到:
「這次用了 8,432 Tokens。」
然後判斷:
「太多了,砍掉。」
單看一個數字其實沒有太大意義。
更重要的是建立:
Baseline。
例如同一類 Task:
平均耗量多少?
P95 大概多少?
哪些 Case 特別高?
為什麼特別高?
如果大部分 Task 都在某個區間,
只有少數 Case 突然高出很多,
那才值得往下看:
是不是 Context 塞太多?

是不是 Retrieve 太多文件?

是不是 Conversation History 一直累積?

是不是 Agent 多跑了不必要的 Step?

是不是 Failure 後不斷 Retry?
這時候 Token 才真正變成可以幫 Product 找問題的 Metric。
這是我後來覺得很有意思的一點。
Token 高,當然可能代表 Cost 高。
但它有時候也可能暴露:
Product Flow 本身不夠有效率。
例如兩個 Solution 都可以完成同一件事:
User Request
↓
一次 Retrieve
↓
一次 Model Call
↓
完成
User Request
↓
Retrieve
↓
Model Call
↓
再判斷
↓
再 Retrieve
↓
再 Call Model
↓
Retry
↓
完成
B 不一定不好。
如果這些 Step 真的讓結果明顯更準、更可靠,那資源可能花得值得。
但如果最後 Quality 差不多,
就值得問:
這些額外消耗真的有產生額外 Value 嗎?
這跟以前做 Platform 很像。
我們不會因為:
「反正 Engineer 做得出來。」
就接受所有重複開發。
AI Product 也不能因為:
「反正 Model 回答得出來。」
就不去看它用了多少資源。
這也是我覺得 PM 很重要的一個基本觀念:
不要單獨優化 Token。
假設有兩個方案:
Task Success:92%
平均 Token:20K
平均 Latency:12 秒
Task Success:91%
平均 Token:6K
平均 Latency:4 秒
A 的效果高一點,
但耗量和等待時間也明顯比較高。
這時候 Product Decision 就不是:
「Token 越少越好。」
而是:
多花的資源,有沒有換到值得的效果?
如果是高風險 Task,
多花一些資源換取更可靠的結果,可能非常合理。
如果只是:
「幫我摘要一篇內部公告。」
也許就不需要。
所以我會一起看:
Quality
做得好不好?

Reliability
能不能穩定做到?

Latency
User 要等多久?

Consumption
用了多少資源?
這四個 Dimension 很多時候是一起 Trade-off 的。
如果真的要把 Token Consumption 放進上線前測試,我覺得至少還可以多看兩層。
平均值有時候會把問題藏起來。
例如:
90% Task:5K Token
10% Task:50K Token
平均看起來也許還可以,
但那 10% 為什麼突然暴增?
可能就是值得 Review 的地方。
所以除了 Average,
也可以看:
Median
P95
Max
再把異常 Case 拉出來分析。
假設 User 問一次花 5K Token,
看起來不高。
但因為第一次沒有解決問題,
User 又問一次、Retry 一次,
最後 Agent 又 Call 兩次 Tool。
真正完成這件事情可能已經花了:
5K
+ 5K
+ Retry
+ Tool Result
+ Final Answer
所以比起只看:
Token per Request
我會更想知道:
完成一次 User Task,到底用了多少資源?
也就是:
Consumption per Successful Task。
因為 User 真正要的不是:
「成功 Call 一次 Model。」
而是:
把事情完成。
這裡我覺得也不能變成:
「超過 X Token 就不合理。」
不同 Task 本來就值得花不同資源。
簡單 FAQ 跟複雜 Agent Task,
不可能用同一條線判斷。
所以更合理的方式可能是:
Task Type A
→ 建立自己的 Consumption Baseline

Task Type B
→ 建立自己的 Consumption Baseline

Task Type C
→ 建立自己的 Consumption Baseline
然後問:
在達到我們 Success Criteria 的前提下,這個耗量合理嗎?
這比追求:
最低 Token
更接近真正的 Product Optimization。
以前做 Platform 時,
我們用:
共用 Service
中台
Reusable Component
避免每個 Team 重複造輪子。
到了 AI 時代,
AI 確實讓很多 Build 的成本下降了。
但它沒有讓「資源有限」這件事情消失。
只是資源的型態開始多了一些:
Token
Model Call
Context
Compute
Latency
Tool Call
所以 PM 還是要回答同一個老問題:
我們花出去的資源,有沒有真的產生足夠的 User Value?
只是以前這題可能發生在 Architecture Review。
現在,它也開始出現在 AI Product 的日常測試裡。
以前做 Product,
上線前我們會測:
功能對不對?
流程通不通?
Performance 好不好?
Exception 能不能處理?
現在做 AI Product,
我會再多加一題:
完成這件事情,到底消耗了多少資源?
不是因為 Token 越少越好。
而是因為 AI Capability 本身就有 Cost。
當 Usage 放大,
一個看起來很小的資源浪費,
也可能一起被放大。
所以 Token Consumption 對我來說,
不只是另一個 Technical Number。
它更像是在提醒 PM:
AI 把很多事情做得更容易了,但「容易做到」不代表可以不計成本地做到。
AI Product 不只要驗證「做得到」,上線前也要驗證:為了做到這件事,我們用了多少資源,以及這個耗量是否值得。
以前我們透過中台、共用 Service、Reusable Component,
避免重複浪費開發資源。
到了 AI 時代,
Resource Efficiency 仍然是同一個 Product 基本功。
只是現在,
我們開始連每一次 AI Task 的耗量,
都可以一起拿出來衡量。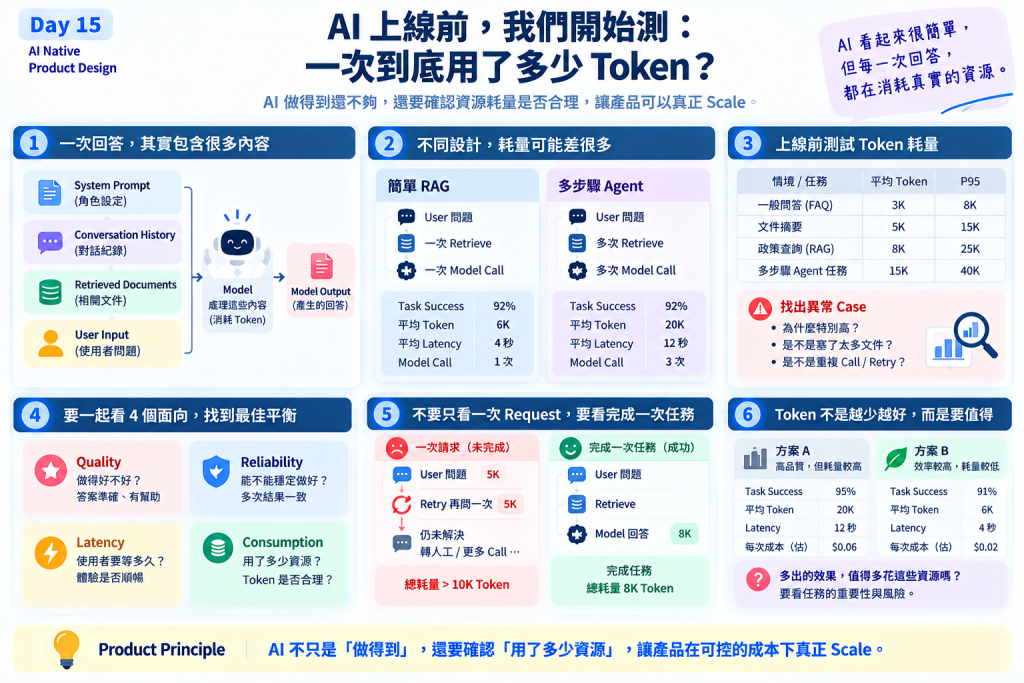


 iThome鐵人賽
 看影片追技術