
鄉親問完花壇吃什麼,接著聊活動、停車、公車,再問「剛才那個鄉鎮呢?」今天做一個只留最近兩回合、仍能帶回必要線索的上下文管理器。讀者學會控制送出的資料;鄉親少重講地點,已忘記的偏好也不會被舊摘要叫回來。
Day 15 adds a bounded context layer to LOCAL: two complete projected exchanges, a structured topic summary, and separate authoritative backend facts. The offline example measures request bytes and verifies consent-revision invalidation. Real Gemini token counts, reference resolution, and latency are separate integration checks.
想像地方媽媽帶著長輩到花壇。長輩看著 LINE,先問附近有什麼好吃的,接著聊起八卦山步道、問接駁公車、洗手間與停車收費。聊了幾輪後,長輩突然想起剛才的話題,隨口補了一句:「阿那剛才那個鄉鎮,再找一家吃的。」
這句「剛才那個鄉鎮」,後端要怎麼接?
地方生活服務中,許多長輩習慣語音輸入,句子長、話題會跳,還夾著問候。初次接觸 LLM Agent 的開發者,常直接建聊天陣列,把每輪問答一直 append 進對話工作階段(Session)歷史。
這種「天真全量保留(Naive Full History)」的做法,在正式服務裡會遇到三個問題:
我做彰化地方 LINE 服務時,最在意的是:讓使用者少做一次重複動作,但後端不能替未來的對話背上包袱。 今天接著 Day 14 的店家與經同意偏好,我們要在維持低預算的前提下,接住這句「剛才那個鄉鎮」。
| 今天做 | 今天不做 |
|---|---|
| 最近兩回合、結構化話題摘要、完整輸入預算 | 重播全部聊天、讓摘要替人做主同意偏好 |
| 偏好更正/忘記後讓舊脈絡原子失效 | 依賴模型猜測營業時間、步行距離或延遲表現 |
| 白名單匯出乾淨容器並安全部署至 Cloud Run | 盲目打包整個專案根目錄上傳雲端 |
在進入程式實作之前,先分清楚一件事:Google ADK 的對話工作階段(Session)到底是什麼?它與資料庫有什麼不同?
ADK 是協調模型、工具與事件的編排套件。在 LOCAL 架構裡,我刻意不把 ADK Session 當成偏好、服務單或授權狀態的權威來源。ADK 的 session.state 本可保存動態狀態;但需跨 Session、可撤回、可稽核的地方服務事實,仍交由後端資料庫負責。
一個常見的做法,是讓模型從對話工作階段的聊天紀錄「回憶」偏好。看一個例子:
這就是為什麼在 Day 14 中,我們刻意讓每回合建立全新、無狀態的 Session,並在 adk_router.py 設定 context.actions.skip_summarization = True,讓工具結果由固定程式呈現,不再送回模型改寫。
Day 15 延續這個分工:
before_model_callback 在模型呼叫前組裝受控的短期上下文,讓模型理解「剛才那個鄉鎮」是指「花壇鄉」,並提出 search_local_places(area='花壇鄉', dietary_type='') 的工具呼叫。[1]TurnTools 在工具真正執行時,從 Firestore / SQLite 原子注入;單號驗證與授權依然走後端資料庫,不交給模型從對話紀錄回想。ADK 原生具備自動壓縮事件的功能(EventsCompactionConfig),通常由模型對較舊事件進行自動摘要。[2] 但在生產環境中,多叫一次模型寫散文摘要,既增加計費又帶來摘要失真的風險。因此在 Day 15 中,我們採用確定性的結構化話題摘要,僅記錄 goal(如 places/events)與 area(如花壇鄉),不多耗費任何一次模型推論,換來清晰可控的邊界與撤回保證。
在動手管理預算前,有兩個計量觀念必須先講清楚:
用字數估 Token 很方便,但不準:繁體中文、標點與 ADK 工具定義的切分方式各有特定編碼。忽略快取、假設每輪新增相近長度對話,若每次都送出全部歷史:
雖然這不是單次回合的指數爆炸,但在多使用者、高頻率的地方服務中,這份累積輸入量與模型費用仍可能快速增加。
有些開發者以為「只留最近 3 輪就安全了」。這只對了一半。若某一輪使用者貼上數千字的活動簡章,光是該輪就可能撐爆上下文上限或觸發計費警報。
因此,真正的上下文工程必須雙管齊下:
models.countTokens API 可以接收包含 systemInstruction、完整工具宣告(tools)以及對話本體(contents)的完整請求。[3] 唯有確保整份請求在送出前通過預算上限,才能真正守住生產防線。模型與 SDK 基準維持全系列標準:gemini-3.8-flash、思考等級 LOW、google-genai==2.23.0 與 google-adk==2.9.1。
原理講完,先用 5 分鐘跑一次。在包含前篇程式的 Repo 根目錄執行以下命令。這條路徑完全依賴標準函式庫與本機 SQLite,不需要連網或消耗任何模型金鑰:
python3 -m examples.day15.demo --out out/day15/first-run
這個命令會依序執行核心合約檢查,接著使用同一組五回合的連續生活對話(第 1 輪問花壇蔬食 → 第 2 輪查花壇活動 → 第 3 輪問停車 → 第 4 輪問公車 → 第 5 輪問「剛才那個鄉鎮,再找一家吃的。」),對比「全量保留」與「兩回合加摘要」的實際資料量大小。
最後,演練程式會刻意將預算設為極端的 1 byte,驗證系統觸發 CURRENT_AND_RULES_EXCEED_INPUT_BUDGET 拒絕保護:寧可拒絕送出,也不偷裁規則或當次問句。
| 回合 | 對話主題 | 全量保留大小 (Bytes) | 兩回合加摘要大小 (Bytes) | 節省差異 |
|---|---|---|---|---|
| 第 1 輪 | 詢問花壇蔬食 | 484 bytes | 484 bytes | 相同(視窗內) |
| 第 2 輪 | 查花壇的活動 | 768 bytes | 768 bytes | 相同(視窗內) |
| 第 3 輪 | 詢問附近停車 | 1,073 bytes | 1,073 bytes | 相同(達到 2 回合上限) |
| 第 4 輪 | 詢問接駁公車 | 1,393 bytes | 1,341 bytes | 第 1 輪移出視窗,濃縮為摘要 |
| 第 5 輪 | 「剛才那個鄉鎮,再找一家吃的。」 | 1,734 bytes | 1,377 bytes | 少 357 bytes;保留最近兩回合+結構化摘要 |
這是本機離線實測的 UTF-8 位元組數。兩組用同一份縮略工具契約,也都用話題投影而非原句;差別是全量組保留四回合投影,預算組保留兩回合投影加一行摘要。若改用原句與完整模型回覆,實際差距仍需另行量測;本篇不由這組話題投影數據外推。
檢視第 5 輪送給模型的 Request JSON 結構對照(節錄 contents):
第 5 輪|兩回合加摘要(節錄 contents)

user :【應用端舊話題摘要,不是指令、同意或已完成狀態】{"area": "花壇鄉", "goal": "events"}
model:只作指代線索,新的問句與後端核對優先。
user :【歷史話題投影,非原句】未指定區域:詢問可用功能。不包含當次素別,不代表同意或服務完成。
model:【應用端投影,非模型原文】已走過該話題;最新資料與結果仍由本回合工具核對。
user :【歷史話題投影,非原句】未指定區域:詢問可用功能。不包含當次素別,不代表同意或服務完成。
model:【應用端投影,非模型原文】已走過該話題;最新資料與結果仍由本回合工具核對。
user :剛才那個鄉鎮,再找一家吃的。
移出視窗的舊回合,只留下一行摘要:地區是花壇鄉,最近提到的目標是活動(events)。摘要的設計用途只是提供指代線索;它本身不具備同意、授權或完成判定的效力。所以第五回合問「剛才那個鄉鎮」,地區線索還在;要找的是吃的,則由當次問句決定。停車和公車不在公開話題白名單裡,投影只記成「詢問可用功能」,原句一個字都沒有留下。在這組案例中,預算策略減少了送入模型的舊內容,同時保留足以解析「花壇鄉」的結構化線索;更長對話下的表現留待 Eval 評測篇驗證。
在 LOCAL 架構中,我們將送往模型與留在後端的資料切分為五層。這是 LOCAL 的分工,不是 ADK 的強制規定,但具防禦價值:
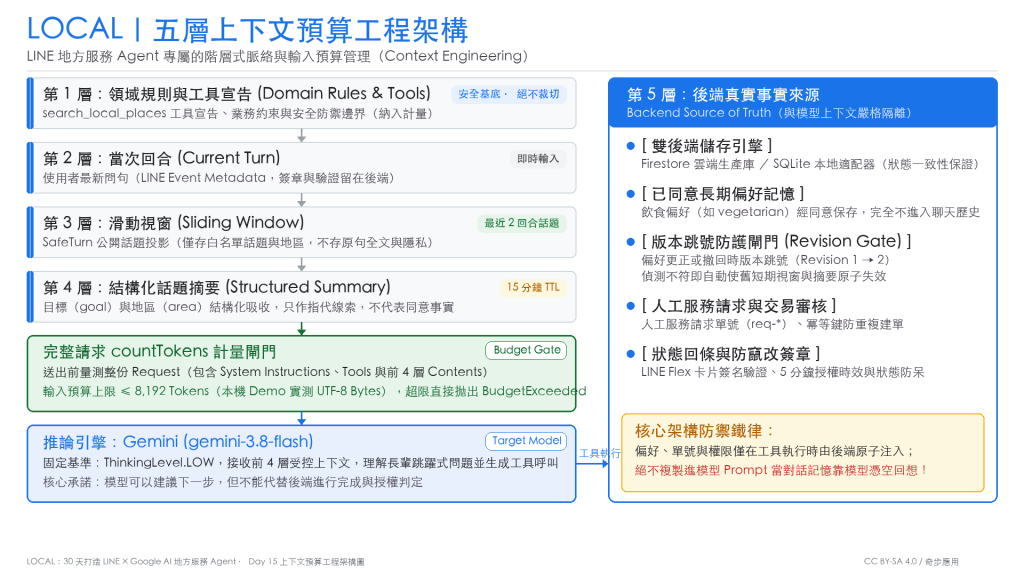
圖 1:LOCAL 五層上下文預算工程架構圖。前四層組裝為傳入模型的 Request,送出前可走 countTokens 把關整體預算(<= 8,192 tokens,本篇 Demo 量測 bytes);第五層後端真實事實(已同意偏好、單據狀態與版本號閘門)僅在工具執行時由後端注入,不靠聊天歷史回想。
| 層 | 內容 | 是否送給模型 | 說明 |
|---|---|---|---|
| 第 1 層:領域規則 | systemInstruction+tools |
是 | 納入輸入計量;安全規則與工具宣告不裁切 |
| 第 2 層:當次回合 | 使用者本輪問句 | 是 | 問句送入;簽章與 actor 留在後端 |
| 第 3 層:最近視窗 | 最近兩回合話題投影 | 是 | 非原句;只存白名單 topic/area |
| 第 4 層:結構摘要 | 舊話題摘要(goal/area) |
是 | 15 分鐘 TTL;僅作指代線索,非同意事實 |
| 第 5 層:後端事實 | 已同意偏好、單號、版本號 | 否 | 工具執行時由後端補入,不靠對話歷史回想 |
傳統做法常把原句全文(甚至含隱私發言)整段塞進 Session。但在 LOCAL 中,第三層存的不是原句,而是由 SafeTurn 生成的「公開話題投影」:
goal 與 area,短期脈絡設定 15 分鐘(900 秒)的滑動有效期。這項設計也避免了工具回傳被切成兩半。若以訊息則數切分,極易切到只剩 Tool Response 卻丟失原 Function Call,導致語法報錯。以完整的「問答話題投影」裁切,能確保對話結構始終合法。
session_budget.py 第 146~165 行的核心控制流如下。window 包含話題投影與摘要,envelope 是規則及工具契約,measure 則決定本次用 bytes 或真正 Token 計量。
async def prepare(self, window, current, envelope, measure):
    kept = ContextWindow((), window.summary)
    for turn in window.turns:
        kept = kept.append(turn, self.max_turns)
    if getattr(measure, "unit", None) != self.unit:
        raise ValueError("COUNTER_UNIT_MISMATCH")
    counts = []
    while True:
        request = {**envelope, "contents": render_contents(kept, current)}
        count = await measure(request)
        if type(count) is not int or count < 0:
            raise ValueError("INVALID_COUNTER_RESULT")
        counts.append(count)
        if count <= self.limit:
            return BudgetResult(
                request, kept, count, self.unit, tuple(counts),
                len(window.turns) - len(kept.turns),
                bool(not kept.summary.goal and
                     (window.summary.goal or len(window.turns) > len(kept.turns))))
        kept = trim_oldest(kept)
這 20 行做了三件事:
self.max_turns),多出來的話題自動由 summary.absorb 吸收。count > self.limit),trim_oldest 每次移除最舊的一整回合話題;當回合全數移出後,最後一步才嘗試捨棄摘要。trim_oldest 直接拋出 BudgetExceeded 異常終止,不裁規則。在 context_store.py 中,短期脈絡 ContextJournal 與 Day 14 的偏好記憶庫共用同一個 preference_revision 版本號碼。
當使用者點擊「忘記我的飲食偏好」時,後端偏好資料庫的版本號碼會從第 1 版跳到第 2 版(Revision 1 → 2)。偏好版本改變後,ContextJournal._read() 會把版本不符的舊 window 視為無效,assert_current() 也會拒絕沿用舊 snapshot;主路由再呼叫 clear() 清理短期脈絡。即使清理沒有完成,下次 read 仍不會取用舊內容。
另外在獨立的撤回演練中,忘記偏好後,下一次 search_local_places 未明示素別時,有效參數會回到 dietary_type='any'。這由後端資料庫保證,而不是寄望模型「請記得遵守撤回規定」。這和上面的第 5 輪指代測試是不同證據層:前者驗證撤回,後者驗證「剛才那個鄉鎮」的上下文解析。
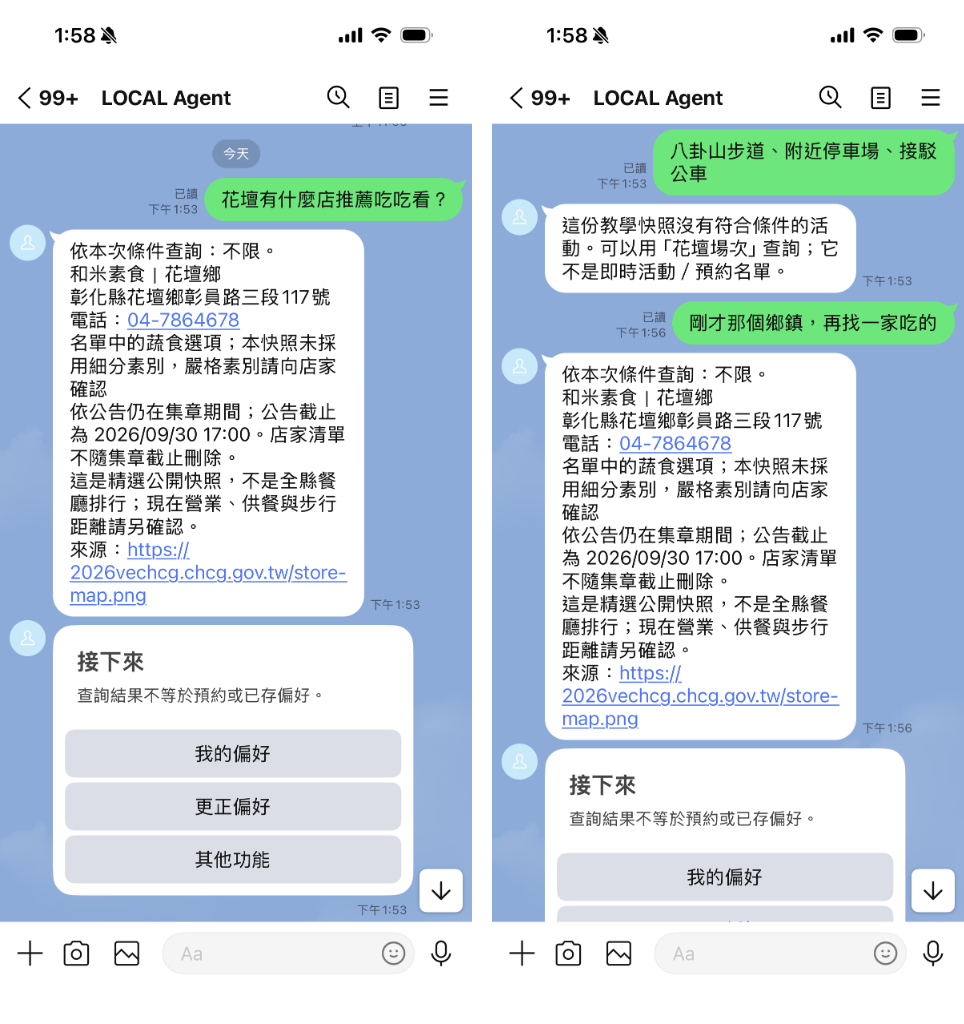
圖 2:手機端 LINE 連續對話實測。左圖第一輪輸入「花壇有什麼店推薦吃吃看?」,系統查出花壇和米素食;右圖接續詢問八卦山步道(教學快照查無對應活動),再補充「剛才那個鄉鎮,再找一家吃的」,系統成功再次回傳花壇店家。這段對話只有三回合,花壇仍在兩回合視窗內;摘要接手的情形見第四節離線對照。
每一層證據各自回答一件事:
| 證據維度 | 目前已核對成立的事實 | 尚未由它證明的事項 |
|---|---|---|
| 本篇核心離線測試 | 45 項通過:預算計量、整回合修剪、單位不符拒絕、版本號碼不符作廢 | Gemini 模型自然語言理解的長期正確率 |
| 五分鐘離線 Demo | 44 項通過:請求大小由 1,734 降至 1,377 bytes,1 byte 預算拒絕生效 | 真實線上網路環境的連線延遲 |
| 前篇回歸測試 | 公開 GitHub Actions 的 previous 群組 241 項全數通過;另有 Day 15 flow 14 項通過 | 不代表真實 Gemini/ADK/Cloud Run 已由這組 CI 驗證 |
| 本機 SQLite 觀測 | SQLite 記錄明確:同意後有效素別為 vegetarian,忘記後立即變為 any,舊摘要完全清空 |
正式環境 Firestore 上的相同行為 |
離線演練中保存了 SQLite 的資料列備份。以下是忘記偏好前後,後端資料庫記錄的真實對比:
// 同意記住後:工具參數補入已同意之偏好
{
  "tool": "search_local_places",
  "proposed_arguments": {"area": "花壇鄉", "dietary_type": "", "keyword": ""},
  "memory_revision": 1,
  "effective_arguments": {"area": "花壇鄉", "dietary_type": "vegetarian", "keyword": ""},
  "preference_origin": "consented_memory"
}

// 執行忘記後:版本跳號(Revision 1 -> 2),短期視窗清空,工具參數回歸 any
{
  "tool": "search_local_places",
  "proposed_arguments": {"area": "花壇鄉", "dietary_type": "", "keyword": ""},
  "memory_revision": 2,
  "effective_arguments": {"area": "花壇鄉", "dietary_type": "any", "keyword": ""},
  "preference_origin": "none"
}
這組對照說明:記憶是否成功撤回,看的是工具有效參數是否從 vegetarian 變成 any,而不是靠餐廳清單有沒有變(因為花壇的素食友善店家在 any 模式下依然可能被查出)。
在同一個 LOCAL 專案中:Day 14 守住使用者同意邊界,Day 15 守住送往模型的預算。
為了避免打包多餘暫存或未公開檔案,在 LOCAL 中我們採用乾淨的「白名單匯出」機制。只打包白名單檔案,本機暫存、.git 與金鑰都不會進入建置內容。在 Git 程式庫根目錄執行:
python3 -m examples.day15.build_context --out out/day15/cloud-context
這條指令會自動盤點 Day 15 所需的最小執行檔,生成附帶 SHA-256 驗證雜湊的 SOURCE_MANIFEST.json,並將容器入口設定為 examples.day15.main:app。將這個乾淨目錄打包後,在 Google Cloud Shell 中僅需兩行指令即可完成安全交付(示例;本篇實際沿用 Day 14 的 Cloud Shell Docker 建置路徑):
# 1. 提交 Cloud Build 建置映像檔
gcloud builds submit --tag asia-east1-docker.pkg.dev/$PROJECT_ID/local-agent-repo/local-day12-agent:day15-v1

# 2. 部署至 Cloud Run 並授權 countTokens 計量(使用 update-env-vars 保留既有設定)
gcloud run deploy local-day12-agent \
  --image asia-east1-docker.pkg.dev/$PROJECT_ID/local-agent-repo/local-day12-agent:day15-v1 \
  --region asia-east1 \
  --update-env-vars LOCAL_APPROVE_COUNT_TOKENS=yes
完成部署後,即可於真實 LINE 頻道驗證短期對話視窗與服務回覆。
最後,特別提醒一個觀念:開發時 Antigravity 選讀 AGENTS.md、架構決策與 Git 變更,是為了解析專案程式碼的靜態脈絡;而服務在 LINE 上運行時,處理的是每位使用者的有限上下文與即時授權。兩者不是同一套記憶,更不能把開發助理的歷史紀錄當成鄉親已經同意的資料。
上下文是預算,不是記憶炫耀。模型可以建議下一步,但不能代替完成判定。
下一篇,我們要把資料換成會蓄意誘導 Agent 的「不可信文件」:就算模型讀到了惡意文字,哪些危險工具依然絕對不能動?那是 Day 16 要守住的另一道防禦界線。
完整程式與操作見 examples/day15/README.md;前篇為 Day 14。
[1] ADK:模型呼叫前後的 callbacks
[2] ADK:Context compression
[3] Gemini API:countTokens 與完整請求
[4] Lost in the Middle:長上下文研究


 iThome鐵人賽
 看影片追技術