
Day17 的 Answer Relevancy 看的是回答有沒有切題,但切題不代表可靠。今天要看的是 Faithfulness(忠實度):模型的回答,是不是真的有憑有據。
假設使用者問「特休一天需要提前幾天申請?」,Retriever 找回來的 Context 只有一句話:「員工申請特休,須提前 3 天向主管提出申請。」模型的回答是:「特休需要提前 3 天向主管申請,逾期者一律不核准。」這個回答非常切題,Answer Relevancy 會拿到高分。但仔細看,「逾期者一律不核准」這句話,Context 裡根本沒有寫,是模型自己加上去的。Faithfulness 要抓的,就是這種「Context 沒寫、模型卻說了」的內容,也就是常說的幻覺(Hallucination)。
Faithfulness 的計算方式是把回答一句一句拆開來驗。首先把回答拆成一個個獨立的陳述(claim),接著請 LLM 逐一檢查,每個 claim 能不能從 Context 推得出來,最後用「有依據的 claim 數量 ÷ 全部 claim 數量」算出分數。
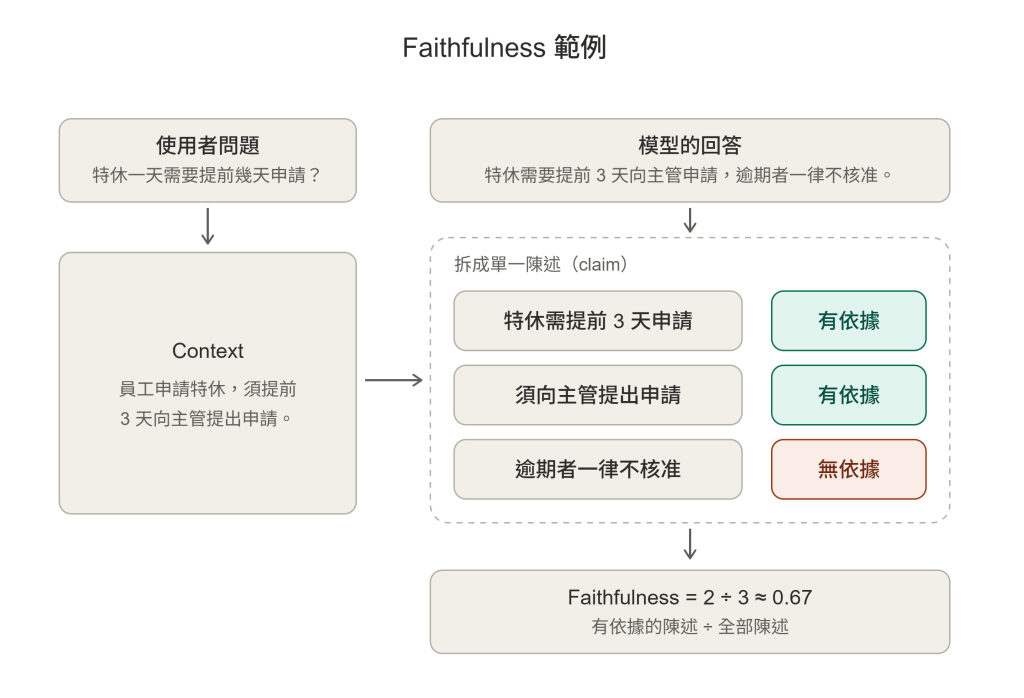
以剛才的回答為例,可以拆成三個 claim,「特休需提前 3 天申請」有依據、「須向主管提出申請」有依據、「逾期一律不核准」沒有依據。三個裡面有兩個站得住腳,Faithfulness 就是 2 ÷ 3,約 0.67。
最容易誤會的一點是:Faithfulness 對照的是 Context,不是事實。如果 Context 本身寫錯了(例如寫成 5 天),模型忠實照抄,Faithfulness 依然是滿分。所以它衡量的是「有沒有亂加」,不是「對不對」,「對不對」要留給下一個指標。它和 Context 系列指標也有連動,當 Context Recall 偏低,關鍵資訊沒被找回來,模型在資訊不足的情況下,很容易用自己的「印象」補上去,Faithfulness 就跟著下降。
當分數偏低時,可以先檢查 Prompt 有沒有明確要求「只能根據提供的 Context 回答」;也要看 Context 是不是缺少關鍵資訊,讓模型自己補洞,這時可以回頭看 Context Recall 與 Context Entities Recall。另外,Context 裡如果有互相矛盾的內容,模型只好自己選邊,或是模型過度推論,把 Context 沒說的細節當成理所當然,也都會拉低分數。
Faithfulness 讓我們知道,回答有沒有超出 Context 的範圍。但如果 Context 本身就是錯的、過時的呢?忠實地照抄一份錯誤資料,也不會是正確答案。下一篇,我們來看 Factual Correctness(事實正確性),把回答直接拿去跟標準答案比對。


 iThome鐵人賽
 看影片追技術