
Day 11 的「一間店準,不等於一百間店都準」裡,我留了一個伏筆:
怎麼知道夠準? 要回答「這間店是否滿足上線標準」,需要有標註可以比對。
昨天 Day 15 介紹了演算法調校平台,怎麼把調校任務交出去、讓上線時程縮短。今天講「準」:我們怎麼用車輛旅程生成器自動產生標註。它跟線上的得來速系統不同,沒有即時的延遲限制,所以我們可以在產生標註上投入更多資源與算力,用比線上產品更複雜的演算法換取準確度。
衡量車輛這套系統準不準,得先有一份標註:上線前準備一定數量的樣本,每筆樣本記錄車輛在各個狀態的時間戳記 — 標註的單位是一條軌跡,所以我們稱它為 track-wise ground truth。
過去這份答案怎麼來?人工標註。
我們會請標註員把影片一段一段看過,把每一台車在排隊、點餐、等餐、取餐各階段的時間戳記標出來。然後拿這份答案跟演算法跑出來的結果比對,算每個狀態的準確度,確認有沒有過門檻。
人工標註有兩個問題:
第一,耗時。 標一小時的影片要花多久?內部統計下來,平均至少 3 個人力小時。
第二,人會累。 標註員不是 24 小時都在工作,連續看好幾個小時得來速的影片,任何人的標註品質都會下降。如果標註錯誤,在演算法調校工具上,反而要花很多時間反覆驗證標註:到底是演算法的問題,還是那天標註品質的問題?
只要標註還是靠人工生產,我們的天花板就永遠被綁在人力上。 因此我們決定自己做一套車輛旅程生成器。
我們把這個任務拆成三個小題目:
做這題的契機,是看到近年 SAM (Segment Anything Model) 這類視覺模型在各種資料集上都拿下最好的成績。所以任務初期,我們直接拿 SAM2 當演算法核心做車輛追蹤。這套做法在簡單的場域下準確率很好,但一到複雜場域 (車子頻繁遮擋、交錯),mask 就追不動了。原因是 SAM2 做單相機追蹤時得把片段結果整合起來,而片段匹配只有 mask 資訊可用;遮擋一發生,被截斷 (truncated) 的 mask 很難對得上,就會發生 ID switch,也就是同一台車的編號中途被換掉。
為了解決這個問題,我們回頭用追蹤的經典做法 TBD (tracking-by-detection)。公司現有的 Detector 是用完整車身框 (full box) 的標註資料訓練的,車子被擋住時也能推估被擋住的那一段。此外,我們還更貪心地想用上 SAM2 提供的 mask 資訊,因此參考了 McByte (論文、程式碼),改以 detection 為主、mask 為輔的方式做推論。
一句話總結演算法架構:簡單的情境用 ByteTrack 追蹤就夠,只在有需要時才把 mask 的資訊拿出來用。
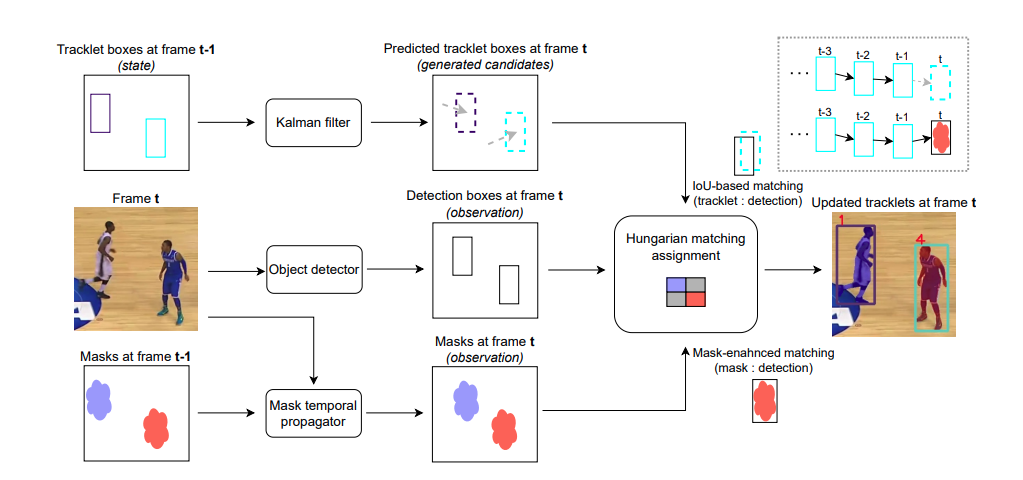
(圖片來源:McByte 論文)
什麼時候叫 mask 出來幫忙?有兩種情況:
遇到這兩種情況,才會把 mask 拿出來檢查。先定義兩個數字 mc 與 mf,用來衡量軌跡片段 (tracklet) 的 mask 跟偵測框重疊得好不好,兩者都以像素數計算、範圍都在 0 到 1 之間:
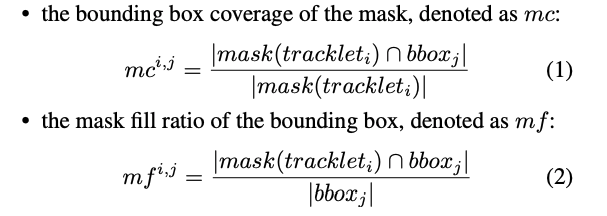
(圖片來源:McByte 論文)
接著檢查四個條件:
滿足這四個條件後,演算法才會把 mf 值放進 Cost Function 內。
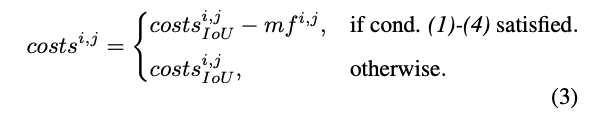
(圖片來源:McByte 論文)
這個設計的好處是:用 TBD 做法的同時,我們也保留了 SAM2 提供的 mask 證據。而且 mask 只是輔助,車子形狀變化造成的 mask 抖動不太會汙染追蹤結果。
單相機的軌跡再準,也只是「某一支相機裡的某一台車」。我們要的是同一台車的完整旅程。一間店有五到十支相機,一趟旅程就要跨好幾次相機,每一次交接都得接對。
「點餐」跟「取餐」通常在一支相機裡就能判定,斷一段不影響;但「排隊」跟「等餐」會橫跨多支相機,每一次交接都得匹配成功。整條鏈是連乘的 — 只要其中一段失敗,其他段全對也一樣整趟作廢。
這個任務分兩個面向:車輛的特徵向量 (embedding) 怎麼取 (接下來的一、二),以及 跨相機配對怎麼設計 (接下來的三)。
一開始我們是直接沿用 SAM2 image encoder 的特徵當作 ReID (跨相機重新識別同一台車) 的依據,畢竟 mask 都產生了,特徵也很方便就能拿到。但實驗發現這組特徵效果並不好,原因出在:SAM2 訓練時的下游任務並沒有真正學習外觀。
A ≠ B 的證據。所以我們換掉了特徵來源,改用 DINOv2。
比起 SAM2,DINOv2 的訓練目標剛好就在學我們要的東西。它是自監督的 teacher / student 架構 (teacher 為 student 的 EMA),同時使用三種 loss:
實際取特徵向量的流程是:拿偵測框把車子連同周圍一點環境裁出來,用 SAM2 的 mask 把背景壓掉,丟進 DINOv2,再把 CLS token (整體 semantic) 跟 patch token (車體細節) 接成一個向量。
我們的場域還有一個要特別處理的情境:一台車進來看到車頭、經過看到側面、離開看到車尾,如果把整條軌跡的特徵向量取平均當代表,得到的可能是一個誰都不像的向量。
所以一條軌跡不會只留一個向量。我們把同一個 ID 的特徵向量先做分群,每群留一個代表 (取 medoid 而非平均,避免被離群值拉走);跨相機比對時用集合對集合 (set-to-set matching) 的方式比,讓下游相機看到的車尾去對上游相機的車尾。信心分數太差的 mask 不會進入分群。
跨相機配對靠三樣東西做決定:相機排序、時間限制、外觀距離。相機排序決定哪兩支相機之間需要配對,時間跟外觀決定這兩台車是不是同一台。
配對分成兩步:
第一步:修復單相機內斷掉的軌跡 (broken track)。
在跨相機配對之前,會先把單相機內部斷掉的軌跡修好。這裡參考 GTA (Global Tracklet Association) 的概念:它不動前面的 tracker,而是在追蹤跑完之後,對軌跡片段重新匹配一次,分成兩半:
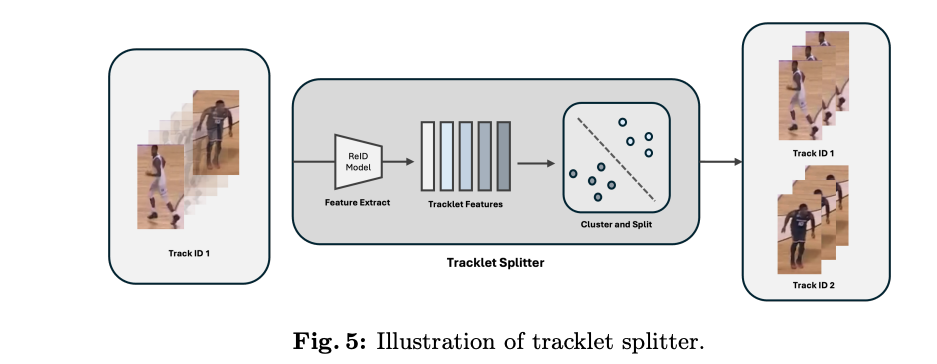
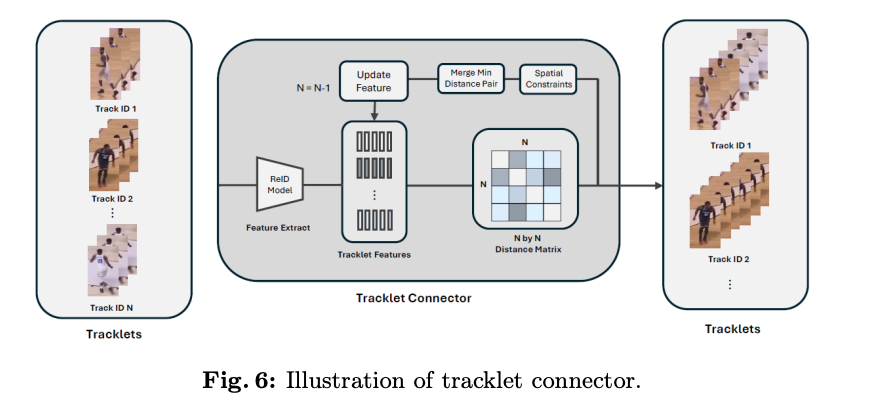
(圖片來源:GTA 論文)
我們只用 Connector 這一半,再補上得來速特有的幾何限制。兩段軌跡片段要能接起來,必須同時滿足:
為什麼要多加幾何限制,而不是像 GTA 一樣純靠外觀?因為 GTA 的場域是球場,球員能自由移動、離場再回來,外觀幾乎是唯一線索;得來速的車被車道綁死,方向是確定的。這個先驗剛好能分辨「同一台車斷掉」跟「下一台車開到同一個位置」 — 同款同色的車太多,純看外觀很難分。
第二步:相鄰相機之間建立 Cost Matrix。
Cost Function 由三個部分構成:
車輛旅程生成器產生的軌跡會再丟進旅程 (journey) 演算法 (類似 Day 14 介紹的狀態機做法),得到每台車的旅程,這份旅程資料就是我們要的標註。但在相信它之前,得先回答:憑什麼要相信它?
我們的做法是找幾個只看產出的旅程、完全不需要預標註的指標,當作上線前的品質關卡 (Quality Gate)。我們以其中的兩個指標做說明:
| 指標 | 條件 |
|---|---|
p_no_o |
有取餐、卻完全沒有點餐階段的旅程佔比 |
o_no_p |
反過來,有點餐卻沒有取餐的佔比 |
p_no_o 的道理很簡單:幾乎每一台開到窗口取餐的車,都應該在某個地方點過餐。 所以這個比例一高,多半就是跨相機配對把車接丟了。
o_no_p 是 p_no_o 的鏡像。雖然車子確實可能點完餐就直接開走,但如果一間店的取餐相機偵測率偏低,這個指標也會長期偏高。
車輛旅程生成器現在還有兩件事沒做完。
1. 部署到更多店做演算法驗證
車道配置、相機角度、車流量,每一間店都不一樣,目前驗證過的場域還是太少。接下來會把生成器跑更多店驗證,一方面確認演算法在各種場域撐不撐得住,一方面也需要足夠的數據決定品質關卡的門檻該訂在哪。
2. 訓練自己的 ReID 模型
DINOv2 是通用模型,沒看過得來速,也沒有針對 ReID 任務 做過訓練,我們只是拿它的泛用特徵來用。之後會用得來速場域的資料訓練一個專門的 ReID 模型,把跨相機配對的天花板再往上抬。
車輛旅程生成器做的事,是把「產生標註」從人力密集轉換成算力密集。一旦做好,我們能做到:
車輛旅程生成器給的是離線、上線前、可以慢慢算的標註。但上線之後,不可能每一天、每一間店都生一份標註。這時候就會輪到 ALI / ALO 上場,在沒有標註的情況下統計錯誤案例,把「這間店今天準不準」變成一個能監控的數字。前面幾個品質關卡,其實就是這個想法的雛形。
介紹完車輛旅程生成器,ML Team 的第三塊也就補齊了。剩下的最後一塊拼圖,就留到 Day 17 的 ALI / ALO。
單相機追蹤
車輛外觀特徵 (ReID)
跨相機整合
本系列由 Berry AI 工程團隊出品。更多工程實戰紀錄都在 Berry AI 技術部落格。


 iThome鐵人賽
 看影片追技術