
安安~我是ChiYu~
昨天,我拒絕把 AI 給出的 48、84、156 小時直接當成承諾,因為那些數字缺少足以支撐它們的來源、假設與失效條件。
寫到 Day 30,我想先把這個系列最核心的問題正式回答一次:CLEAN 五原則,到底是怎麼從 Clean Code、AI Coding 實驗與 User 責任一路長出來的?
這次來源稽核後,我留下兩個重要結論。第一,CLEAN 的每一項責任,都能連回多個 Clean Code 品質觀念與系列案例;第二,它們無法一對一配給某個章節,也不能因為引用原書與公開貼文,就被寫成既有標準。
所以這篇不再新增 Production Code,也不比較三組候選,而是回頭整理一條完整推導路徑:
Clean Code 品質要求 → AI Coding 實驗暴露的協作問題 → User 必須承擔的動作 → CLEAN 五原則
如果每個字母最後只剩一句好記的口號,前面二十九天的 Prompt、Diff、測試與失敗案例就沒有真正接起來。我要重新確認四件事:
來源追溯不是替 CLEAN 找權威背書,而是把每項主張連回可查依據,分清楚原書、公開貼文、系列實驗與作者判斷各自負責什麼。
CLEAN 承接 Clean Code 的品質要求,處理的則是 User 操作 AI Agent 時的責任。我先把第二版、兩則 X 貼文、系列實驗與自己的框架整理分開:
| 來源 | 提供了什麼 | 本次來源不能支撐的結論 |
|---|---|---|
| 《無瑕的程式碼 第二版》 | 從 Code、Design、Architecture 到 Craftsmanship 的品質觀念與工程責任。 | 書中沒有提出 CLEAN 五原則,也沒有替這套框架背書。 |
| Uncle Bob 的兩則 X 貼文 | 減少逐行閱讀 Agent Code,改看測試、結構、品質指標與工程關卡的工作方式。 | 貼文沒有定義 CLEAN,也沒有證明所有專案都能停止逐行 Review。 |
| 我近期的 AI Coding 經驗與系列實驗 | 模糊需求、範圍擴張、錯誤假設、自我宣告完成、行為漂移等反覆出現的協作問題。 | 這些個案不能直接外推成所有模型、Repository 與團隊的固定結論。 |
| CLEAN 五原則 | 我把前面三條線整理成 User 使用 AI Agent Coding 時的五項責任。 | CLEAN 不是 Agent 自己跑完的檢查表,也不取代 Clean Code。 |
推導順序很重要。我不是先決定 CLEAN 這五個字母,再回頭替每個字母尋找章節;而是先把二十九天裡反覆出現的缺口分類,再整理出 User 必須重複執行的五項動作。
《無瑕的程式碼 第二版》不只討論函式與命名,也一路處理設計、架構與軟體工藝。
| 層次 | Clean Code 的品質問題 | AI Coding 放大的風險 |
|---|---|---|
| Code | 名稱、註解、函式、物件、類別與測試,能不能清楚表達局部意圖? | Agent 可能產生表面整齊、實際語意仍需猜測的 Code。 |
| Design | 規則、介面、元件與並行流程,能不能承受下一次改變? | Agent 可以快速增加抽象,也可能把目前需求誤寫成永遠成立的設計。 |
| Architecture | Use Case、資料庫、UI、Framework 與外部服務之間,政策與細節是否維持正確依賴方向? | Agent 容易依現有資料夾與技術慣例補完架構,未必知道真正需要保留的選項。 |
| Craftsmanship | 工程師如何證明、改善、合作、估算並對結果負責? | 產碼速度提高後,完成宣告、測試品質、團隊交接與風險責任更容易與實作者分離。 |
Code 處理局部意圖;Design 檢查規則改變時,責任應該落在哪裡;Architecture 保護核心政策,不讓資料庫、UI、Framework 或第三方細節反過來決定形狀;到了 Craftsmanship,問題則回到工程師如何證明完成、交接成果並承擔風險。
這也解釋了為什麼 AI 時代仍然需要 Clean Code。人類也許少讀一些 Implementation,Agent 仍要在 Repository 裡搜尋名稱、追蹤呼叫、理解型別、辨識邊界並完成修改。AI 改變了產生與閱讀程式碼的角色,沒有消除理解、修改、驗證與負責的成本。
Uncle Bob 在兩則 X 貼文裡談到,他會減少逐行閱讀 Agent Code,把 Review 重心移到測試、QA 流程與 Coverage,也檢查 Mutation Testing、依賴結構、循環複雜度及模組大小。
我認同這個方向,但品質關卡涵蓋哪些風險,仍需要人定義與解讀。
測試全綠,可能只是沒有測到二十四小時的等號;介面能編譯,Provider 的行為契約仍可能不相容;資料庫擋下第二次更新時,第二封通知甚至可能早已送出。品質訊號值得看,User 還得知道它證明到哪裡,又漏掉什麼。
我把前面二十多篇文章重新分類,整理出五種重複出現的協作缺口:
| 協作缺口 | 系列裡的代表觀察 | 收斂出的 User 責任 |
|---|---|---|
| 缺少真實 Repository Context | Day 2 的模糊指令仍得到合理候選,但清理目標與停止位置都由 Agent 自行決定。 | C:先查證情境,再允許 Agent 補完。 |
| 未驗證範圍持續擴張 | 函式拆分可能增加跳轉;一次大批修改也可能把多項風險綁在一起。 | L:限制同一批尚未驗證的決策與副作用。 |
| 意圖與邊界說得不夠清楚 | 格式正確的名稱仍會誤導;可編譯的 Provider 也可能不符合行為契約。 | E:把名稱、角色、契約、依賴與副作用寫清楚。 |
| 完成宣告缺少可重建來源 | 測試全綠沒有說出涵蓋範圍;精確工時也可能沒有實際歷史資料支持。 | A:保存原始輸入、版本、驗證、失敗與人工裁決。 |
| 綠燈以外仍有行為漂移 | 二十四小時等號沒有真的被測到;並行流程可能產生第二次通知。 | N:先定義外部答案,再檢查候選是否偷偷改變它。 |
五項 CLEAN 就是從這些 User 責任整理出來,而且每一項都橫跨多個 Clean Code 觀念與系列案例。
這次選擇文件型稽核,是因為我要驗證每項主張能不能追到來源,以及現有案例允許結論走到哪裡。新增另一份程式碼候選,回答不了這兩個問題。
這次文件型稽核固定使用以下資料與通過條件:
| 稽核項目 | 固定內容 |
|---|---|
| 輸入 | 第二版的 Code、Design、Architecture、Craftsmanship 四大部分、Uncle Bob 兩則 X 貼文,以及 Day 2~29 的文章與公開實驗資料。 |
| 第一輪 | 讓 AI 擔任 Evidence Mapper,只負責把主張連到來源、文章與代表案例。 |
| 第二輪 | 改用反方 Reviewer,刻意尋找錯誤歸因、一對一硬配、過度外推與證據缺口。 |
| 通過條件 | 每項 CLEAN 都要找到品質基礎、AI 協作問題、User 動作、代表案例與適用邊界。找不到來源時,標示為作者判斷或未知。 |
| 人工責任 | AI 加速搜尋並提出反例;來源是否成立、主張要限縮到哪裡,由我裁決。 |
兩輪共用同一批資料,也位於同一項文章整理工作,沒有獨立實驗所需的 Session 隔離與控制條件。這是兩階段來源稽核,不能寫成兩組模型效能實驗。
Evidence Mapper 擅長整理支持材料,也可能順著原有分類補齊論證;反方 Reviewer 則專門尋找錯誤配對與證據缺口,用來抵銷這個偏差。
稽核結果顯示,五項 CLEAN 都能追到多個 Clean Code 品質觀念與系列案例,但沒有任何一項能固定對應單一章節。反方 Review 修正了四個過度主張:每個 CLEAN 字母不能固定配給單一章節;現有個案尚未涵蓋所有 AI Coding 風險;工具無法自行承擔 User 責任;目前也沒有足夠資料證明 Clean Code 必然節省 Token。
| CLEAN 原則 | Clean Code 品質基礎 | AI Coding 反覆出現的問題 | User 應負責的動作 |
|---|---|---|---|
| C — Context-Aware Code 情境感知 | 有意義的命名、領域語言、簡單設計、架構邊界與團隊合作,都要求決策建立在真實問題上。 | Agent 看到資料夾、框架或常見模式後,容易把「一般會這樣做」補成專案事實。 | 提供並查證需求、Repository 規則、領域語言、既有行為、團隊與部署情境;證據不足時保留未知。 |
| L — Localized Change 局部變更 | 小而聚焦的函式與類別、單一改變理由、持續設計與小週期,都在縮小變更半徑。 | Agent 能一次改很多檔案,也容易順手重構、過度拆分,讓錯誤與回復範圍一起變大。 | 定義單一變更理由、允許與禁止範圍、Checkpoint 及停止條件;要求每一行 Diff 都能對回本次需求。 |
| E — Explicit Intent and Boundaries 意圖明確 | 命名、型別、物件角色、SOLID、元件原則與 Dependency Rule,都在讓責任和依賴可被讀懂。 | 模糊 Prompt 會讓 Agent 自行決定 Model 角色、契約、失敗語意與副作用順序。 | 說清楚資料角色、狀態、依賴方向、跨界資料、錯誤、外部副作用與誰擁有決策。 |
| A — Auditable by Evidence 實據可審 | 測試紀律、驗收測試、可重複的證明、小週期與誠實估算,都要求主張能被重查。 | Agent 的自我報告可能省略失敗過程、環境限制、未測範圍與人工取捨。 | 保存 Prompt、模型條件、起始版本、Diff、原始測試與工具輸出、失敗紀錄、人工決策及未知。 |
| N — Non-Surprising Behavior 符合預期 | 測試、行為契約、並行設計、架構獨立與不造成傷害,都要求修改後維持已承諾的答案。 | 重構可能悄悄改變 HTTP Contract、資料、通知次數、順序、取消與失敗路徑。 | 先定義可觀察行為與禁止改變項目,再用 Unit、Acceptance、E2E、契約及並行測試依風險驗收。 |
完整矩陣與反方覆核結果整理在 Day 30 Public Evidence。
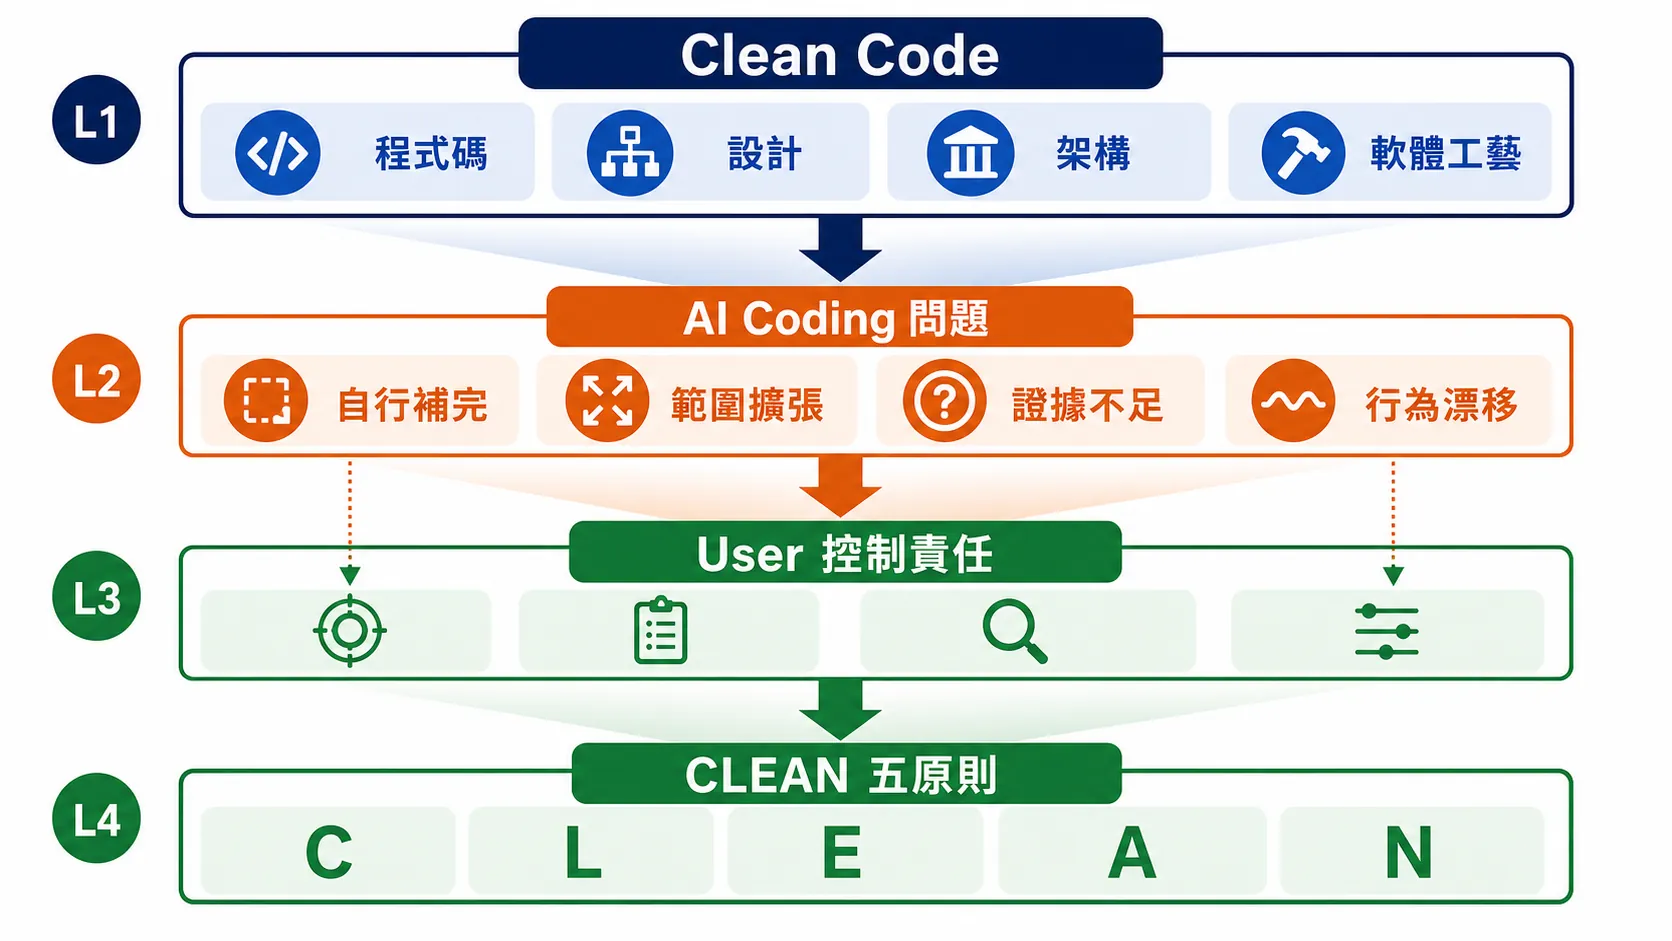
圖:CLEAN 把 Clean Code 對程式碼、設計、架構與軟體工藝的品質判斷,延伸成 User 操作 AI Agent 時的協作責任。
最早的模糊清理實驗,只給 Agent 一句「改善逾期處理,讓它符合 Clean Code」。Agent 調整名稱、縮短主要流程,修改也集中在逾期處理附近;既有驗證沒有發現行為漂移。
但清理目標、必須保留的行為與停止位置,全由 Agent 根據 Repository 線索自行推論。這次猜得合理,仍不能成為可重複的團隊流程。換一次 Run、少一項測試,或換到另一個 Repository,答案都可能不同。
同樣問題後來出現在 Model Role、架構邊界與多 Agent 分工。沒有第二個 Domain 使用情境時,建立第二套 Model 只會提前支付 Mapping 成本;跨團隊發布壓力尚未出現時,通知 Provider 也不必急著拆成獨立 Project;開始平行開發後,Context 更包含團隊如何切責任與整合成果。
C 要求 User 先掌握並提供真實情境。載入更多檔案只能增加材料,重要判斷仍要在專案裡找到依據。找不到就標成未知並查證;若不同答案會改變行為,任務應先停下來。
「小」在 Clean Code 裡可以是函式、類別、元件與週期。到了 Agent 工作流程,我更在意的是一次累積多少尚未驗證的改動。
前面的實驗留下三種情境。低風險、可整批放棄的修改,可以一次完成;函式拆得太細時,跳轉、結果型別與彙整成本可能增加;涉及狀態、資料或外部副作用時,小週期則能讓每個決策獨立驗證與撤回。
我用 L 檢查單一變更理由,以及尚未驗證的副作用會擴到哪裡。檔案數、方法長度與 Commit 數都只是線索。架構調整即使跨越多個 Project,只要所有修改服務同一個邊界決策,而且能分段驗證,仍可能符合 L。
E 檢查名稱、型別與契約能不能直接說明各自負責什麼。Day 5 顯示格式完全正確的名稱仍可能誤導;把 Naming Policy 寫成可重複判斷後,Agent 才能在不逐一指定每個識別字的情況下,依領域詞彙、作用域與格式慣例自主命名。
這個問題不只出現在命名。Day 16 的兩個 Provider 都能編譯,失敗、取消與重試行為卻未必相容,表示介面名稱和型別仍不足以定義行為契約。到了 Day 24,Use Case 即使搬進另一個 Namespace,只要仍直接依賴 DbContext,依賴方向就沒有改變。
名稱、型別、契約與架構位置最後都回到同一項要求:User 要把資料角色、行為契約、依賴方向、跨界資料、錯誤語意與副作用順序說清楚,讓 Agent 不必靠猜測補上意圖與邊界。細部實作仍可交給 Agent 自主決定。
從測試紀律、TDD 與 TCR,到固定 Commit、Evidence Packet 和估算來源,檢查的都是同一件事:Agent 宣告完成時,User 手上留下哪些可查資料?
只留下「所有測試全數通過」仍然不夠。Reviewer 還需要知道驗證的是哪個 Commit、執行哪些測試、原始 Prompt 是什麼、過程失敗過什麼、哪些風險沒有涵蓋,以及最後由誰接受結果。
固定 Commit 與 Evidence Packet 讓程式碼交付可以重跑;昨天的估算也是同一個問題,156 小時 只有在假設、Scope、依賴與更新條件都留下來時,才具有討論價值。
A 會依風險調整證據重量。低風險改名保留需求、Diff 與相關測試即可;涉及資料、通知或並行時,才需要較完整的 Evidence Packet。重要主張至少要能由另一個流程重建,不能只剩 Agent 整理過的成功摘要。
整潔的測試名稱寫著「剛好二十四小時」,資料經 SQLite 寫入再讀回後卻已越過等號;兩個執行流程也可能在資料庫發現衝突以前,各自送出一次通知。這兩次實驗都曾出現綠燈,外部答案仍不符合真正需求。
N 因此要求 User 先固定可觀察行為,再檢查通知次數、持久化資料、順序、取消與失敗路徑。測試是主要工具,Oracle 是否完整仍需要人判斷。
命名主要靠近 E,但好名稱也幫助 C 讀懂領域、幫助 L 找到修改位置。測試常落在 A 與 N,也可能提供 C 所需的既有行為。來源關係是多對多,無法把每個字母固定交給單一章節。
這個系列只有一支 Work Item API、固定模型條件與特定任務。它能解釋我為什麼形成這五項責任,還不足以涵蓋安全、隱私、成本、授權與所有架構問題。
CLEAN 約束的是使用 AI Agent 的 User。Policy、AGENTS.md、Skill、測試與工具可以重複執行部分規則;選擇 Context、接受風險與最後簽名,仍然是人的責任。
清楚名稱與結構可能降低錯誤搜尋及理解成本,也可能增加名稱長度、抽象層與工具呼叫。本系列沒有跨任務、跨 Repository 的統計,無法把這項可能性寫成「Clean Code 一定節省 Token」。
前面每篇文章只挑一到兩項主要 CLEAN,是為了讓當天焦點清楚;實際任務仍可能同時用到其他原則。
例如處理重複通知時,我會先用 C 查清楚現有重送契約,再以 E 定義冪等鍵、Transaction 與副作用邊界。N 固定「同一操作不得產生第二次外部效果」,L 把修正拆成能獨立撤回的小批次;A 則保存並行時間線、測試、Diff 與人工接受理由。
五項原則的使用順序與證據重量會跟著風險改變。低風險的區域變數改名,可能只需要 E、L 與一項相關測試;資料、外部副作用或並行則會把其他原則一起帶進來。
所以 CLEAN 沒有固定操作順序。User 要根據任務風險,決定先動用哪幾項,又要留下多少證據。
寫到 Day 30,我願意先替這三十天主線給出正式答案:CLEAN 不是從書中直接摘出的五條規則,而是我把 Clean Code 的品質判準放進一連串 AI Coding 實驗後,整理出的 User 協作責任。
Clean Code 告訴我,最後的 Code、Design 與 Architecture 應該接受哪些品質檢查;CLEAN 則提醒我,在 Agent 動手以前、修改途中與宣布完成時,User 還有哪些責任不能省略。
這套框架記錄的是目前這批實驗支持到的工程判斷,之後遇到反例仍然應該修正。它不替 User 做決定,也不能讓測試、Policy 或 Skill 自動取得接受風險的權力。
Day 30 到這裡,三十天正式主線已經完成。接下來 Day 31~32 會延伸處理一個更實務的問題:前面累積的 Policy,哪些可以跨 Repository 重用,又如何真正做成 Skill。最後 Day 33 再回到我自己,整理這三十三篇到底改變了哪些工程習慣。


 iThome鐵人賽
 看影片追技術