
到目前為止,我們討論的RAG技術都基於一個前提:之是以非結構化或半結構化的文件形式存在。然而在許多專業領域,知識更多以隱性、分散的形式蘊藏在海量結構化案例數據中。
例如在司法領域,決定判決結果的"知識"並非僅寫在法條裡,更多體現在成千上萬判例中法官如何衡量犯罪動機、傷害程度、自首情節、社會影響等各種複雜甚至相互衝突因素的經驗中。這就像資深醫師的"直覺"--背後是無數病例的經驗累積而非僅僅教科書理論。
從這類數據集中學習,需要全新的RAG範示。不能滿足於簡單的文本搜索,必須深入數據內部,通過統計分析和模式識別將隱藏在數據中的隱性知識挖掘出來,轉化為Agent可以理解和運用的結構化決策邏輯。這即是從"訊息檢索"到"知識發現"的飛躍。
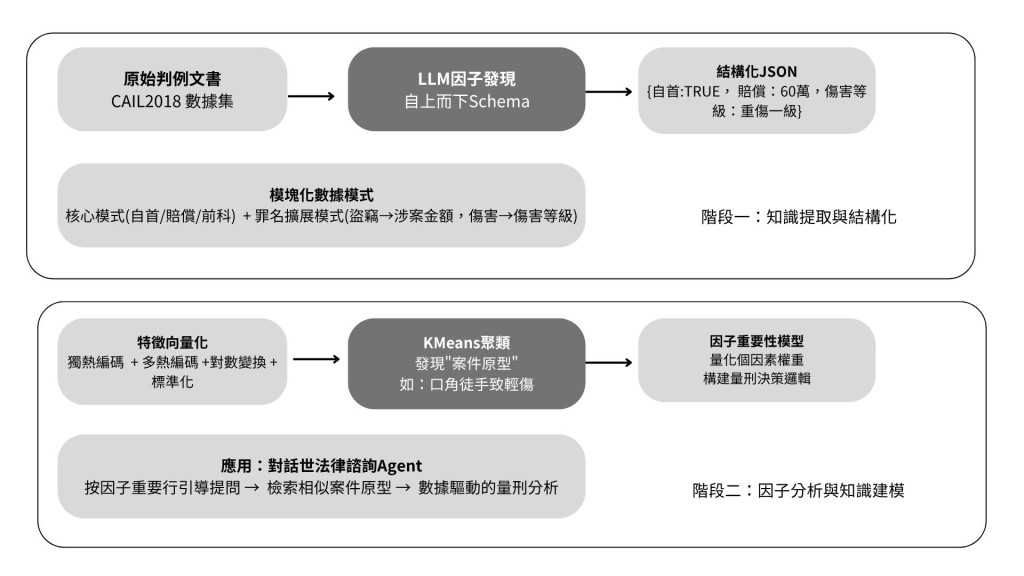
過程分兩階段:
利用LLM理解和歸納能力,將每個案例的非結構化描述(如案情陳述)轉換為包含所有關鍵判決因素的標準化JSON對象,挑戰點在於定義一個全面且一致的數據模式(schema)。
在獲得大規模結構化數據後,運用數據分析技術發現模式、提煉規律、識別出哪些因素對最終結果具有最顯著影響並量化其權重,構建"判決因子重要行層次模式"--這就是從海量案例中提煉出的可供Agent使用的"判決經驗"
一張臉的模樣、一個人的嗓音等很難用文字描述,我們講的文本記憶機制是無法存儲的。如何跨越上下文的邊界,存儲此多模態記憶,仍處於學術界的前沿。
思路一:存儲原始多模態數據和文本描述。例如:Agent看到一張沒有見過的人臉後,可以調用工具,剪切出圖片中人臉的部分,然後以圖片格式把人臉保存下來,再用文本加以描述和索引,例如在Markdown中引用這張圖片。在減索時,如果Agent看到一張人臉並需要辨認是誰,可以先通過文本描述檢索到的相關圖片,在讀取原始圖片,判斷是否為同一人。
思路二:把多模態訊息的嵌入壓縮存儲到上下文中。思路依雖然用文本描述多模態訊息,卻無法徹底解決有些多模態訊息難以用文本表達的問題。思路二是當Agent看到一張沒有見過的人臉後,可以調用工具,剪切出圖片中人臉的部分,然後計算其嵌入,並將遷入保存在上下文中。上下文中維護一個區域,保存著多個多模態訊息(ex.多張人臉、多人聲紋)各自的嵌入。這樣在檢索時,Agent可以始終在上下文中看到所有多模態訊息。相比存儲文本描述,存儲嵌入的方法對每張人臉、每個人的聲紋一般只需存儲一個嵌入,在上下文中只占用1個token,效率很高,一段1000 token的上下文區域,就足以容納1000張人臉。
思路三:把多模態訊息的嵌入壓縮存儲到模型參數中。一個自然的念頭,是乾脆把需要存儲的多模態訊息寫進模型權重,比如為每個用戶訓練一個專屬LoRA。但這樣訓練出的fact-LoRA,直接提問時幾乎能完美複述,可一旦需要在這些事實之上最間接推理便告失靈,因為凍結的骨幹模型從未學過如何去"查閱"這樣一個臨時掛載上來的適配器。換句話說,把事實存進去是一回事,讓模型知道何時該取用它,則是另一回事。 User as Engram針對的正式一點:它並不訓練LoRA,而是把多模態訊息的嵌入精確的寫入Engram模型中一個空閒的哈希 N-gram槽位。這類模型在預訊練接隊便已學會通過哈希查表來調取記憶,並由一個能感知上下文的門控機制決定何時調取; 於是新寫入的事實會自然而然地在該被想起的時候被想起。相比思路二,這種存儲到Engram的方法擴展性更強,但需要預訓練模型本身支持Engram,並且查準率可能不如思路二。
獨熱編碼(One-Hot Encoding)是一種把類別資料轉換成數值資料的方法,常用於機器學習與深度學習。
獨熱編碼就是把每個類別變成一個只有一個位置為 1、其餘全為 0 的向量,避免模型誤以為類別之間存在大小或順序關係。
https://www.aiposthub.com/cloudflare-containers-agent-sandbox-snapshots/
Cloudflare 加速 AI 代理沙盒:啟動、快照與恢復,決定任務能否接著做
好了 這一系列大概走到最後了,後面也是拖一些時間才生出一篇文章,目前我們完成的部分可以視為AI Agent概論與用戶記憶與知識庫的部分,在後面的這一章節,從觀看數就知道大家不是很感興趣,有些艱深,且又有些過時,但這對於要做研究的地方還是有進步的空間。對於沒有那麼鑽研的群眾,較深度的內容就有點多了。
或許會開新系列的文章,畢竟這樣可以保持飢渴,獲取新知識,同時我也是想在文章下面附上AI時事新聞或是GitHub上又有什麼好玩的repo。謝謝大家的參與。
有緣再會


 iThome鐵人賽
 看影片追技術