
前幾篇文章與RAG的部分都是建立在知識庫的基礎上,在寫後面的文章,我發覺需要先把基礎知識庫的概念說完,才能繼續下去。
另外我們在"知識的組織與檢索"講到第3種方式,還有另外3種模式,等我們講解完基礎部分之後再繼續。
人類記憶系統的啟發
在建構AI Agent的記憶系統之前,讓我們先從認知科學的角度理解人類是如何處理與存儲訊息的。
人類記憶是一個多層級的認知系統,它不僅能存儲訊息,還能根據重要性、時間和上下文對訊息進行分類和整理。認知心理學為理解記憶的結構和過程提供了經典的理論框架,如下圖: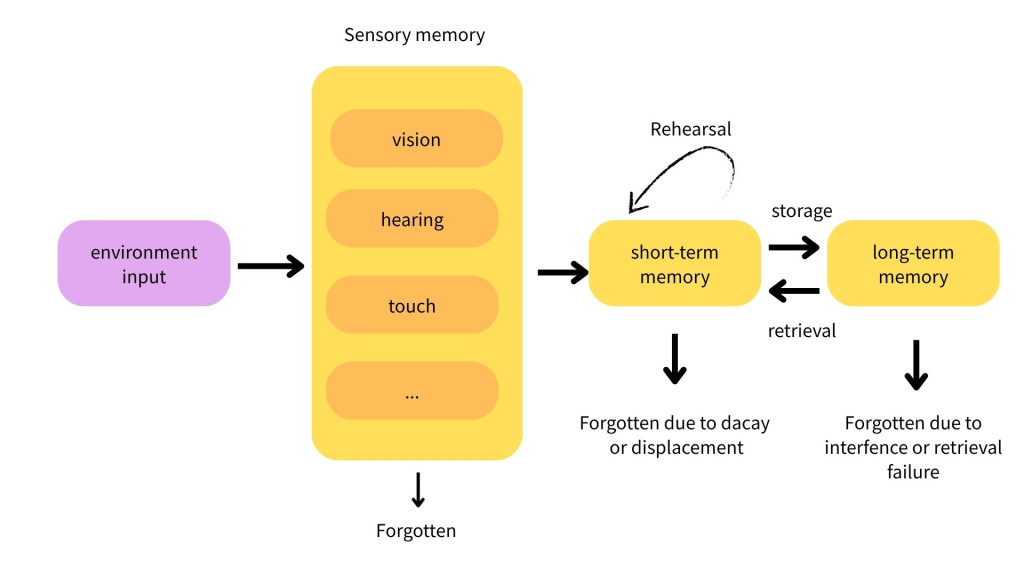
根據認知心理學的研究,人類記憶可以分為以下層次:
1.感覺記憶(sensory memory):持續時間極短(0.5~3s),容量巨大,負責暫時保存感官接收到的所有訊息。
2.工作記憶(working memory):持續時間短(15~30s),容量有限(7+-2個項目),負責當前任務的訊息處理。
3.長期記憶(long-term memory):可持續時間長(可達終生),容量幾乎無限,進一步分為:
為何AI Agent需要記憶與RAG?
借鑒人類記憶系統的設計,我們可以理解為為甚麼AI Agent也需要類似的記憶能力。人類智能的一個重要特徵就是能夠記住過去的經歷,從中學習,並將這些經驗應用到新的情景中。同樣,一個真正智能的AI Agent也需要具備記憶能力。對於基於LLM的AI Agent而言,通常面臨兩個根本性的侷限:對話狀態的遺忘和內置知識的侷限。
(1)侷限1:無狀態導致的對話遺失
當前的LLM雖然強大,但設計上是無狀態的。這意味著,每一次用戶請求(或API調用)都是一次獨立的、無關聯的計算。模型本身不會自動"記住"上一次對話的內容(目前來說通常會有上下1次對話的額度)。這帶來了一些問題。
(2)侷限2:模型內置記憶的侷限性
除了遺忘對話歷史,LLM的另一個核心侷限在於其知識是"靜態的、有限的"。這些知識完全來自於它的訓練數據,並因此帶來一系列的問題:
為了克服這一侷限,RAG技術由此而生。它的核心思想是在模型生成回答之前,先從一個外部知識庫(Ex.文件、數據庫、API)中檢索出最相關的訊息,並將這些訊息作為上下文一同提供給模型。
larashero3-dotcom/lieflat-less-ai-tone 是一個針對中文寫作的 AI 味去除 Agent Skill。它不是文字分類模型,也不是一般的 NLP 套件,而是一份可直接交給 Claude/其他 Agent 使用的 SKILL.md 規則集,根據 629 篇文章、約 283 萬漢字的 AI/人類對照研究,定位並最小幅度改寫被認定為 AI 風格的句式。
它的使用者主要是中文內容作者、編輯、研究者,以及想把 AI 產生文章改得更自然、但又不希望模型任意潤色或改變原意的人。
GitHub: https://github.com/larashero3-dotcom/lieflat-less-ai-tone


 iThome鐵人賽
 看影片追技術