
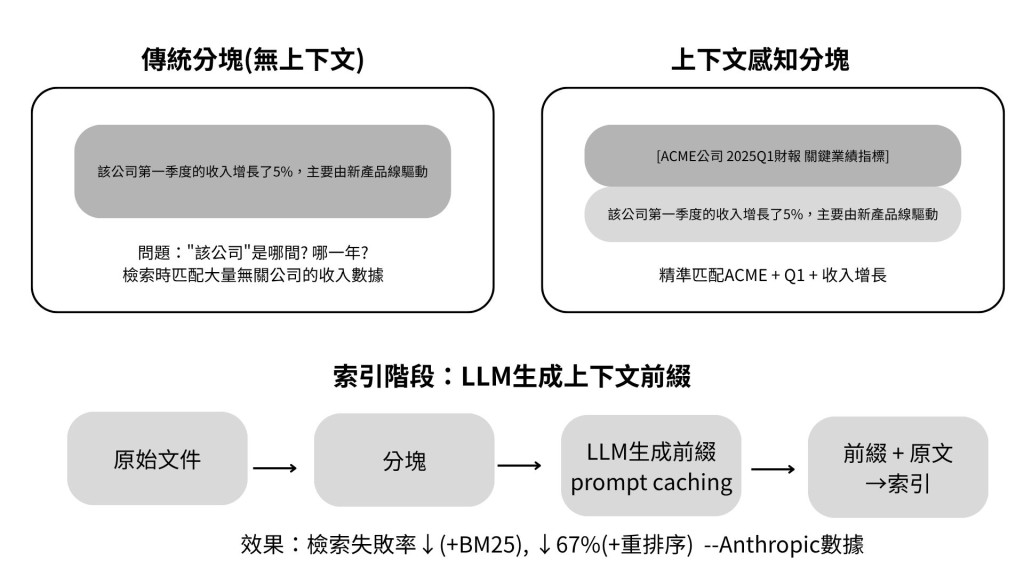
即使擁有了先進的智能體化RAG框架,傳統文件分塊方法本身存在根本性缺陷,仍然是限制RAG系統性能的瓶頸。
這正是"文件分塊"-這篇埋下的伏筆:標準分塊方法無論是固定大小切分還是遞歸切分,都不可避免地將緊密關聯的上下文分離。一個孤立的文本塊如"該公司第二季度的收入增長了3%",脫離原始上下文後變得模稜兩可 --無法回答代詞指代("該公司"是哪家公司?)、時間參照(報告發布於何時?)或實體相關(與哪個產品線相關?)等關鍵問題。這種上下文丟失在訊息嵌入階段就造成了語意訊息的嚴重損失,直接導致後續檢索準確率下降。
為了解決這個問題,Anthropic提出了"上下文感知檢索(contextual retrieval)"。核心思想非常直觀:在對文本塊進行向量化檢索前,先利用LLM為其生成一段簡短的、包含核心上下文的"前綴摘要",然後將前綴與原始文本塊拼接後再索引。例如系統可能生成前綴:"本段內容選自ACME公司2025年Q2財務報告的"關鍵業績指標"章節"。通過這種方式,原本模糊不清的文本塊被重新"錨定"再了其原始的語意環境。
同時要與"上下文感知壓縮"劃清界線。兩者名字相近但作用的時機與對象完全不同:我們目前講的上下文感知檢索發生在"索引期",針對的是知識庫裡的文本塊,做的是"補前綴、加背景"以提升可檢索性; 上下文感知壓縮發生在運行期,針對的是當前會話的"對話歷史",做的是"按當前任務裁減、丟棄無關內容"以節省窗口。一個作加法(補上下文),一個做減法(去冗餘)。
這種方法的精妙之處在於同時增強了稀疏檢索與稠密檢索兩種模式。對於BM25這樣的稀疏檢索,上下文前綴增加了豐富的、可精準匹配的關鍵詞("ACME"、"2025第二季度")。對於向量嵌入這樣的稠密檢索,前綴注入了關鍵語意背景,使生成的向量表示能更精確地反映文本塊的真實含意。
複習一下
稀疏檢索(Sparse Retrieval):基於關鍵字匹配(TF-IDF、BM25),速度快、可解釋性高,但不理解語意。
稠密檢索(Dense Retrieval):利用 Embedding 向量搜尋,可理解語意與同義詞,適合 RAG 與知識庫問答。
現代 RAG 最佳實踐:通常採用 混合檢索 Hybrid Retrieval(BM25 + Dense + Reranker),兼顧關鍵字精確度與語意召回能力。
OpenAI 於 2026 年 9 月 29 日 的年度開發者大會(DevDay)上正式推出了 GPT-6.1 Sol。
這款模型被定位為「高性價比」的中階模型,其 API 成本僅為旗艦版 GPT-6 Astra 的五分之一,並特別針對 Agentic Coding(智能體程式設計)、電腦操作以及專業開發工作進行了最佳化。
https://www.aiposthub.com/gpt-6-1-sol-price-benchmark-guide/


 iThome鐵人賽
 看影片追技術