
DAY 16 已經讓 PM、Research、Creative 和 Finance 依序執行,但當時的做法很直接:後面的 Agent 會收到前面所有人的完整輸出。
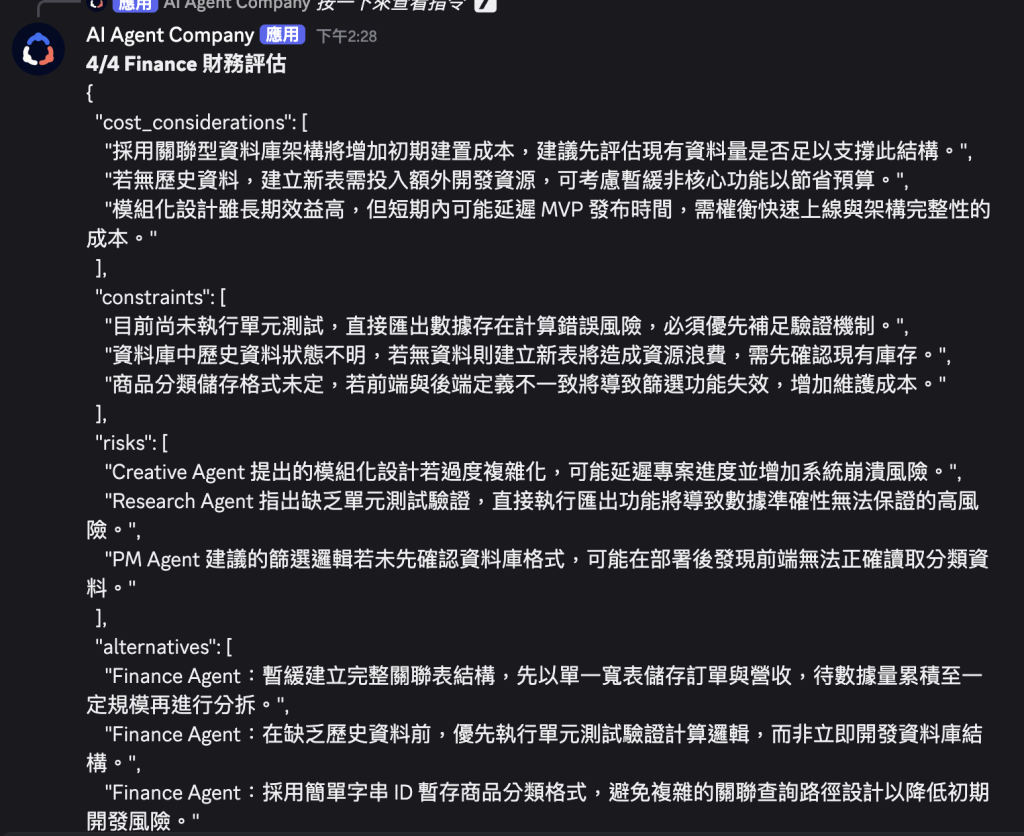
第一輪只有四個角色時還能運作,之後加入第二輪、需求變更與 Review,Prompt 一定會愈來愈長。而且「收到全部資料」不代表「知道該看哪裡」。例如 Finance 需要的是限制、待查證成本與 Creative 的方案,不需要讀完所有欄位。
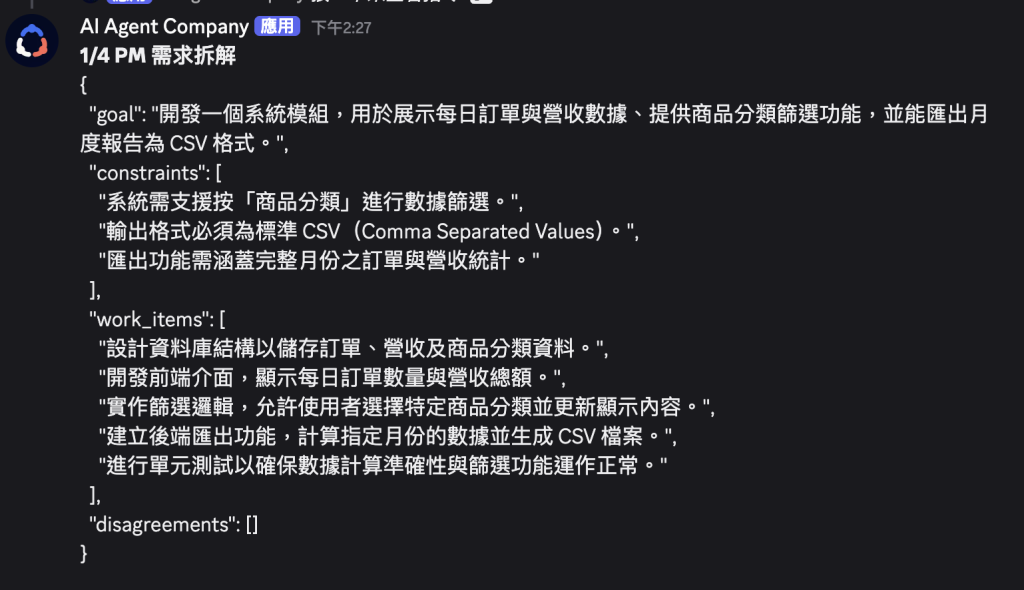
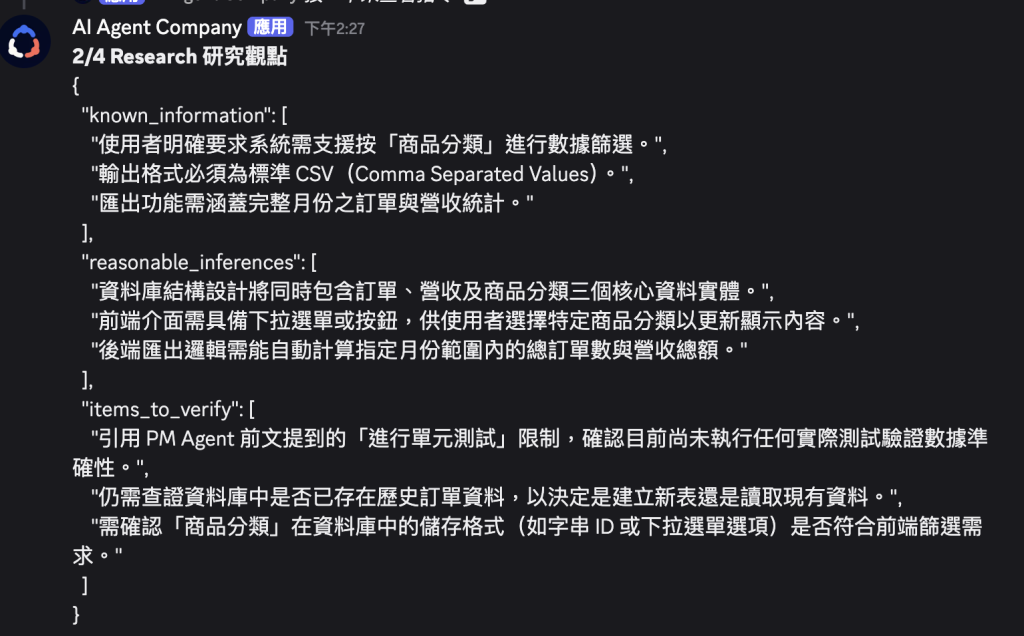
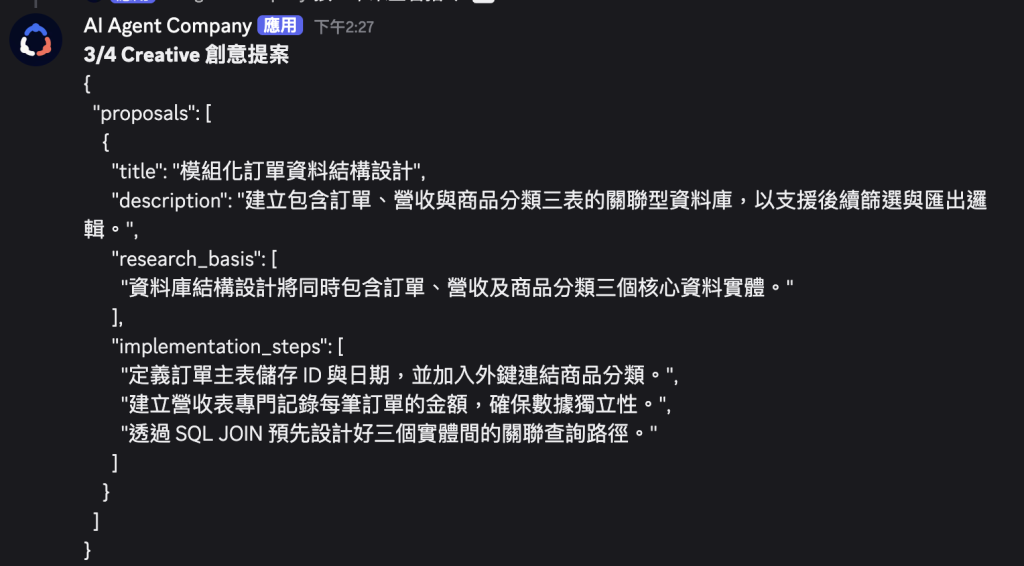
今天建立 meeting_context,改由 Meeting Manager 挑選下一位 Agent 真正需要的內容,同時保存摘要與建議來源。
MeetingContext
這篇仍以 Python 端的資料傳遞與自動化測試為主,測試中的 Agent 輸出是固定的 Fake Response,不代表 Qwen 每次都會產生相同內容。
DAY 16 的流程大致如下:
PM       → 原始需求
Research → 原始需求 + PM 完整結果
Creative → 原始需求 + PM、Research 完整結果
Finance  → 原始需求 + PM、Research、Creative 完整結果
這種做法方便先驗證執行順序,但每多一位 Agent,輸入就會繼續累積。DAY 17 改成由 Python 控制資料範圍:模型負責分析,Meeting Manager 決定它能看到哪些前文。
MeetingContext 保存什麼?共享內容放在 models/meeting.py:
@dataclass
class MeetingContext:
    agent_summaries: dict[str, str] = field(default_factory=dict)
    suggestions: list[AgentSuggestion] = field(default_factory=list)
    round_summaries: list[MeetingRoundSummary] = field(default_factory=list)
三個欄位的用途分別是:
| 欄位 | 用途 |
|---|---|
agent_summaries |
保存每位 Agent 的精簡結論 |
suggestions |
保存建議、類別與提出者 |
round_summaries |
保存一輪討論結束後的摘要 |
MeetingRecord 會持有這份內容,再和會議狀態、每一步輸入輸出一起交給 Repository 保存。程式重新啟動後,也能從 JSON 還原。
我在 MeetingManager 中建立固定規則:
RELEVANT_OUTPUT_FIELDS = {
    "Research Agent": {
        "PM Agent": ("goal", "constraints", "work_items", "disagreements"),
    },
    "Creative Agent": {
        "Research Agent": (
            "known_information",
            "reasonable_inferences",
            "items_to_verify",
        ),
    },
    "Finance Agent": {
        "PM Agent": ("constraints",),
        "Research Agent": ("known_information", "items_to_verify"),
        "Creative Agent": ("proposals",),
    },
}
Research 讀 PM 整理的需求;Creative 接收 Research 的分析;Finance 則取得專案限制、待查證內容與方案。職責目前固定,直接用 Python 字典比較容易檢查,日後角色與欄位增加時再考慮改成設定檔。
_build_input() 會依規則找出已完成的步驟,只取指定欄位:
previous_outputs[source_name] = {
    field: source_step.output_data[field]
    for field in fields
    if field in source_step.output_data
}
最後仍以 JSON 傳給 Agent,但不再把所有結果照單全收。原始需求則會保留,確保每位 Agent 都知道目前處理的是哪個專案。
如果只留下「先製作基本圖表」,之後很難知道是誰提出的。因此每筆 AgentSuggestion 會保存:
@dataclass(frozen=True)
class AgentSuggestion:
    agent_name: str
    category: str
    content: str
agent_name 記錄提出者,category 是原本的輸出欄位,content 才是實際內容。完整輸出仍放在 MeetingStepRecord.output_data,共享內容另外保存精簡摘要,兩者用途不同:完整資料方便回查,摘要適合提供給後續 Agent。
單一 Agent 的摘要上限是 800 字元,第一輪完成後,再把四位 Agent 的摘要合併成 MeetingRoundSummary。DAY 17 只有第一輪,因此 round_number 先記為 1。
Meeting Manager 目前設定:
max_prompt_characters = 6000
max_response_characters = 4000
Prompt 在送出前先檢查,Agent 回覆轉成 JSON 後也會檢查。超過限制就停止後續步驟並保存失敗狀態。
字元數不等於 Token 數,這裡只是先加一道容易理解的保護,避免共享內容無限制增長。實際 Token 用量仍以 Ollama 回傳的統計資料為準。
DAY 15 已經支援從失敗的 Agent 繼續執行。加入 meeting_context 後,舊紀錄可能已有成功輸出,卻缺少摘要或建議。
因此 _run() 開始時會重新讀取所有已完成步驟:
self._refresh_context_from_completed_steps(record)
重建前會先移除同一位 Agent 的舊建議,避免 Resume 後重複加入。這樣沿用先前成果時,共享內容仍能和步驟紀錄保持一致。


 iThome鐵人賽
 看影片追技術