
今天來換一種,讓它跑起來然後立刻死
弄壞的方式是給 Container 一個會馬上結束的指令。改 deployment.yaml,在 container 底下加
command: ["sh", "-c", "echo starting; sleep 2; echo something went wrong; exit 1"]
kubectl apply -f manifests/base
kubectl get pods -n ithome-lab # kubectl get pods -n ithome-lab -w
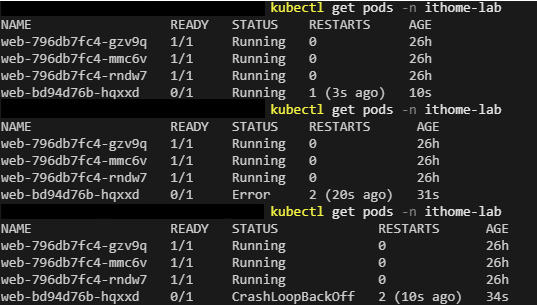
重啟的間隔會越拉越長,10 秒、20 秒、40 秒這樣翻倍,最多到五分鐘。所以如果你在等它自己好,會越等越久
先看 log
kubectl logs <POD_NAME> -n ithome-lab

kubectl logs 不加 --previous 時,會優先讀取目前執行中容器的日誌;容器終止也能讀取其日誌。在 CrashLoopBackOff 的退避等待期間,若狀態保留了上一次終止容器的資訊,也可能讀到那一次的日誌
如果要指定同一個 Pod、同名容器上一次已終止的執行個體,可以加上 --previous:
kubectl logs <POD_NAME> -n ithome-lab --previous

為什麼兩個指令的輸出會一樣?有兩種可能:
單看這兩行無法判定是哪一種,可以在兩個指令後都加上 --timestamps 比較日誌時間,再搭配 kubectl describe pod 的 State、Last State、Restart Count 與起訖時間判讀;兩次查詢之間也可能剛好發生重啟
--previous 是指定日誌來源,若沒有上一次終止容器的紀錄,會回報找不到 previous terminated container;它也不是查詢所有歷次重啟的日誌,日誌不一定寫出完整死因,仍要搭配容器狀態和 Events 排查
kubectl describe pod <POD_NAME> -n ithome-lab
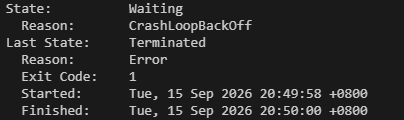
我這次是 exit 1,所以 Exit Code 會是 1
修復就是把那行 command 拿掉再 apply
kubectl apply -f manifests/base
kubectl rollout status deployment/web -n ithome-lab
kubectl get pods -n ithome-lab
明天見 :D


 iThome鐵人賽
 看影片追技術