
你的程式如果有繁體中文介面,而翻譯是 AI 幫你做的,你一句一句看過嗎?
usage 是我做的開源小工具,顯示 Claude Code、Codex 等 AI 工具用了多少 token、花了多少錢。這是它 8 月 5 日修正前的那一版,語言設成繁體中文,在終端機跑出來的開頭:
检测到: Claude Code ✓, Codex ✓, Antigravity ✓
狀態列尚未設定。請執行:usage setup

╭──────────────────────────────────────────────────────────────────────────────────╮
│ Token Tracker  最近 20 / 1887 个会话  Token: 22.0M  等效成本: $9.91              │
╰──────────────────────────────────────────────────────────────────────────────────╯

  时间          来源    项目             总Token   等效成本   消息
「狀態列尚未設定」那一行是繁體。其他幾個詞,「检测到」「个会话」「时间」「来源」「项目」「总Token」「消息」,用的是簡體字或對岸的用詞。
這些字從 5 月 24 日起,一路跟著發了 138 個版本,到 8 月 5 日才修掉,一共改了 52 句。
usage 的介面文字放在一個翻譯檔裡,英文、日文、韓文、簡體中文、繁體中文各有一組。
5 月 24 日,一次改動把終端機畫面的文字搬進這個翻譯檔。這批文字原本的中文只有一份,是簡體。後來修掉的 52 句裡,有 48 句在這一天進來,這 48 句的繁體中文,跟簡體中文一字不差。
usage 有一個翻譯測試(Day 16 講過),只比對五種語言的條目齊不齊。這 48 句條目都在,內容也不是空的,它抓不到。
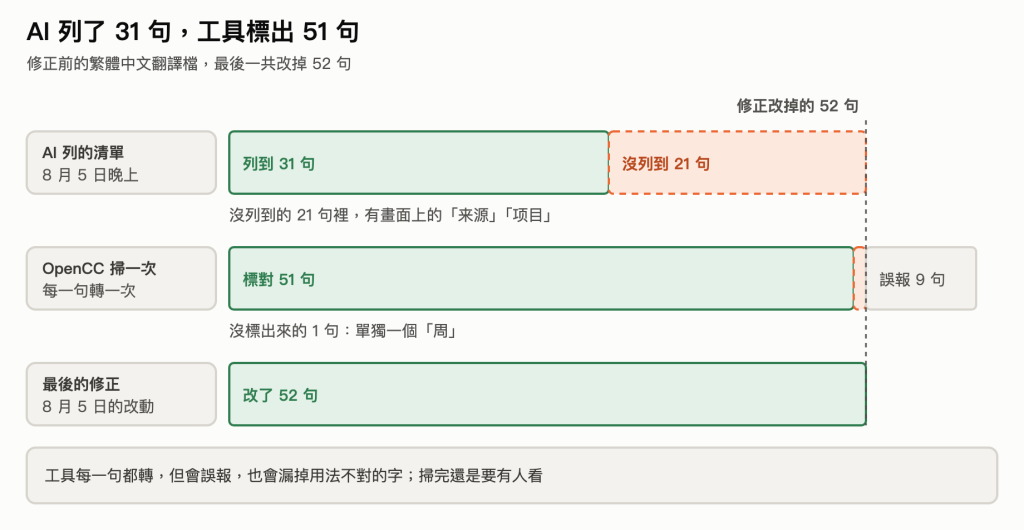
8 月 5 日晚上,AI 在我的 Mac 上跑出同一個畫面,貼給我看,指出上面的簡體,並列出翻譯檔裡 31 句要改的。它的判斷是:
這是一次性的事故……改完就不會再犯。
接著它寫了一份修完之後的畫面示意,裡面「来源」「项目」都變成了「來源」「專案」。
我把它列的 31 句跟畫面對了一次:「来源」「项目」這兩個欄位名稱,不在 31 句裡面。只照那份清單改,畫面上這兩個詞會原封不動。
這次修正發版時,版本更新說明(CHANGELOG)是這樣交代的:一開始靠一份手寫的簡體字清單去找,只找到一部分,漏了「来」和「项」。那份清單沒有留在專案裡。
OpenCC 是一個開源的簡繁轉換工具。它有一種轉法叫 s2twp:簡體轉成台灣繁體,連用詞一起換,例如「数据」換成「資料」、「项目」換成「專案」。
檢查的方法很簡單:把每一句繁體中文丟進去轉一次。轉完變了,這句就可能混了簡體字或對岸的用詞;轉完跟原本一樣,只代表工具沒看出問題。
我拿修正前那一版的翻譯檔跑了一次,繁體中文 489 句,標出 60 句:
還有一句工具沒標出來:表格欄位上單獨一個「周」(本週的週)。修正時也一起改成「週」,所以最後總共改了 52 句。
8 月 5 日那次修正,commit 訊息寫的做法也是這樣:用 OpenCC 掃出全部候選,逐條人工核對,排除 9 個誤報。
AI 列的 31 句,工具全都標到了,還多標出 20 句。可是工具會誤報,也抓不到「周」這種字本身沒錯、只是用法不對的。所以掃完,還是要有人一句一句看。
這次修正只改了兩個地方:翻譯檔,和一份報表畫面的快照(測試拿來比對畫面的標準答案)。沒有加任何測試。
修正前後,usage 的測試裡都沒有一個專門檢查繁體中文有沒有混進簡體。
「改完就不會再犯」是一個判斷,不是一個檢查。下次新加的句子又照抄簡體中文,沒有一個測試會專門把它抓出來。
這個檢查,寫起來不到二十行。先裝 OpenCC 的 Python 套件:
pip install opencc
存一個 check_zh_tw.py:
import json
import sys

import opencc

cc = opencc.OpenCC("s2twp")
with open(sys.argv[1], encoding="utf-8") as f:
    data = json.load(f)

for key, text in data["zh-TW"].items():
    fixed = cc.convert(text)
    if fixed != text:
        print(f"{key}:{text} → {fixed}")
把你的翻譯檔路徑接在後面跑:
python check_zh_tw.py i18n.json
你的翻譯檔格式如果不一樣,改 data["zh-TW"] 那一行,讓它拿到「條目名稱 → 繁體中文句子」就好。
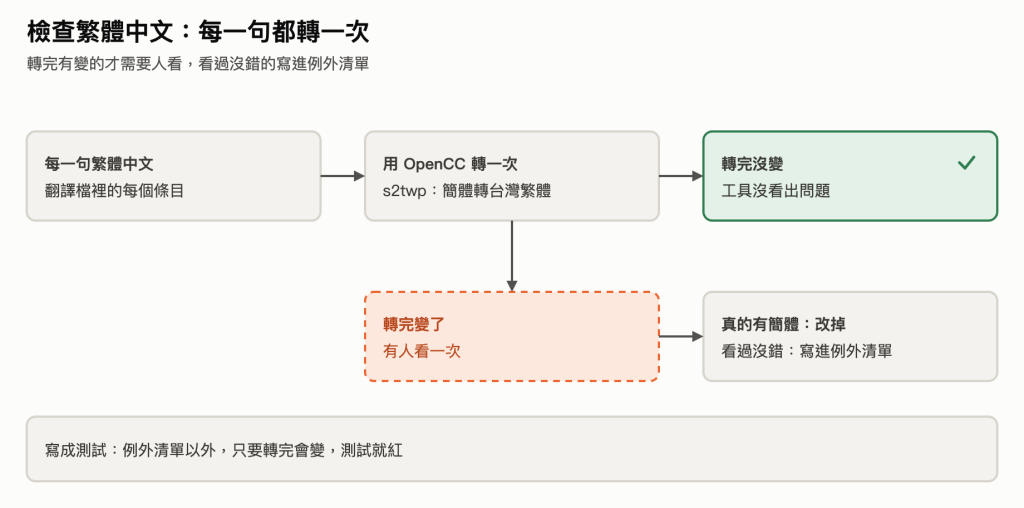
印出來的每一句都看一次:真的有簡體的改掉;確定沒錯的,連同原文一起記下來。然後寫成測試,存成 test_zh_tw.py,確定沒錯的放進例外清單:
import json

import opencc

# 工具標出來、但看過確定沒錯的句子:條目名稱 → 當時看過的原文
ALLOWED = {
    "awaiting_rate_limits": "請對 Claude Code 發送一句訊息以同步配額",
}


def test_zh_tw_has_no_simplified():
    cc = opencc.OpenCC("s2twp")
    with open("i18n.json", encoding="utf-8") as f:
        data = json.load(f)
    bad = [
        key
        for key, text in data["zh-TW"].items()
        if ALLOWED.get(key) != text and cc.convert(text) != text
    ]
    assert not bad, bad
例外清單記的是原文。哪天有人改了這一句,原文對不上,它就會重新被檢查。
用 pytest(Python 的測試工具)跑:
pip install pytest
pytest test_zh_tw.py
我拿 usage 修正前、修正後兩版翻譯檔各跑一次(例外清單放滿那 9 句):修正前紅(測試失敗),修正後綠(通過)。把例外清單裡的一句改成簡體,又會紅。
pip install opencc 裝不起來的話,可以改裝純 Python 寫的 opencc-python-reimplemented,程式不用改。兩個我都跑過,標出來的 60 句一模一樣。
工作單(交給 AI 的任務說明)裡有一格「做完怎麼算對」,Day 4、Day 8 到 Day 17 各在這格加了幾行。今天再加一行:
做完怎麼算對:
- (Day 4、Day 8 到 Day 17 加的幾行)
- 有繁體中文介面的專案:繁中文字用 OpenCC(s2twp)掃過,標出來的每一句不是改掉,就是連同原文寫進例外清單;這個掃描寫成測試
今天的簡體字,是沒有任何測試在看的地方。明天看一個測試有在看、看到的卻是空白的地方:9 月 5 日,usage 的報表加了一塊「Token 組成」,快照測試(把整份報表存成標準答案,每次拿來比對)跟著更新,AI 回報 1935 個測試全過。存進標準答案的那一塊,長條是空的,一個百分比都沒有。


 iThome鐵人賽
 看影片追技術