
原話 (jason3e7):
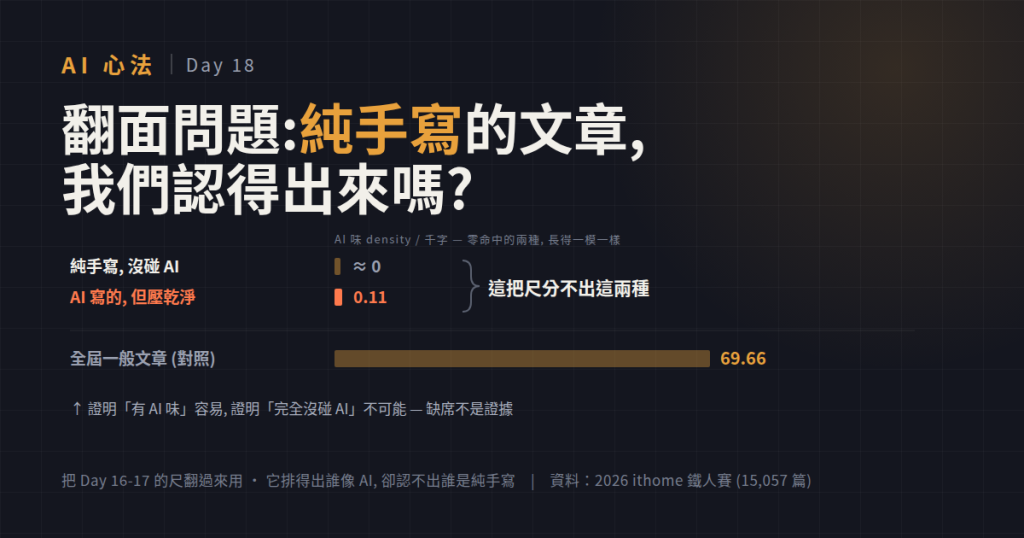
做了這個研究之後, 我反而好奇有那些文章是純手寫, 完全沒有用 AI 的, 是不是也有辦法辨識呢?
這是個翻面問題. Day 16 到 Day 17, 我都在用這組實驗的訊號抓「像 AI 的」. 這 15 天裡我把這套工具一路疊上去, 疊到了 9 個訊號. 既然尺做到這麼細了, 很自然會想: 反過來用, 能不能圈出「這篇是純人寫的」?
直覺上你會想: signal 全部零命中, 不就是人寫的嗎? 但這條反推不成立. 這篇就是在講它為什麼不成立 - 這不是尺還不夠細, 是這個問題本質上就偏心, 再怎麼調權重都補不起來.
先把這把尺現在長什麼樣交代清楚. Day 17 的綜合分數是 6 個 signal, 後來陸續補到 9 個, 公式沒變 - base = B 總和 × N 總和, 再除以字數乘一千得 density (每千字).
| signal | 抓什麼 | B (數量) | N (權重) |
|---|---|---|---|
em —— |
雙破折號 | 出現次數 | 4 |
| emoji | 表情符號 (扣掉 ○✗★☆☐) | 字元數 | min(種類, 5) |
| strict | 清單開頭的 粗體標籤: | 符合數 | 3 |
| all | 全部粗體 | 粗體數 | 0(只當放大器) |
| bq | 引用區塊 | 數量 | 1 |
| hr | 分隔線 | 數量 | 1.5 |
| 不是⋯而是 | 「不是⋯而是/更是」對立句 | 符合數 | 3 |
| 最容易⋯的 | 「最容易⋯的」教學警告腔 | 符合數 | 3 |
| 標題 | | 標題含全形 | |
有/無 | 2 |
重點: 這三個新訊號跟前兩天最大的不同: 它們第一次抓「中文語句」本身. Day 16 的破折號
——、Day 17 的 emoji/粗體/引用/分隔線, 抓的都是排版與符號習慣 - 跟寫哪種語言關係不大, 一篇英文文章照樣命中. 但「不是⋯而是」「最容易⋯的」是中文的句型與腔調, 標題|也是中文圈特有的排版. 講白一點: 前兩天量的是「markdown 味」, 這天才開始量「中文的 AI 味」. 這也是這套工具值得做到第三天的原因之一.
B_total = em + emoji + strict + all + bq + hr + 不是而是 + 最容易 + 標題|   ← 命中總次數
N_sum   = Σ (N where that signal fires)
        = (4 if em>0) + (min(types,5) if emoji>0) + (3 if strict>0)
          + (0 if all>0) + (1 if bq>0) + (1.5 if hr>0)
          + (3 if 不是而是>0) + (3 if 最容易>0) + (2 if 標題含|)
base    = B_total × N_sum
density = base / 總字數 × 1000                               ← 排名主指標
一般粗體 N=0 當放大器: all (全部粗體) 本身不給 vote (N=0), 但 count 進 B_total, 把全盤放大 N_sum 倍 - 排版重度的文章, 就算每個粗體權重 0, 也會把其他訊號的影響一起放大.
舉例, 全站 density 第一的「Day 02: 清點魔法物資」:
em=2, emoji=31(16 種), strict=8, all=39, bq=7, hr=10, 不是而是=2
B_total = 99
N_sum   = 4 + 5 + 3 + 0 + 1 + 1.5 + 3 = 17.5   (emoji 16 種, 封頂取 5)
base    = 99 × 17.5 = 1,732.5
density = 1,732.5 / 2,296 × 1000 ≈ 754.57 (全體 top 1)
| 項目 | 數值 |
|---|---|
| base 總和 | 2,761,130 |
| 全篇總字數 | 39,634,634 |
| 全體 density | 69.66 |
Day 16 單 —— 全體 0.86 → Day 17 六訊號 55.45 → 今天九訊號 69.66, scale 一路放大 (加了訊號、乘了 N_sum). scale 不是重點, 排名才是. 文末的瀏覽器工具用同一套算法, 掃到的 density 可以直接跟 69.66 比.
| # | density | B_total | N_sum | 文章 | 系列 |
|---|---|---|---|---|---|
| 1 | 754.57 | 99 | 17.5 | Day 02: 清點魔法物資 變數宣告與作用域 | JS 核心重構: 勇者轉職傳說 |
| 2 | 740.49 | 109 | 17.5 | Day 03: 極速短咒 箭頭函式 | JS 核心重構: 勇者轉職傳說 |
| 3 | 724.95 | 86 | 17.5 | Day 27: 戰略指揮資料驅動 (State-driven) | JS 核心重構: 勇者轉職傳說 |
| 4 | 705.13 | 88 | 17.5 | 我想像中的未來小豬 | 前端三分鐘 X Google AI 雙刀流 |
| 5 | 705.08 | 150 | 17.5 | Day 12: 你敢不敢承認你只優化了自己那一段? | Phoenix 2026 (DevOps RPG) |
| # | density | 篇數 | 系列 |
|---|---|---|---|
| 1 | 557.38 | 31 | JS 核心重構: 勇者轉職傳說 |
| 2 | 432.27 | 30 | Phoenix 2026 (DevOps RPG) |
| 3 | 424.47 | 29 | OpenShift AI 簡易入門 30 天 |
| 4 | 384.48 | 19 | RE: 從 4,343 筆職缺到 AI Engineer (MLOps × GenAI) |
| 5 | 370.94 | 30 | 使用gemini 準備 az-900 |
前 3 篇全部來自同一個系列「JS 核心重構: 勇者轉職傳說」(它也是 top 1 系列): 破折號、emoji、粗體標籤、「不是⋯而是」幾乎每個訊號都疊好疊滿, 第 4、5 名才換成別的系列. 這系列不管哪一版的尺都排在最前面 (它在 Day 17 的六訊號榜也是系列第一).
這把尺拿來排序 AI 味, 疊到九個訊號已經相當穩. 問題來了: 它能不能反過來認「人」?
不行. 關鍵在一句話: 零命中可能是「沒用 AI」, 也可能是「用了 AI, 但把痕跡壓乾淨了」. 這兩種在這把尺眼裡長得一模一樣, 分不開.
而且「壓乾淨」不是假設, 是 Day 16 就撞到的事實: ChatGPT & Codex 組的 —— 密度只有 0.11, 全組幾乎零命中 - 不是因為那組的人都手寫, 而是因為 GPT-5.1 (2025 年 11 月) 開始聽話, 你叫它別用破折號它就真的不用. 一個重度用 AI、但會下「不要破折號」指令的作者, 在這把尺上看起來就跟純手寫的人沒兩樣.
重點: 這是認識論上的不對稱: 證明「有」容易, 證明「沒有」難. 抓到一個 signal, 可以說「這裡有 AI 味」; 但 signal 全空, 只能說「我沒抓到」, 不能說「它不存在」. 缺席不是證據 (absence of evidence is not evidence of absence). 同樣的道理在浮水印上也成立 - 連官方浮水印都只能證明「這是我家模型生的」, 不能證明「這不是 AI 寫的」.
所以這套工具的能力是單向的: signal 高, 排名靠前, 有參考價值; signal 低, 什麼都推不出來. 它是一把「找 AI 味」的尺, 不是一把「認人」的尺. 把它倒過來用, 會把一堆「調教得好的 AI 文」誤判成「純手寫」 - 這正是現在社群「抓 AI 文」最常犯的錯.
那「純手寫」有沒有正面訊號? 直覺上有 - 口語化、句子長短不一、typo 不修、某個只有你會用的口頭禪或固定 emoji. 但這些目前全沒抓, 要抓得重新設計一套, 而且一旦公開, AI 馬上學得會. 這留給之後的實驗.
為什麼要做成工具? 老實說動機很個人 (jason3e7): 這些特徵看久了, 我就是會不太舒服, 所以想要一個「一眼就能辨識」的東西. 那種感覺, 有點像有些人看到簡體中文、或某些中國用語會覺得不對味 - 說不上誰對誰錯, 就是一種讀起來的直覺反應. 把它變成一個隨手能按的面板, 等於把這份直覺量化出來.
所以我把這套算法整個搬進瀏覽器, 做成一個 Tampermonkey userscript: 瀏覽任何網頁時浮出一個小面板, 即時給你這一頁的 N_sum 和 density, 外加 9 個訊號的逐項拆解.
完整程式碼放在我的 GitHub (點進去複製整份貼上, 會保持最新): https://github.com/jason3e7/ai-101/blob/master/05-notes/assets/browser-ranker.user.js
怎麼裝:
面板給你什麼:
base ÷ 去空白字數 × 1000, 跟全屆平均 69.7 比註: 瀏覽器版跟完整分數用同一套 9 個訊號、同樣的權重與公式 (實測同一篇文章的 B 與 N_sum 數字一致; density 因瀏覽器算空白字數的方式略有 1% 內誤差). iThome 文章頁自動抓正文區塊, 其他網頁退而抓主內容, 程式碼區塊一律排除 - 跟分析程式一樣. 面板的訊號標籤用白話寫, 不是程式裡的代號.
一、我自己的稿也會「亮」(而且它確實碰過 AI).
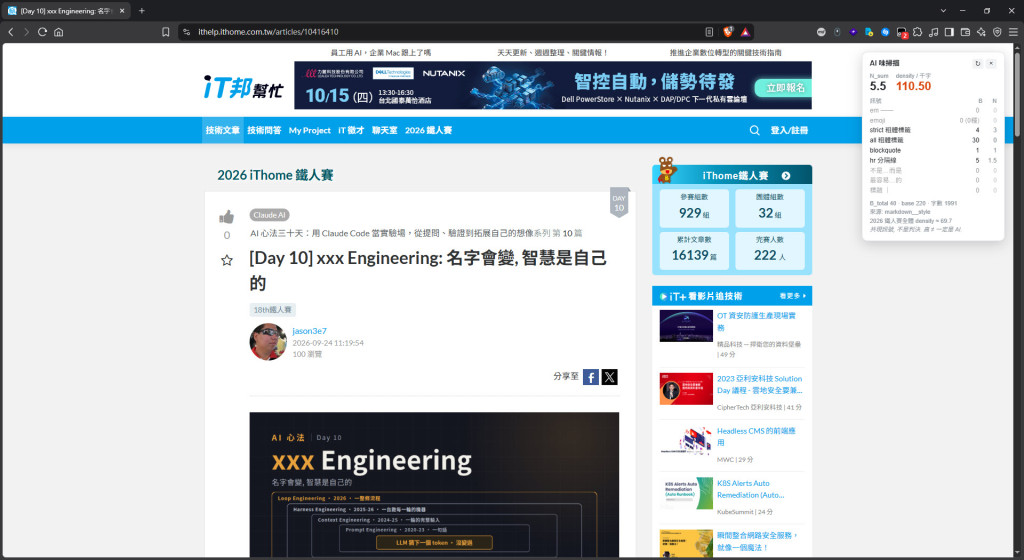
掃我自己的 Day 10 這篇, density 110.50, 高於全體 69.7. 這篇我確實有用 AI 幫忙. 但注意它是怎麼被抓到的: 破折號 0、中文那三個 (不是⋯而是/最容易⋯的/標題 |) 全 0, 分數全靠排版 (粗體標籤、粗體、引用、分隔線). 它中的不是那幾個最有名的 tell, 中的是排版習慣 - 這反過來也剛好是本篇的重點: 破折號和中文腔調掛零, 不代表沒碰 AI.
二、冠軍系列裡的一篇, 訊號疊好疊滿.
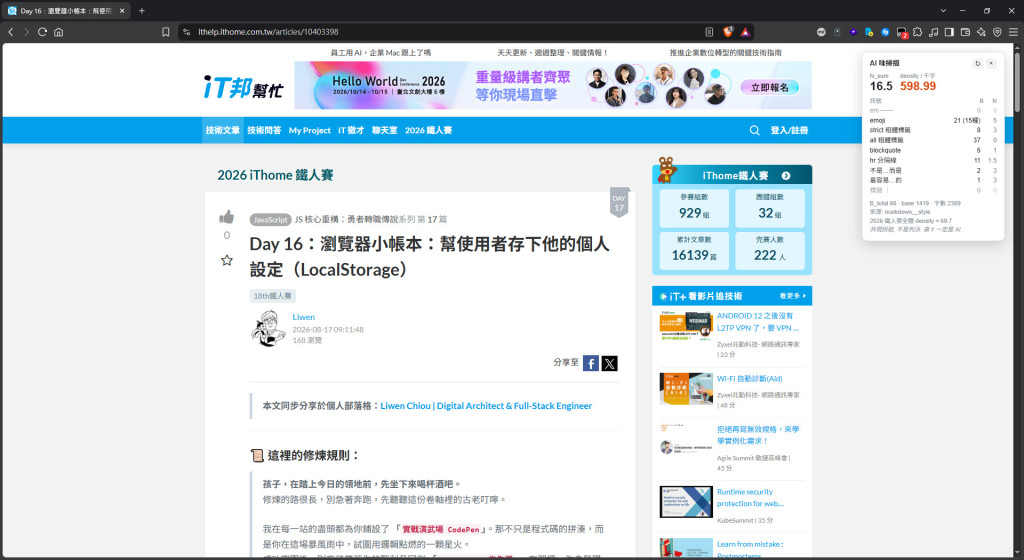
全站 top 1 系列「JS 核心重構」裡的一篇, density 598.99: emoji 15 種、粗體、引用、分隔線全開, 連中文的「不是⋯而是」「最容易⋯的」都中. 這就是這把尺眼中「很濃」的樣子.
三、換到非 iThome 的網站, 一樣自動掃.
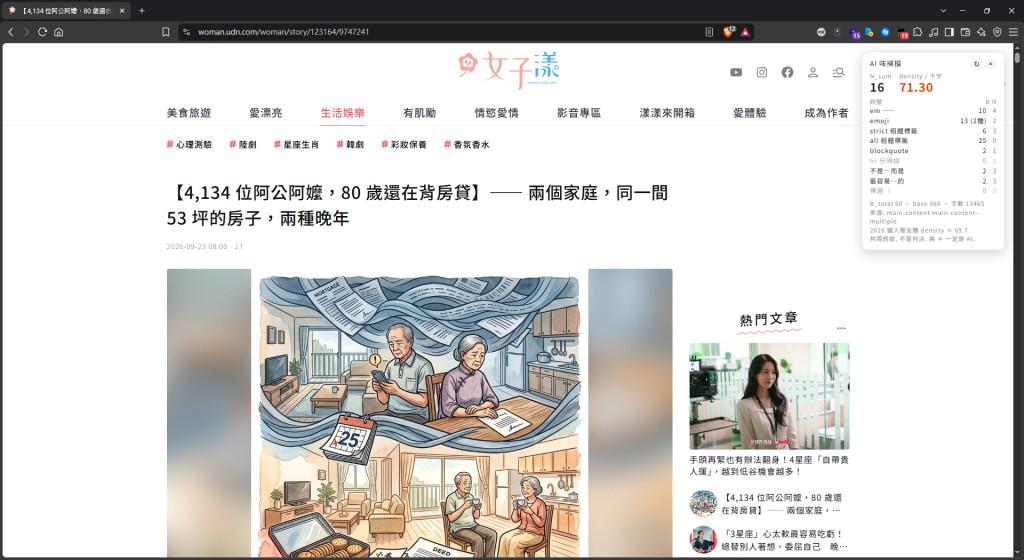
換到一般媒體 (udn 女子漾) 也自動浮出面板 - 它找不到 iThome 的正文框, 就退而抓頁面主內容. 這篇生活報導 density 71.30, 破折號 10 次、「不是⋯而是」「最容易⋯的」各 2 都中, 標題開頭還真的用了 ——. 這正是「每個網站都能量」的意思.
注意: 面板上的數字是共現訊號, 不是判決. density 高只代表「這篇疊了很多常見的 AI 排版/句型習慣」, 不代表「一定是 AI 寫的」; density 低也不代表「一定是人寫的」(這就是上一段整段在講的事). 拿它排序、拿它當提醒, 別拿它當證據去指認任何人.
| 問題 | 這把尺答得出來嗎 | 為什麼 |
|---|---|---|
| 這批文章裡, 哪些最像 AI? | 可以, 排序有信度 | signal 命中就是真的有這些習慣 |
| 這篇比那篇更有 AI 味嗎? | 可以, 相對比較可用 | 同一把尺量, 相對關係穩 |
| 這篇是 AI 寫的嗎? | 只能說「像不像」 | 單篇、單一分數不能定罪, 要看密度 + 內容空不空 |
| 這篇是純手寫、沒碰 AI 嗎? | 答不出來 | 零命中 = 沒用 AI 或 壓乾淨, 分不開 |
| 這位作者從沒用過 AI? | 更答不出來 | 證明「從來沒有」在認識論上不可能 |
一句話收: 這把尺往「找 AI 味」的方向有用, 往「認人」的方向整個失效. 這不是 bug, 是這類工具的天花板.
—— 掃全屆, ChatGPT 組 0.11 的來源

 iThome鐵人賽
 看影片追技術