
Day 16 到 Day 18 做的是自己疊的粗偵測 (共現訊號 — ——、emoji、粗體、…). 這些訊號有價值 (排序用), 但明顯有盲區 (單一指紋被 upstream 壓就失效, 翻面問題「純手寫」更難回答).
那官方正式做的呢? 2026-08-02 起, Claude 的產出開始埋看不見的標記: 文字是嵌入式浮水印 (複製貼上會跟著跑), 檔案是 C2PA 簽章 metadata. OpenAI 的影像從 2026-05 也全面加 SynthID + C2PA. 這些不是我自己疊的指標, 是模型廠商官方 ship 的技術.
然後呢? 這篇講三件事:
結論跟 Day 16-18 一樣: 是線索, 不是鐵證. 但這個結論對官方浮水印更重要, 因為它天生帶權威光環, 讓人以為「官方的驗證結果就是真相」. 不是.
Anthropic 用兩種互補技術 (2026-08-02 起):
| 對象 | 技術 | 特性 |
|---|---|---|
| 文字 | 嵌入式浮水印 — 把難以察覺的標記織進文字本身 | 不影響品質與可讀性; 複製貼上會跟著跑 |
| 檔案 (.png / .jpg / .svg…) | 簽章 metadata, 遵循 C2PA 開放標準 (內容來源與真實性聯盟) | 記錄內容來源; 但 metadata 可能被平台剝除 |
適用範圍: 2026-08-02 之後推出的新模型從第一天就支援, 涵蓋 API / Claude 網頁版 / Claude Code / Claude Cowork / 各雲端夥伴. 全球適用.
怎麼查:
(Wisely Chen 的拆解 整理, 外部推測, 非官方細節):
U+00A0 (不換行空白)、U+2009 (窄空白)a ↔ 西里爾 а — 跟釣魚網址 pаypal.com 騙人同一手法前兩種是字元層級 (工具檢查 Unicode 碼位揪得出來), 第三種是統計層級 (要大量文本 + 演算法才驗得出). 改寫會讓浮水印消失 — 下一節是重點.
這是全篇最重要的一段, Anthropic 官方自己也特別強調:
⚠️ 查到標記 ≠ 這是 AI 寫的: 只代表內容「可能經 Claude 處理過」 — 可能只是拿去校對、翻譯、改格式, 原作者仍是人.
⚠️ 沒查到標記 ≠ 這是人寫的: 可能是舊模型產出、被大幅編輯過、文字太短、metadata 被平台剝除, 或用了不支援標記的工具.
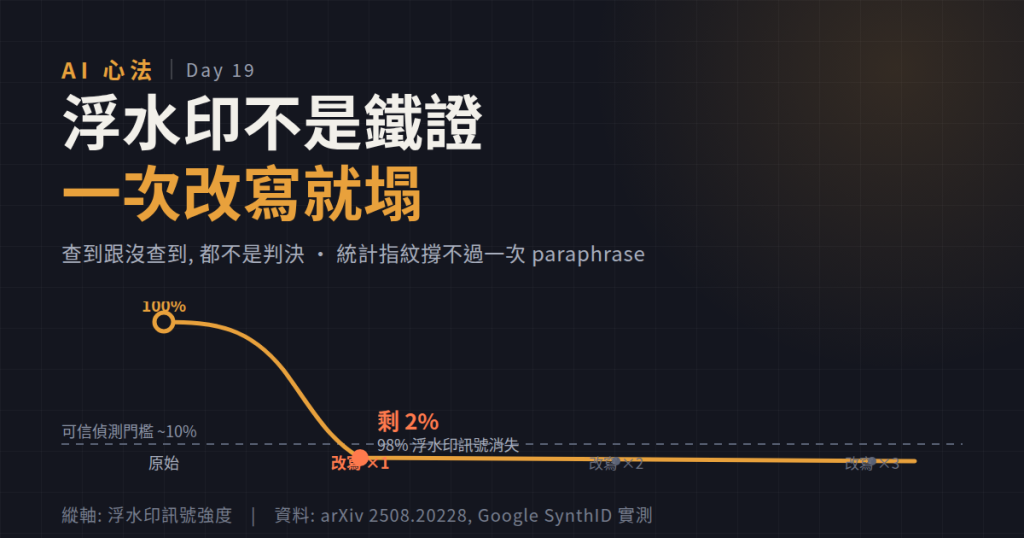
2026 一份研究 (arXiv:2508.20228) 在 Google SynthID-Text 上實測:
換句話說, 只要作者「用 AI 寫完再用另一個 AI 改寫一次」就能大幅逃過偵測. 這不是 SynthID 特有的缺陷, 統計指紋類的浮水印都受這種攻擊影響. Anthropic 的技術細節未公開, 但一般假設面對 paraphrase 攻擊也不會樂觀太多.
所以浮水印是線索, 不是判決. 拿「沒查到」當「這是人寫的」會冤枉人, 拿「查到」當「這是 AI 代寫」也會冤枉人.
不是廠商自願, 是監管逼的.
驅動來源: EU AI Act Article 50 於 2026-08-02 生效 (歐盟官方公告). 這條要求:
所以 2026 一堆廠商同步動起來:
張力: 溯源透明 vs 使用者接受度. 在影像領域監管壓力較大 (deepfake 政治風險高)、使用者反彈相對小, 文字則相反. 未來看到 AI 廠商加浮水印, 先問「是不是被監管逼的」, 答案通常是「對」.
——、emoji、粗體、…) 本質一樣: 都是證據, 都不是鐵證. 把兩者疊起來也不會變鐵證, 只會提高「可能性」

 iThome鐵人賽
 看影片追技術