
Day 16 的結論之一: 當初挑 —— 是圖它最粗最好算, 但這個指紋對 GPT 生態已經在失效. 2025-11 GPT-5.1 開始能遵守「不要用 em-dash」的 custom instruction, 用 ChatGPT/Codex 寫的作者天然沒訊號, 一個 signal 就塌一半.
單指紋還有別的盲區:
——, 單一指標完全漏掉—— 的老派人類作者: 單一指標誤判—— 但狂灑 emoji + 粗體 + 分段線, 單一指標完全漏掉要補這些洞, 做法是疊更多 signal. 單一壞掉其他補得起. 這篇疊到綜合分數 (6 個 signal, 總量加權型), 用同一批 2026-09 corpus (15,057 篇) 重跑排名.
疊 signal 的思路不是新鮮事: 學術界的 Ghostbuster (Verma et al. NAACL 2024) 用多 feature 綜合計分做 AI 文本偵測; Muñoz-Ortiz & Gómez-Rodríguez 2024 統計上找人 vs LLM 寫作的語言 pattern 差異. 這篇是把同一條思路用在中文鐵人賽的 markdown 排版上.
從單指紋逐步加上五個 signal, 總共六個:
| Signal | 偵測 | 權重 N | 命中率 |
|---|---|---|---|
雙 em dash —— |
兩個 em dash 連在一起 (Day 16 已講) | 4 | 30.2% |
| emoji | emoji 數 × distinct 種類 | types (平均 2.90) | 16.9% |
| 嚴格粗體 pattern | - **標籤**: 說明 |
3 | 28.2% |
| 一般粗體 | 任何 **xxx** |
0 | 68.2% |
| blockquote | > 引用塊 |
1 | 42.9% |
水平線 <hr> |
--- 分段 |
1.5 | 38.2% |
幾個設計重點:
<hr> 1→1.5)○ ✗ ★ ☆ ☐ 這些 checklist / 星等排版符號人類也常用, 不算B_total = em + emoji + strict + all + bq + hr ← 命中總次數
N_sum = Σ (N where that signal fires)
= (4 if em>0) + (types if emoji>0) + (3 if strict>0)
+ (0 if all>0) + (1 if bq>0) + (1.5 if hr>0)
base = B_total × N_sum
density = base / 總字數 × 1000 ← 排名主指標
一般粗體 N=0 當放大器: all count 本身不給 vote (N=0), 但 count 進 B_total, 把全盤放大 N_sum 倍. 這是刻意的設計 — 粗體排版重度 (就算每項權重 0) 也會放大其他 signal 的影響.
舉例: 「使用gemini 準備 az-900 Day 21」:
em=20, emoji=101(25 種), strict=170, all=248, bq=15, hr=21
B_total = 575
N_sum   = 4 + 25 + 3 + 0 + 1 + 1.5 = 34.5
base    = 575 × 34.5 = 19,837.5
density = 19,837.5 / 19,693 × 1000 ≈ 1007 (全體 top 6)
all=248 本身 N=0 不給 vote, 但 248 這個數字進 B_total 把全盤放大 34.5 倍.
抓取時間 2026-09-30. 同樣掃出 814 系列、15,057 篇文章.
| 項目 | 數值 |
|---|---|
| base 總和 | 2,197,603 |
| 全篇總字數 | 39,634,634 |
| 全體 density | 55.45 |
Day 16 單 signal 全體 0.86 → 綜合分數 55.45, 數字差 60 倍 (因為加了 6 個 signal 的 B 乘以 N_sum, scale 完全不同). scale 不是重點, 排名才是.
| # | density | B_total | N_sum | 文章 | 系列 |
|---|---|---|---|---|---|
| 1 | 1141.26 | 496 | 39.5 | Azure Advisor & Service Health Day 6 | 使用gemini 準備 az-900 |
| 2 | 1100.59 | 149 | 27.5 | Day 12: 你敢不敢承認你只優化了自己那一段? | Phoenix 2026 (DevOps RPG) |
| 3 | 1077.31 | 97 | 25.5 | Day 02: 清點魔法物資 | JS 核心重構: 勇者轉職傳說 |
| 4 | 1008.95 | 287 | 26.5 | 使用gemini 準備 az-900 Day 1 | 使用gemini 準備 az-900 |
| 5 | 1008.15 | 106 | 24.5 | Day 03: 極速短咒 箭頭函式 | JS 核心重構: 勇者轉職傳說 |
| # | density | 篇數 | 系列 |
|---|---|---|---|
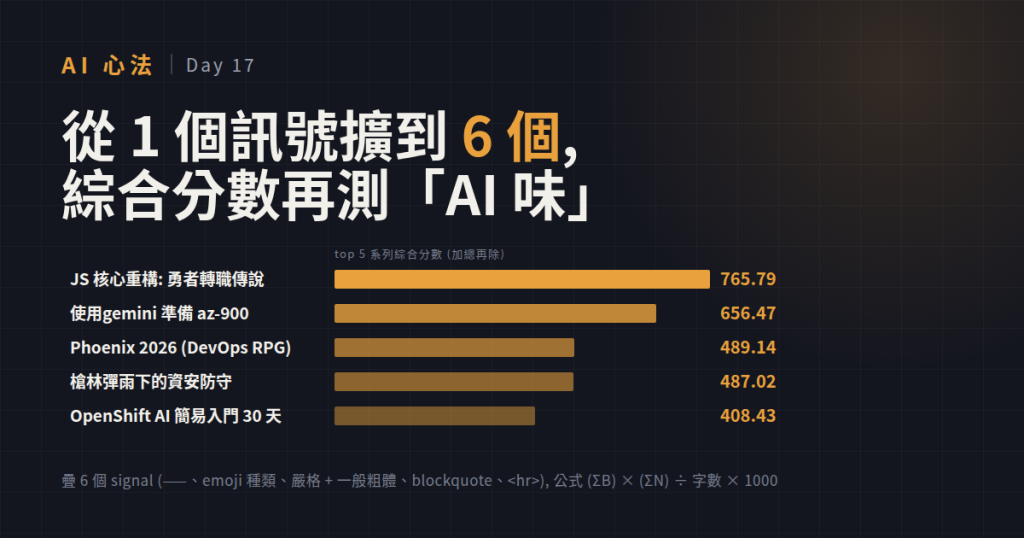
| 1 | 765.79 | 31 | JS 核心重構: 勇者轉職傳說 |
| 2 | 656.47 | 30 | 使用gemini 準備 az-900 |
| 3 | 489.14 | 30 | Phoenix 2026 (DevOps RPG) |
| 4 | 487.02 | 30 | 槍林彈雨下的資安防守 |
| 5 | 408.43 | 29 | OpenShift AI 簡易入門 30 天 |
—— 比: top 3 完全不重疊 — Different Lens, Different Top| 排名 | Day 16 (單 —— 指紋) |
Day 17 (綜合分數 6 signal) |
|---|---|---|
| 1 | Day01 Claude 從零打造軟體產品 (17.51) | 使用gemini 準備 az-900 Day 6 (1141.26) |
| 2 | 白稜 Day 12 流程再造 (14.29) | Phoenix 2026 Day 12 (1100.59) |
| 3 | mpv-lazy Day25 (13.49) | JS 核心重構 Day 02 (1077.31) |
兩套 top 3 完全不重疊. 不是誰對誰錯, 是兩個指標在量不同的「AI 味」:
—— 用得兇. 單一 tell 強, 其他 signal 平淡——
—— 只有 3, 但 emoji 49 (30 種)、一般粗體 298、嚴格 pattern 111、<hr> 22 — 典型「什麼都疊」. 綜合分數爆分, 單指紋排行外—— 密度 17.51 全屆第 1, 但其他 signal 不特別, 綜合分數排名掉到幾十名後單一指紋捕捉的是某種 AI 味 (em-dash 愛好者), 綜合指紋捕捉的是另一種 (markdown 排版 maximalist). 兩套互補, 不是取代. Day 16 的工具揭露了 GPT 生態的指紋失效, Day 17 的工具揭露了另一群 upstream 沒壓的「排版重度」作者.
——、算整篇含標題與程式碼、不設字數門檻、不 doxx) 同 Day 16
—— 對 GPT 生態已失效), 疊 signal 是必要的補救—— 掃全屆

 iThome鐵人賽
 看影片追技術