

Day 18 的草稿只看廣告圖本身,但常常發生客人點下去之後看到的是另一個頁面,秋日棉織專案有一張 Meta 的廣告圖 cr-meta-aut-p1,左上角兩個徽章寫著「秋日」「限定」,點進活動頁從頭看到尾,沒有寫限量幾組,也沒有寫到哪一天截止,「限定」兩個字在頁面上找不到任何對應的說明,尤其是同個時段不只有一個活動檔期時,在過去往往只能靠人工來抓漏,這些細節很容易被忽略。
這種落差平常很難發現的原因之一在於廣告圖和活動頁通常不是同一個時間做的,兩邊各自上線之後,很少有人會把 24 張圖一張一張點進去對,今天把這件事交給 Gemini,每張廣告圖連同它導去的頁面一起給它看,請它列出廣告有寫、頁面找不到或說法不同的地方,再拿事先寫好的答案對照它抓到幾成,頁面用兩種方式給,一種給截圖、一種給文字,看哪一種抓得準、哪一種作法便宜。
今日核心目標:
| 步驟 | 做什麼 | 產出 |
|---|---|---|
| 準備頁面 | 首頁與兩個活動頁各存一份文字、各截三段圖,廣告圖依活動代號對到頁面 | ref_landing_pages 3 列、obj_landing 9 張、map_creative_landing 24 列 |
| 寫答案 | 廣告有寫、頁面沒有的落差逐列寫下來,先 commit 再呼叫 | martech_gt.gt_ad_page_gaps 計分 21 列、有爭議 9 列 |
| 比對 | 24 張廣告圖 × 2 種給頁面的方式,response_schema 規定落差清單的欄位 | mm_gaps_log 48 筆呼叫紀錄 |
| 對答案 | 同一種落差而且指到同一段廣告文字才算抓到 | mart_ad_page_gaps |
| 檢查與報表 | 14 項流程檢查、八段報表 | check.sql、report.sql |
💡 核心工程理念:
run.sh 發現答案、題目、截圖或評分的 SQL 有還沒 commit 的修改會直接停下來,每次評分都記下答案表的指紋(用內容算出來的一串檢查碼),事後改過答案檢查就不會過24 張廣告圖依活動代號對到三個頁面,常態素材 8 張到首頁,重訓襪專案 8 張到 /lp/training-socks,秋日棉織專案 8 張到 /lp/autumn-cotton,這張對照表 map_creative_landing 從 Day 07 的 dim_creative 直接算出來。
廣告圖上的字是 Day 14 之前用程式照規格畫上去的,每張圖有一行標題,文字多的圖另外有兩行賣點和兩個徽章,頁面內容來自 Day 04 的小店,兩邊逐字比對之後,查得到對錯的落差有五種:
| 落差種類 | 廣告圖上寫的 | 頁面上的情況 | 張數 |
|---|---|---|---|
| limited_offer | 徽章「限定」 | 秋日活動頁沒有限量、限時或截止日期 | 3 |
| special_price | 徽章「專案價」 | 重訓活動頁上厚底毛巾訓練襪 NT$ 260,沒有優惠價 | 3 |
| free_shipping | 徽章「免運」 | 首頁只在秋日專案那一格寫「滿 NT$ 600 免運」 | 5 |
| product_name | 標題「天天穿的純棉短襪」 | 頁面上的商品叫「日常中筒襪」 | 8 |
| product_option | 賣點「多色可選」 | 頁面沒有任何顏色選項 | 2 |
合計 21 列計分,這些落差本來就存在於素材和網站裡,不是為了今天另外做的,只是從來沒有人列過,柔軟、蓬鬆這類形容觸感或質感的文案不收,因為沒有對錯可以查。
另外有 9 列標成有爭議,不管 Gemini 有沒有列都不計分,一列是 cr-line-trn-r2 的「專案價」,這張圖主打的是日常中筒襪,活動頁上標 NT$ 180、原價 NT$ 220 劃掉,但那是全站都有的價格,算不算專案價見仁見智,另外 8 列是名稱不完全一樣、指的卻是同一件商品,廣告寫「襪子+毛巾新手組」頁面叫「日常入門組合」,廣告寫「厚底毛巾襪」頁面叫「厚底毛巾訓練襪」,短襪和中筒襪就不同了,襪筒長度不一樣,客人收到的東西會和廣告說的不同所以計分。
24 張裡有 6 張沒有任何計分的落差,用來看 Gemini 會不會無中生有。
Day 14 到 Day 18 每次呼叫都只給一張圖,今天給截圖的那一半要一次給四張,AI.GENERATE 的第一個參數可以把文字和圖片依序排在一起,題目裡再說明哪一張是什麼:
AI.GENERATE(
  (CONCAT(t.intro, '第一張圖是廣告圖,後面三張圖是那個頁面的截圖,由上到下切成三段,相鄰兩段有一小部分重疊。\n\n', task_text),
   a.ref, l1.ref, l2.ref, l3.ref),
  connection_id => 'us.vertex_ai_conn',
  endpoint => 'gemini-3.6-flash',
  ...
)
a.ref 來自 Day 14 的物件表 obj_creatives,l1 到 l3 來自今天新建的物件表 obj_landing,指向素材 bucket 的 landing/ 資料夾。
頁面截圖沒有整張丟進去,首頁的整頁截圖寬 1,200、高 2,685 像素,Day 14 量過一張 1,200 × 628 的廣告圖大約算 1,100 個 Token,如果長圖也只給這麼多,小字就會糊掉,動手之前先把首頁截圖縮小來看,「滿 NT$ 600 免運」那一行已經很難辨識,所以每個頁面都由上到下切成三段,首頁等分三段,兩個活動頁照內容切成主視覺、專案商品和頁尾,這是用縮圖模擬的判斷,沒有實際拿整頁長圖去問 Gemini,今天實測首頁的三段比活動頁的三段高,算出來的 Token 卻幾乎一樣,在今天這幾種尺寸下看不出 Token 數跟著圖片大小變。
給文字的那一半只給廣告圖,頁面上看得到的文字接在題目最後面,文字是用不開視窗的瀏覽器程式從同一個頁面擷取的,純文字看不出哪個價格被劃掉,所以擷取時把劃掉的價格寫成「NT$ 180(原價 NT$ 220,已劃掉)」。
回答的格式用 response_schema 規定,先把廣告圖上的每一段文字抄進 ad_texts,再把落差一項一項列出來,落差種類用 enum 鎖在八個選項裡,五種要查的、兩種答案表沒有的(gift 贈品、warranty 保固或退換貨),再加一個 other:
"response_schema": {"type": "OBJECT", "properties": {
  "ad_texts": {"type": "ARRAY", "items": {"type": "STRING"}},
  "gaps": {"type": "ARRAY", "items": {"type": "OBJECT", "properties": {
    "gap_type": {"type": "STRING", "enum": ["limited_offer", "special_price", "free_shipping",
                 "gift", "warranty", "product_name", "product_option", "other"]},
    "ad_text": {"type": "STRING"},
    "page_evidence": {"type": "STRING"}
  }, "required": ["gap_type", "ad_text", "page_evidence"]}}
}, "required": ["ad_texts", "gaps"]}
先抄廣告文字這一步是為了事後分得出兩種漏法,一種是字有讀到但沒列成落差,一種是字根本沒讀對。
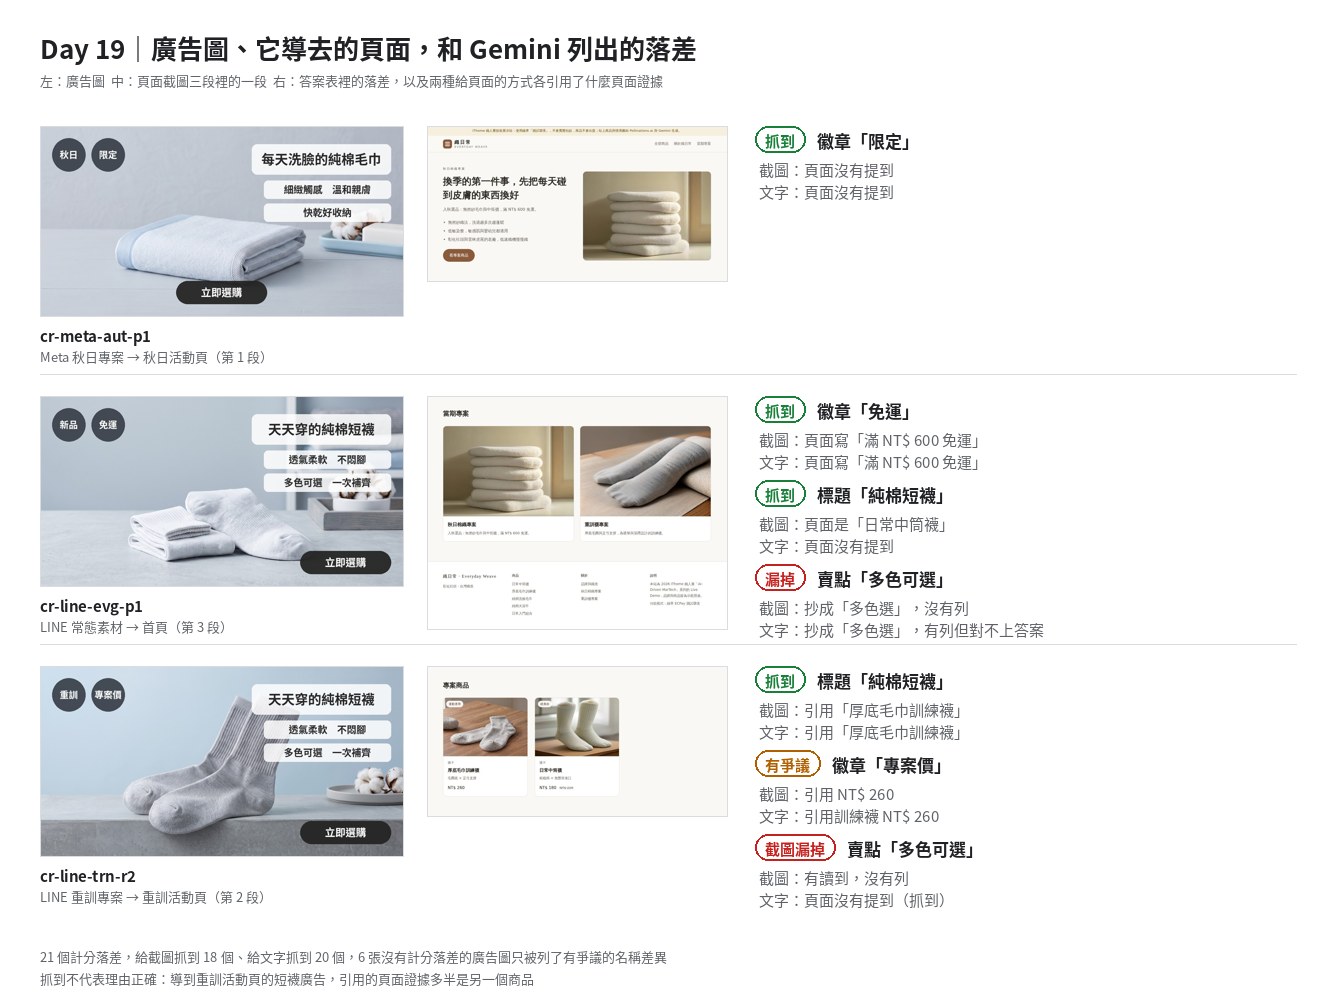
48 次呼叫全部成功,沒有一次撞到輸出上限,對答案的規則是同一種落差、而且 Gemini 抄下來的那段廣告文字裡有答案表的那個詞才算抓到,只有種類對不算。
| 落差種類 | 答案 | 給截圖抓到 | 給文字抓到 |
|---|---|---|---|
| free_shipping 免運 | 5 | 5 | 5 |
| special_price 專案價 | 3 | 3 | 3 |
| product_name 短襪 | 8 | 8 | 8 |
| limited_offer 限定 | 3 | 2 | 3 |
| product_option 多色可選 | 2 | 0 | 1 |
| 合計 | 21 | 18 | 20 |
免運、專案價和商品名稱三種全部抓到,免運那五張 Gemini 引用的頁面原文都是「滿 NT$ 600 免運」那一句,引用的正是寫了門檻的那一句,6 張沒有計分落差的廣告圖,除了下面會提到的有爭議名稱之外,兩種給法都沒有多列任何一項,清單上那兩種答案表沒有的落差也一次都沒有被填。
漏掉的有四格,給截圖的 cr-line-aut-p2 有把「限定」抄進廣告文字,卻沒有列成落差,cr-line-trn-r2 的「多色可選」也是有讀到沒列,另外兩格都在 cr-line-evg-p1,這張圖上的「多色可選」兩種給法都被抄成「多色選」,少了一個字,給截圖的那次沒有列,給文字的那次有列出來,但因為抄下來的字裡沒有「多色可選」,照事先定好的規則算成漏掉一個、多列一個,所以給文字那一欄實際上是 21 個落差都有指出來,其中一個字抄錯。
抓到不代表理由都對,短襪對中筒襪這一種 8 張都抓到,可是導到重訓活動頁的 4 張,兩種給法共 8 次,Gemini 引用的頁面證據有 6 次含「厚底毛巾訓練襪」,只有 2 次提到真正對不上的那個商品「日常中筒襪」,而且這 2 次都是給截圖的,看起來像是把頁面主打的訓練襪當成對不上的對象,結論一樣是對不上,理由卻不是答案表寫的那一個,有爭議的 cr-line-trn-r2 兩種給法都列了「專案價」,引用的價格是訓練襪的 NT$ 260,不是這張圖主打的中筒襪。
有爭議的名稱差異兩種給法的做法不太一樣,「新手組」對「日常入門組合」兩張都被列出來,「厚底毛巾襪」對「厚底毛巾訓練襪」給截圖的列了 6 張裡的 5 張,給文字的只列 1 張,這幾列不計分,但實際使用時會多出一批需要人判斷的項目。
| 項目 | 給截圖(廣告圖+三段截圖) | 給文字(廣告圖+頁面文字) |
|---|---|---|
| 抓到的計分落差 | 18/21 | 20/21 |
| 沒有計分落差卻被多列的廣告圖 | 0/6 | 0/6 |
| 有爭議的 9 列被列出來 | 8 | 4 |
| 填 other 的項目 | 0 | 1(徽章「新品」) |
| 平均每次輸入 Token | 4,998 | 2,148 |
| 平均每次輸出 Token(含思考) | 123 | 190 |
| 24 次費用 | 新台幣 3.56 元 | 新台幣 1.96 元 |
兩種給法差 2 格,每一格只問了一次,而且 21 列其實是五種落差在不同圖上重複出現,這個差距不足以說文字比較準,看得出來的是兩種給法都能用,五種落差裡有四種兩種給法都抓得到,多色可選這一種給截圖 0/2、給文字 1/2,但它只有 2 列,其中一列還是字抄錯,同樣不足以下結論。
差別明確的是成本,給截圖一次是四張圖,每張大約 1,100 個 Token,光圖片就 4,400 上下,給文字只有一張圖加上幾百個字,給截圖的輸入是 4,998、給文字是 2,148,是 2.3 倍,費用是 1.8 倍,費用的倍數比較小有一部分是運氣,給文字的 24 次裡有 4 次多用了思考 Token,給截圖的只有 1 次,兩邊真正寫出來的回答長度幾乎一樣。
頁面文字拿得到的時候給文字就夠了,但文字擷取會漏掉只存在於畫面上的資訊,今天碰到的是劃掉的原價,如果沒有另外註明,文字版的 Gemini 會看到同一個商品有兩個價格,價格寫在圖片裡的橫幅也是同樣的情況,這時候截圖才派得上用場並且要記得切開。
run.sh 呼叫 Gemini 前先依「這次真的要呼叫的次數」印出估價,輸入平均以每次 4,250 個 Token、輸出以上限 2,048 個 Token 計,48 次約新台幣 18.4 元,輸入 yes 才會呼叫,跑過的組合不重跑,同一輪裡緊接著的重跑呼叫 0 次| 項目 | 呼叫次數 | 輸入 Token | 輸出 Token(含思考) | 費用 |
|---|---|---|---|---|
| 給截圖 | 24 | 119,960 | 2,952 | 新台幣 3.56 元 |
| 給文字 | 24 | 51,560 | 4,557 | 新台幣 1.96 元 |
| 合計 | 48 | 171,520 | 7,509 | 新台幣 5.52 元 |
費用依 gemini-3.6-flash 非 global 端點的單價(輸入每百萬 Token 0.825 美元、輸出 4.125 美元)與實際 Token 數算出,匯率以 1 美元約 32 元計,實付不到估價的三分之一,因為回答都很短,平均每次輸出只有一百多個 Token,估價是用輸出上限算的,48 次都記進 Day 16 建的共用用量表 ops_llm_usage。
~/ai-driven-martech-pipeline 執行 git pull,取得 Day 19 的 consistency/ 目錄與 creatives/landing/ 的九張截圖gcloud config get-value project 要印出你的專案 IDdim_creative)、Day 11(答案資料集 martech_gt)與 Day 14(素材 bucket 與物件表 obj_creatives)gcloud auth list,帳號前面要有星號cd ~/ai-driven-martech-pipeline && git pull && bash consistency/run.sh
run.sh 先把九張截圖上傳到素材 bucket,建好頁面文字、截圖物件表、對照表和答案表,印出這次要呼叫幾次和估價,輸入 yes 才會呼叫 Gemini,接著馬上重跑一次確認不重複收費,最後是對答案、14 項檢查和八段報表。
cd ~/ai-driven-martech-pipeline
PROJECT_ID=$(gcloud config get-value project)
gcloud storage cp creatives/landing/*.jpg gs://${PROJECT_ID}-martech-assets/landing/
sed "s/PROJECT_ID/${PROJECT_ID}/g" consistency/pages.sql | bq query --nouse_legacy_sql --format=pretty
bq query --nouse_legacy_sql --format=pretty < consistency/answers.sql
pages.sql 建立頁面文字 ref_landing_pages、截圖物件表 obj_landing 和對照表 map_creative_landing,answers.sql 把 30 列答案寫進 martech_gt.gt_ad_page_gaps,這兩步都不呼叫 Gemini。
bq query --nouse_legacy_sql --format=pretty < consistency/compare.sql
這一步會呼叫 Gemini,48 次約新台幣 5.5 元,直接執行不會先問,只補還沒成功的組合,印出兩種給法各呼叫幾次、成功幾次和 Token 數。
bq query --nouse_legacy_sql --format=pretty < consistency/score.sql
bq query --nouse_legacy_sql --format=pretty < consistency/check.sql
bq query --nouse_legacy_sql --format=pretty --max_rows=200 < consistency/report.sql
score.sql 把每一格判成抓到、漏掉、多列、有爭議或其他,放進 mart_ad_page_gaps,check.sql 是 12 項流程檢查,另外兩項由 run.sh 補上,一項確認緊接著的重跑沒有重複呼叫,一項用 grep 確認準備題目與呼叫 Gemini 的 SQL 沒有讀答案資料集,report.sql 八段分別是對照表、總成績、各種落差、漏掉與多列的原文、有爭議的列、填 other 的原文、兩種給法逐格比較與費用。
mm_gaps_log 48 列,image、text 各 24 列,finish_reason 沒有 MAX_TOKENSclean_flagged(沒有計分落差卻被多列的張數)與 decoy(清單上兩種不存在的落差被填的次數)都是 0run.sh 的 14 項檢查全部通過,緊接著的重跑呼叫 0 次Gemini 每次的回答不會完全一樣,你跑出來抓到的格數可能和這裡不同。
mart_ad_page_gaps、mm_gaps_log 和答案表都留著,素材 bucket 的 landing/ 資料夾九張截圖不到 1 MB,不需要的話可以自己刪掉,題目改過之後想重問,先把 mm_gaps_log 改名留存再執行,成功過的組合不會因為題目變了就自動重問。
今天把 24 張廣告圖和它們導去的三個頁面交給 gemini-3.6-flash,在 BigQuery 裡一次給多張圖做比對,事先寫好的 21 個落差,給截圖抓到 18 個、給文字抓到 20 個,6 張沒有計分落差的廣告圖除了有爭議的名稱差異(給截圖列了 2 張)之外沒有被多列,清單上兩種不存在的落差也沒有被硬填,48 次呼叫合計約新台幣 5.5 元。
回到篇名,廣告說一套、網站寫一套這種事 AI 抓得出來,免運少了門檻、專案價找不到優惠、短襪變成中筒襪都被列出來了,但它引用的頁面證據有時候指錯商品,名稱不完全一樣這種見仁見智的項目也會一起列出來,適合拿來當上線前的第一輪檢查,列出來的每一項還是要有人看過,兩種給法抓到的差不多,給截圖的輸入是給文字的 2.3 倍,頁面文字拿得到就給文字,只有畫面上才看得到的資訊再用截圖。
明日預告:Day 20《便宜的輕量模型到底夠不夠用?直接實測來看》,今天和 Day 18 用的是 gemini-3.6-flash,Day 14 到 Day 16 主要用 gemini-3.5-flash-lite,明天把同一批看圖的題目交給不同等級的模型,比正確率、速度和費用。


 iThome鐵人賽
 看影片追技術