
大家都知道傳統的測試金字塔
這時代如果再多了 Agent 測試階段,測試金塔的維度就會不太一樣
AI Agent 測試要拆成三層來看,傳統測試守最底層,三層共存互補,不是取代。
這些名詞,先有個印象就好:
| 名詞 | 白話解釋 |
|---|---|
| 評估器(Evaluator) | 幫 AI 的回答打分數的規則,可以是程式,也可以是另一個 AI |
| LLM-as-Judge | 讓另一個 AI 當裁判,判斷回答好不好 |
| Ground Truth(基準真相) | 你的「預期答案」,評分時拿來對照的標準 |
| 執行軌跡(Tracing) | AI 從收到問題到回答,中間每一步做了什麼的完整紀錄 |
| 工具呼叫(Tool Call) | AI 去呼叫外部功能,例如查訂單 API |
| 意圖判斷(Router) | AI 先判斷使用者想做什麼,再決定要走哪條路 |
後面章節每個都會再細講。
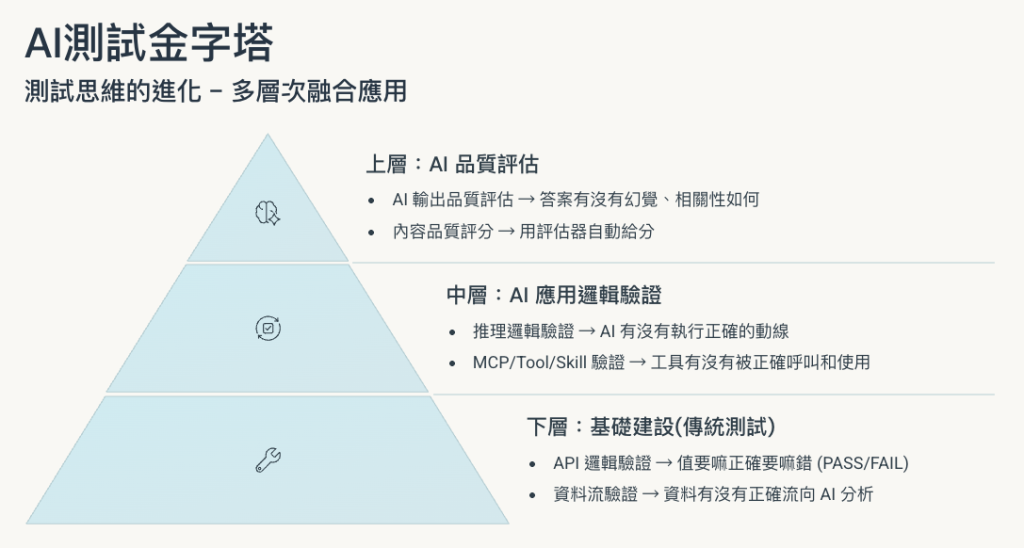
| 層級 | 測什麼 | 怎麼驗證 | 思維 |
|---|---|---|---|
| 上層:品質評估 | 回答好不好:相關性、幻覺、完整性 | 評估器打分數 + Ground Truth(預期答案) | AI 測試思維 |
| 中層:AI 邏輯驗證 | 推理對不對:動線有沒有走對、工具有沒有叫對 | 看執行軌跡(Tracing)+ 邏輯驗證 | AI 測試思維 |
| 下層:基礎建設 | 功能能不能用:API、資料流 | 自動化腳本,PASS / FAIL | 傳統測試思維 |
備注:這篇只要知道測試層級維度變更高且更複雜了,就會非常考驗一名 QA 測試能力深度的
用一個例子從下往上走一遍:
使用者問客服 Agent:「我的訂單 A123 到哪了?」

[下層] API 有收到請求、訂單 A123 的物流資料有正確查回來?  → PASS / FAIL
   ↓
[中層] AI 有沒有判斷出「查訂單」意圖,並呼叫「訂單查詢」工具、參數帶 A123? → Agent 動線對不對
   ↓
[上層] 最後回答的物流狀態跟查到的資料一致嗎?有沒有自己編送達日期? → Agent 語意評分 0.85
👉(這就像評一家餐廳。下層是食材新不新鮮,中層是廚師有沒有照流程做菜,上層是菜到底好不好吃。)
不只是分三層,數量跟成本也是金字塔的形狀:
| 層級 | 案例數量 | 速度 | 成本 |
|---|---|---|---|
| 上層 | 少 | 慢 | 貴,每次評分都要呼叫 LLM |
| 中層 | 中 | 中 | 中,大多也都可以程式測試 |
| 下層 | 多 | 快 | 便宜,純程式 |
能用下層擋掉的問題,就不要拖到上層才發現。
資料都沒帶進來,AI 回答得再好也是錯的,這種問題用一支 API 測試就抓到了,不需要花錢請 LLM 來評分。
很多人一講到測 AI,就直接跳到「用 AI 評分回答品質」,中間那層整個跳過。
但中層才是 Agent 跟一般聊天機器人最大的差別:它會自己決定路徑、自己呼叫工具。
只看上層分數,你會遇到一個很熟悉的問題。
答案對,不代表過程對。中層就是在驗「過程」。
上層分數掉了,分層之後就能一層一層往下排查:
上層分數掉了
   ↓ 往下看
中層:動線有沒有變?工具有沒有叫錯?
   ↓ 再往下
下層:API 有沒有壞?資料有沒有帶錯?
沒有分層的話,你只知道「分數變低了」,不知道是哪裡壞的。
不過寫到中層,有一個前提一直沒講:
要驗證它有沒有「走對路」,你得先知道「對的路」長什麼樣子。
明天講我覺得測 Agent 最核心的一件事:先讀懂你要測的那個 Agent。


 iThome鐵人賽
 看影片追技術