
前幾天我們認識了樹和二元樹的基本功:專有名詞、建立方式、走訪、引線二元樹,以及把森林轉成二元樹。從今天開始,要把這些基礎拿來應用。第一個應用是累堆(heap,也常譯為堆積):一種能隨時拿到最大值(或最小值)的結構,也是實作優先權佇列最常見的方法。
先想像一個情境:銀行櫃台平常是先到先服務,就像 Day 11 的佇列。但如果客戶分成一般客戶和 VIP,VIP 一到就要優先處理,而且 VIP 還分成金卡、白金卡等不同等級,等級越高越先服務,該怎麼辦?這時「誰先來」已經不是重點,重點是「目前等待的人當中,誰的優先權最高」。客戶又會不斷進來,每服務完一位,就要馬上找出下一位最優先的對象。累堆正是為這種需求設計的結構:優先權最高的那位永遠在樹根,隨時都能直接拿到。
累堆是一種特殊的完整二元樹。這句話可以拆成兩半:「完整二元樹」講的是累堆的形狀,「特殊」講的是它多了一條數值上的規定。
Day 14 學過,完整二元樹(complete binary tree)是除了最底層以外每一層都填滿,最底層的節點從左到右連續排列,中間沒有空位。
累堆規定一定要長成這樣,好處是可以直接存進陣列。照 Day 14 的編號方式,由上而下、由左而右替節點編號,索引從 1 開始,索引 0 空著不用:
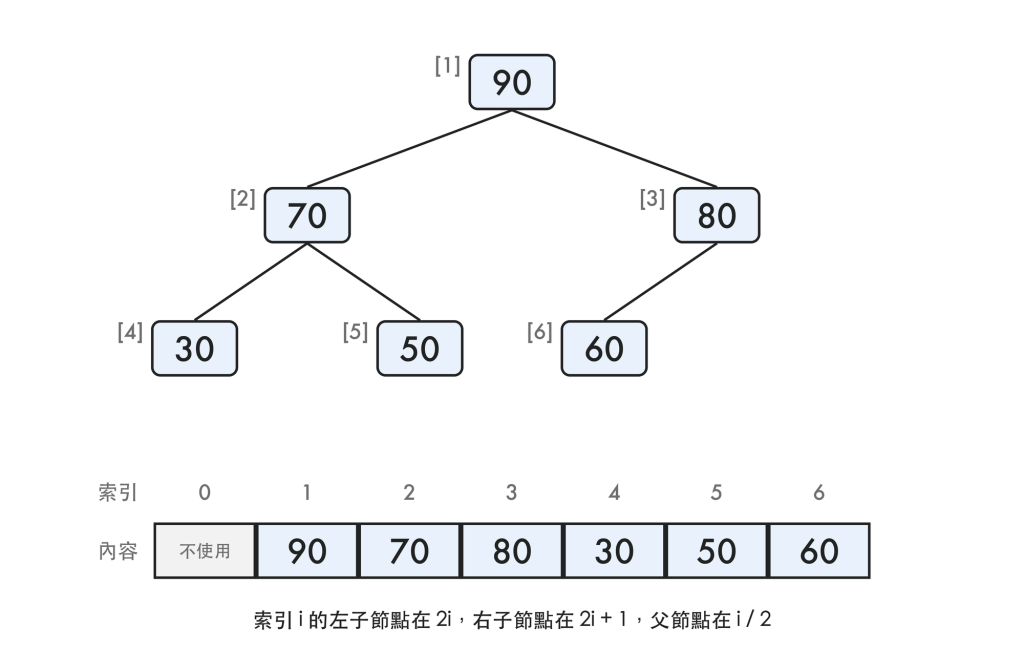
這樣存有三個好處:
為什麼索引 0 空著不用? 只是為了讓公式最簡單,不是非這樣不可。從索引 0 開始存也可以,只是每個公式都要多一個 +1 或 −1:
| 要找的節點 | 從索引 1 開始 | 從索引 0 開始 |
|---|---|---|
| 索引 i 的左子節點 | 2i | 2i + 1 |
| 索引 i 的右子節點 | 2i + 1 | 2i + 2 |
| 索引 i 的父節點 | i / 2 | (i − 1) / 2 |
例如從索引 0 開始存時,70 在索引 1,子節點在 2 × 1 + 1 = 3、2 × 1 + 2 = 4,一樣是 30 和 50。
從 1 開始的公式比較簡潔,是因為每一層第一個節點的編號剛好是 1、2、4、8……,每往下一層編號大約乘以 2,所以子節點是 2i、2i + 1,父節點就是除以 2。代價是 C 語言的陣列一定從 0 開始,空著索引 0 會浪費一個位置;不過只有一格,通常不在意。兩種寫法都正確,我們用 Day 14 從索引 1 開始的做法。
光是完整二元樹還不夠,累堆還要求每個節點都滿足以下其中一種規則:
上面那棵樹,每個父節點都比自己的子節點大,所以是最大累堆。既然每個節點都不小於它的子節點,一路往上比,最大值一定在樹根,這正是開頭 VIP 情境需要的性質;同理,最小累堆的樹根一定是最小值。
  完整,但不是最大累堆      符合大小規則,但不完整
         30                        90
       /    \                        \
     70      80                       80
因此可以這樣記:
累堆 = 完整二元樹(形狀)+ 父子之間的大小規定(順序)
要特別注意,累堆只規定父子之間的大小,兄弟之間沒有大小關係。例如最前面那棵樹的 70 和 80,誰在左、誰在右都可以。這點和之後會學的二元搜尋樹不同,二元搜尋樹要求左邊小、右邊大。
Day 1 介紹過抽象資料型態(ADT):只規定有哪些操作,不規定內部怎麼存。
所以比較精確的說法是「優先權佇列常用累堆實作」,而不是「優先權佇列就是累堆」。
優先權佇列也能用其他方式實作。設 n 是佇列中的資料筆數,比較幾種做法:
| 實作方式 | 放入 | 取出最大值 |
|---|---|---|
| 沒排序的陣列 | O(1):直接放到尾端 | O(n):要全部找一遍 |
| 排好序的陣列 | O(n):要找位置並搬移資料 | O(1):最大值固定在尾端 |
| 累堆 | O(log n) | O(log n) |
前兩種做法總有一個操作要 O(n);累堆的高度大約是 log₂ n,調整時最多只走樹高那麼多步,讓兩個操作都只要 O(log n)。如果只是查看最大值而不取出,累堆直接看樹根就好,只要 O(1)。
只要服務對象要「依優先權」而不是「依到達順序」處理,就可以考慮優先權佇列,底層常用累堆實作。它最能發揮作用的情況,是資料會一直進來,同時又要隨時取出目前優先權最高的那一筆:
如果資料一開始就全部到齊,只需要依序處理一次,那直接排序就好,不一定要用累堆。
還有一點要留意:累堆只保證取出的是優先權最高的資料。兩筆資料的優先權相同時,不保證先到的先出來。如果應用上要求「同優先權時先來先服務」,例如兩位病情相同的病人應該先看先掛號的那位,常見做法是多記一個到達序號:優先權相同時,序號小的先出來。
前面的比較表說累堆放入、取出都只要 O(log n),靠的就是這兩個操作:插入對應優先權佇列的「放入」,刪除對應「取出最大值」。以下都沿用前面那棵最大累堆,陣列內容是 90、70、80、30、50、60(索引 1~6)。
以插入 85 為例:85 先放在索引 7,成為 80 的右子節點。85 比父節點 80 大,兩者交換,85 上升到索引 3;接著和新的父節點 90 比較,85 比 90 小,停止。
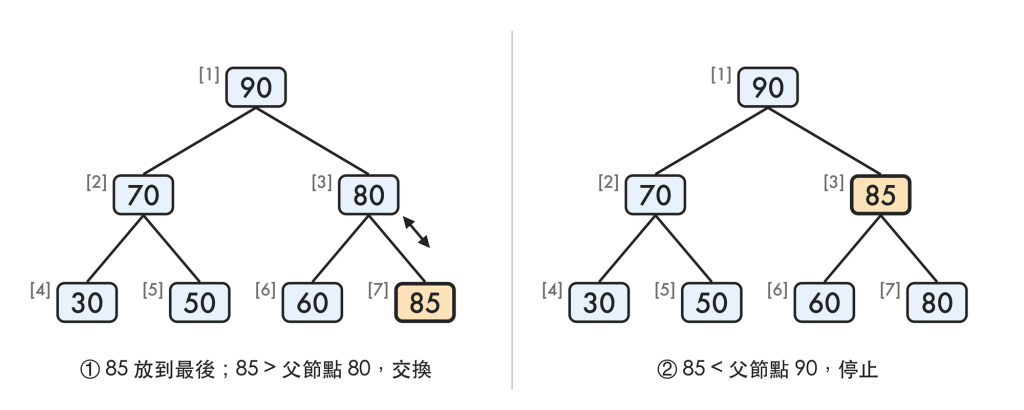
插入後的陣列是 90、70、85、30、50、60、80。它並沒有由大到小排好:70 排在 85 前面,80 排在最後;但每個父節點仍然不小於子節點,所以仍是合格的最大累堆。累堆不追求整個排好序,只維持這種父子之間的局部順序,保證最大值在樹根就夠了,因此插入時只需要沿著一條路徑調整。
最大累堆的刪除,指的是取出樹根,也就是目前的最大值。
步驟 3 一定要和較大的子節點交換。如果和較小的那個交換,它被換上去成為父節點後,另一個較大的子節點就會在它底下,又違反「父節點不小於子節點」的規定。例如 60 若和 70 交換,70 成為樹根,80 卻變成 70 的子節點。
以原本的累堆為例:取出樹根 90 後,最後一個節點 60(索引 6)補到樹根。60 的子節點是 70 和 80,較大的是 80,60 比 80 小,兩者交換;60 移到索引 3 後已經沒有子節點,停止。
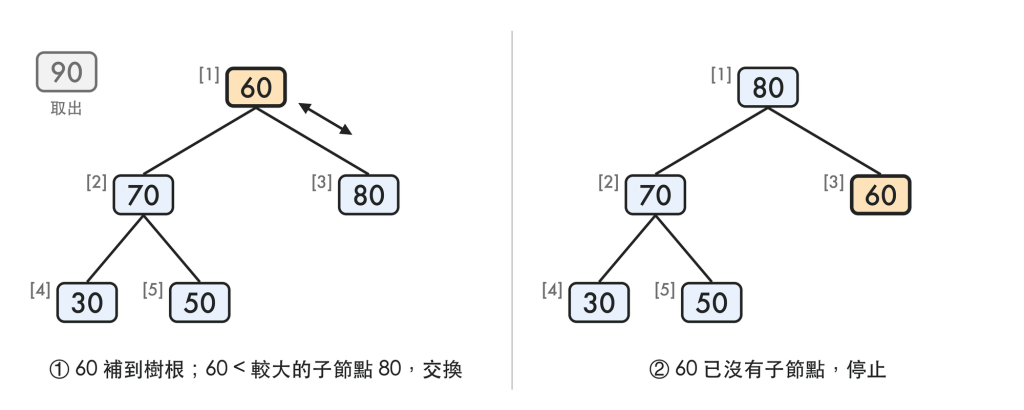
刪除後的陣列是 80、70、60、30、50,新的樹根 80 正好是剩下資料中的最大值。
設 n 是累堆的節點數。插入時新資料只會沿著一條路徑往上走,刪除時補上的節點只會沿著一條路徑往下走,每一步只做固定次數的比較與至多一次交換,最多走樹高那麼多步。完整二元樹的高度大約是 log₂ n,所以兩個操作的時間都是 O(log n)。調整過程只需要幾個暫存變數,額外空間是 O(1)。
累堆是一種特殊的完整二元樹:形狀上必須是完整二元樹,數值上每個父節點都不小於(最大累堆)或不大於(最小累堆)它的子節點,所以最大或最小值永遠在樹根。完整二元樹可以直接存進陣列,不需要指標,用 2i、2i + 1、i / 2 就能找到子節點與父節點。累堆最常見的用途是實作優先權佇列:插入時把資料放到最後再往上調整,刪除時取走樹根、把最後一個節點補上再往下調整,兩者都只沿著一條路徑移動,時間都是 O(log n)。
今日重點:
下一篇會認識二元搜尋樹:另一種對節點大小有規定的二元樹,左子樹比較小、右子樹比較大,適合用來快速搜尋資料。


 iThome鐵人賽
 看影片追技術