
想像一個猜數字遊戲:對方心裡想了 1 到 100 之間的整數,每猜一次,只會回答「太大」或「太小」。聰明的猜法是先猜 50:如果對方說「太大」,代表答案在 1 到 49 之間,50 到 100 就全部不用考慮了,下一次再猜剩下範圍的中間。每猜一次,就能排除一大片可能。
Day 2 把這種「每次縮小一部分問題」的做法列為 O(log n) 的例子,Day 5 的線性搜尋則是一筆一筆從頭找,最壞要比較 n 次。Day 19 的累堆也做不到猜數字這件事:它保證最大值在樹根,但只規定父子之間的大小,找任意一筆資料時沒辦法一次排除一半,最壞要把每個節點都看過,是 O(n)。
如果資料會不斷新增,又經常要找其中某一筆,有沒有一種結構能像猜數字一樣,每比較一次就排除一大片?今天的主角**二元搜尋樹(binary search tree, BST)**就是為此設計的:在二元樹上加一條「左小右大」的規定,讓搜尋、插入、刪除都只需要沿著樹由上往下走一條路。
這裡的 n 代表資料筆數。先看看陣列和二元搜尋樹在搜尋、插入時各需要多少時間:
| 結構 | 搜尋 | 插入 |
|---|---|---|
| 未排序的陣列 | O(n):從頭逐筆比較 | O(1):放在尾端(容量足夠時) |
| 排好序的陣列 | O(log n):二分搜尋 | O(n):要找位置並搬移資料 |
| 二元搜尋樹 | 平均 O(log n),最差 O(n) | 平均 O(log n),最差 O(n) |
**二分搜尋(binary search)**是在排好序的陣列中,每次拿中間那筆資料比較,只保留可能含有目標的那一半,所以只要 O(log n)。不過陣列排好序之後,Day 5 學過的插入就得搬移後面所有資料;不排序的話插入很快,搜尋又變慢。鏈結串列插入容易,但不能直接跳到中間,搜尋還是 O(n)。
二元搜尋樹想兩邊都顧到:搜尋時一路縮小範圍,插入時不必搬移資料,只要找到位置,再把新節點接上去。表格裡為什麼分成「平均」和「最差」,後面會用樹的形狀說明。
二元搜尋樹是一棵二元樹(也可以是空樹),而且每個節點都要滿足:
**鍵值(key)**是用來比較大小的欄位,例如學號或商品編號;節點可以另外帶其他資料,我們的圖只畫出鍵值。
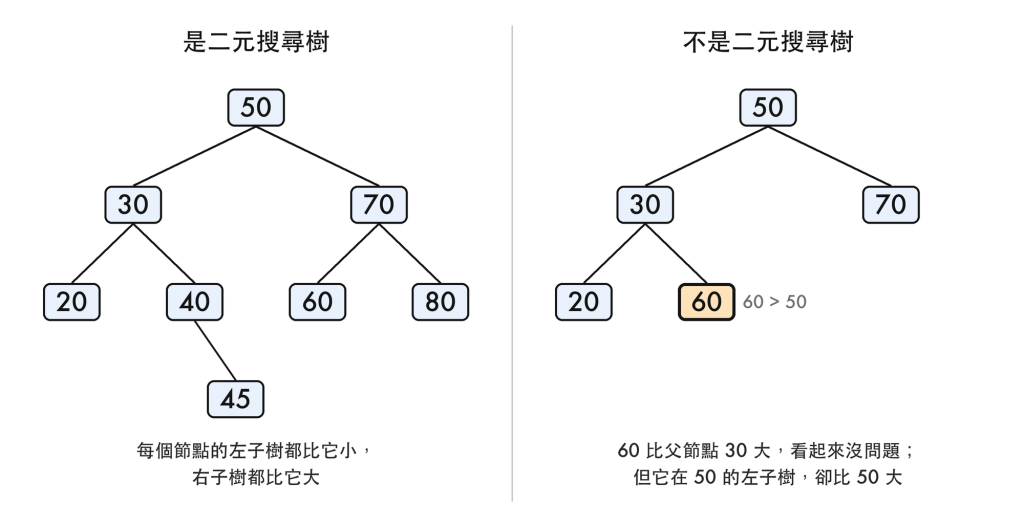
左邊那棵樹就是一棵二元搜尋樹,後面的搜尋、插入、刪除都用它示範。這棵樹是依序插入 50、30、70、20、40、60、80、45 得到的,插入的做法後面會說明。
右邊那棵樹要特別留意:60 比它的父節點 30 大,放在 30 的右邊看起來沒問題,但 60 位在 50 的左子樹裡,就必須比 50 小。規定談的是整棵子樹,不是只比對直接相連的父子,這是初學時最容易漏掉的地方。
Day 15 學過中序走訪:先走訪左子樹,再處理目前節點,最後走訪右子樹。套用在二元搜尋樹上,左子樹的鍵值都比目前節點小,會先輸出;右子樹的鍵值都比目前節點大,會後輸出。每一棵子樹都是這個道理,所以二元搜尋樹的中序走訪結果一定由小到大排列。
左邊那棵樹的中序走訪結果是 20 30 40 45 50 60 70 80,正好是排好序的。
這個性質也是檢查的好工具。右邊那棵不合格的樹,中序走訪結果是 20 30 60 50 70,60 排在 50 前面卻比 50 大,馬上就能看出它不是二元搜尋樹。
Day 19 的累堆和今天的二元搜尋樹都在二元樹上加了大小規定,但目的不一樣:
| 項目 | 累堆(最大累堆) | 二元搜尋樹 |
|---|---|---|
| 形狀 | 必須是完整二元樹 | 沒有形狀規定 |
| 大小規定 | 父節點不小於子節點 | 左子樹 < 節點 < 右子樹 |
| 兄弟之間 | 沒有大小關係 | 左子節點小於右子節點 |
| 最大值的位置 | 樹根 | 一路往右走到底 |
| 找任意一筆資料 | 最壞 O(n) | 沿一條路徑往下走 |
| 常見表示法 | 陣列 | 鏈結(形狀不固定,用陣列可能浪費空間) |
累堆擅長「隨時拿出最大或最小的那一筆」,二元搜尋樹擅長「依鍵值搜尋,而且能依序輸出」。
要在二元搜尋樹中找鍵值 x:
這樣做的道理是:x 小於目前節點時,右子樹的鍵值都比目前節點大,更不可能等於 x,所以整棵右子樹可以直接放棄,只需要往左找;x 大於目前節點時同理。每比較一次,就丟掉一整棵子樹。
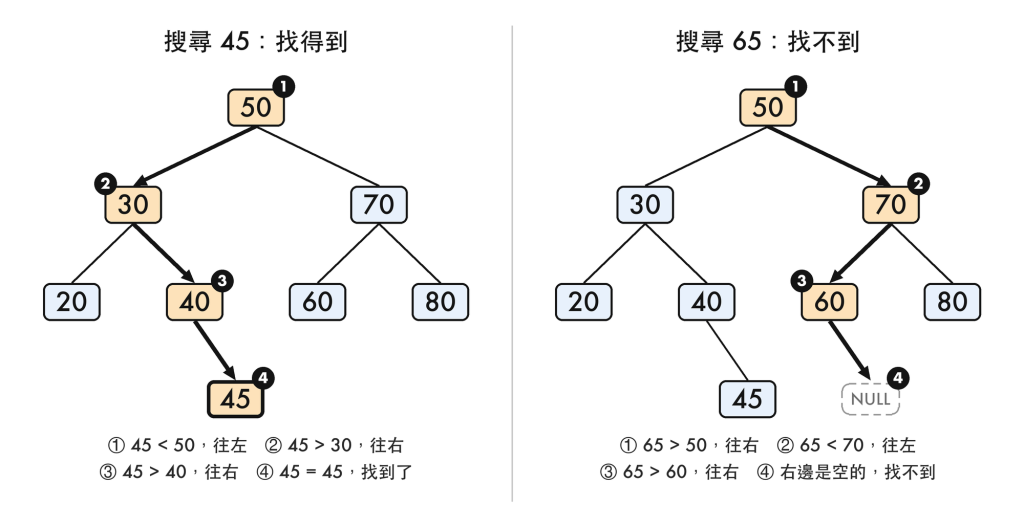
順帶一提,找最小值和最大值也很簡單:最小值在一路往左走到底的節點,最大值在一路往右走到底的節點。範例樹的最小值是 50 → 30 → 20 的 20,最大值是 50 → 70 → 80 的 80。
插入一個新鍵值 x,就是先照搜尋的方式往下走;走到空位時,把新節點接在那裡:
為什麼這樣接是對的?上面搜尋 65 時,路徑走到 60 的右邊落空,這個位置正是「如果 65 在樹中,它應該出現的地方」,因為路上每一次往左或往右的判斷,都符合大小規定。把新節點接在那裡,規定就不會被破壞。
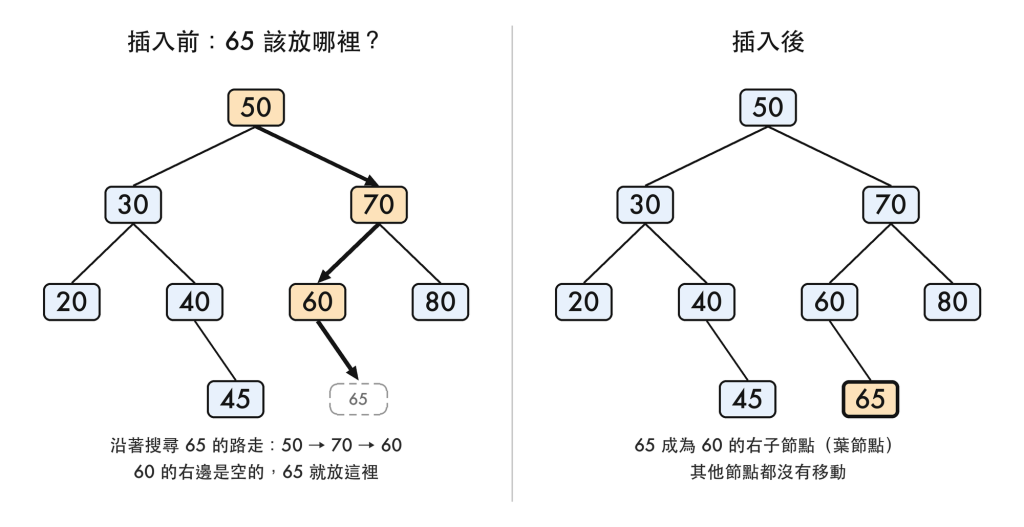
插入有兩個特點:新節點一定成為葉節點,而且原本的節點完全不用搬動,只需要修改一個指標。這和排好序的陣列插入時要搬移一大批資料很不一樣。
建立二元搜尋樹,也就是把資料一筆一筆依序插入。前面的範例樹就是照 50、30、70、20、40、60、80、45 的順序插入建成的。
刪除比插入麻煩,因為被拿掉的節點底下可能還有子樹,拿掉之後仍要維持大小規定。做法是先用搜尋找到要刪除的節點(找不到就什麼都不做),再依它有幾個子節點分三種情況處理。
葉節點沒有子節點,直接把父節點指向它的指標設成 NULL。例如刪除 20,只要把 30 的 left 設成 NULL。如果被刪除的是樹中唯一的節點(也就是樹根),刪除後就變成空樹。
被刪節點只有一個子節點時,把這個子節點(連同它底下的整棵子樹)接到被刪節點原本的位置。例如刪除只有右子節點 45 的 40,就把 30 的 right 改指向 45。
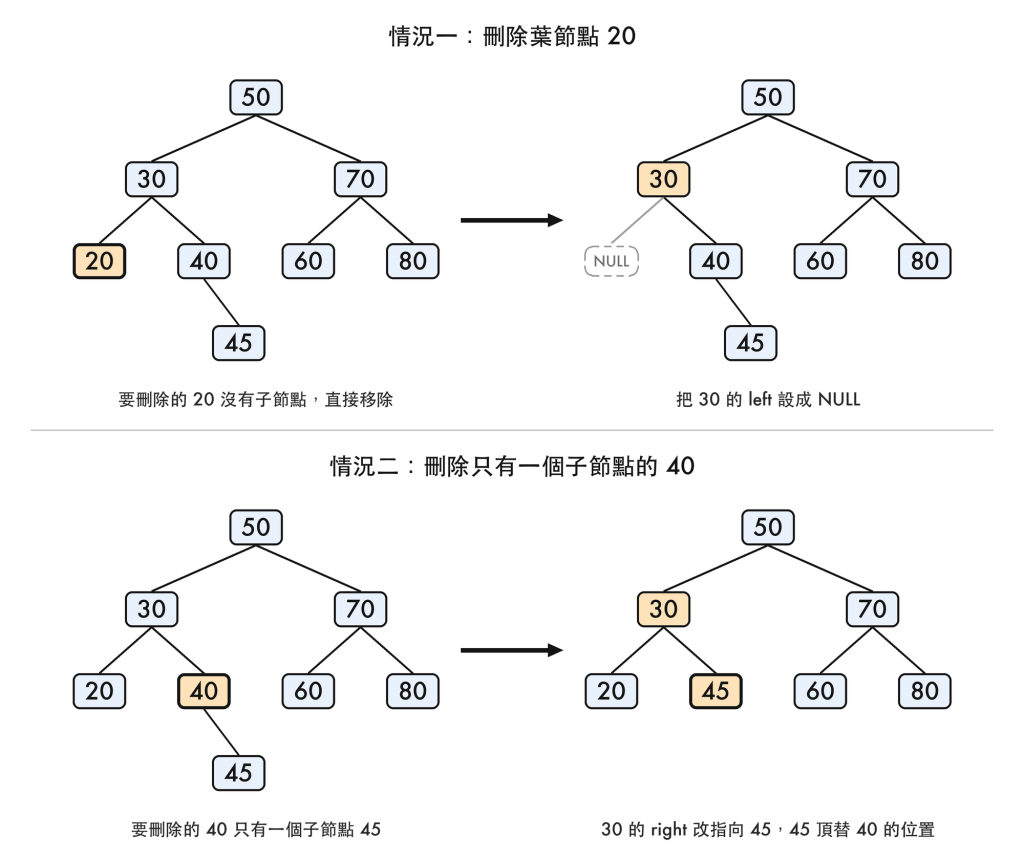
為什麼可以直接接?45 原本就在 40 的子樹裡,所以它比 30 大、比 50 小。把它接到 40 原來的位置,它仍然比 30 大、比 50 小,沒有違反上面節點的大小規定。如果被刪的是樹根,子節點就成為新的樹根;如果只有左子節點,也是一樣,把左子節點接到原來的位置就好。
被刪節點有兩個子節點時就不能直接拿掉,因為兩棵子樹都要保留,但原本的位置只能放一個節點。解決的辦法是:找另一個節點的值來頂替,然後把那個節點刪掉。
要找誰來頂替呢?可以選這兩個節點:
也就是說,把鍵值由小到大排列後,可以選原本鍵值的前一個或後一個來頂替。把選到的值填進來,再刪掉原本存放這個值的節點,剩下的左子樹就都比新值小,右子樹就都比新值大。兩種做法都正確,本文用前驅示範。
步驟如下,以刪除樹根 50 為例:
如果節點還存有姓名、商品資訊等資料,第 2 步也要把這些資料一起複製。例如鍵值是學號,就要連同對應的姓名一起換過來,才不會把學號和姓名配錯。
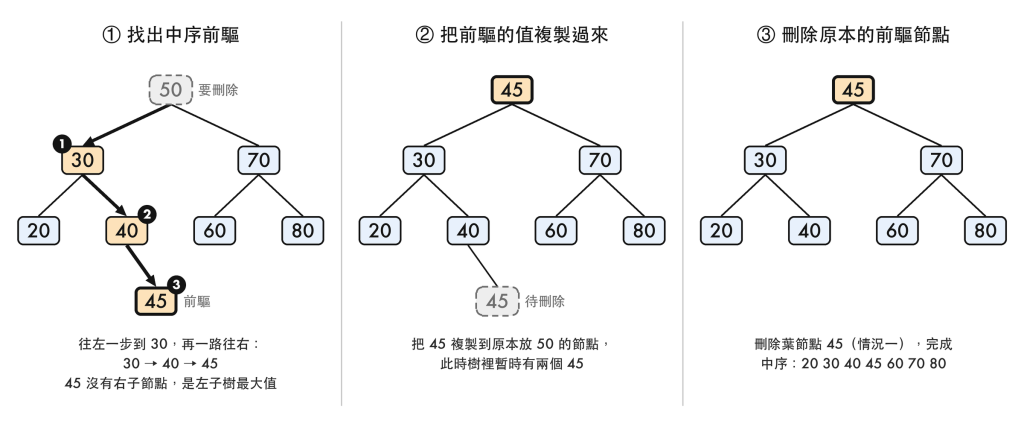
為什麼這樣做不會破壞規定?前驅 45 是左子樹的最大值,左子樹其他鍵值都比它小;它本來就在左子樹裡,所以又比右子樹所有鍵值小。把它放到樹根,左小右大的規定依然成立。
另外,前驅一定沒有右子節點,否則那個右子節點會更大,前驅就不是最大值了。所以第 3 步要刪的節點,只可能是葉節點或只有左子節點,剛好回到情況一或情況二,不會再遇到兩個子節點的情形。
這裡有個容易犯的錯:兩個子節點時,不能隨便拿其中一個子節點頂上去。例如刪除 50 時直接讓 30 當樹根,但 30 本來就有 20 和 40 兩個子節點,另一邊的 70 整棵子樹就沒有地方可以接了。
三種情況做完,樹仍然是二元搜尋樹。可以用中序走訪驗證:刪除 50 之後的結果是 20 30 40 45 60 70 80,依然由小到大。
這裡的 n 代表樹中的節點數,h 代表樹高。沿用 Day 13 的計算方式:根節點在第 1 層,最深的節點在第幾層,樹高就是多少。
搜尋從樹根出發,每到一個節點,只需要比較鍵值、決定往哪邊走。最多看過 h 個節點,所以時間是 O(h)。插入也是先往下找空位,再接上新節點,時間同樣是 O(h)。刪除時先找到要刪的節點;如果它有兩個子節點,再繼續往下找前驅。整個過程都沿著同一條路往下走,不需要把整棵樹找一遍,所以也是 O(h)。
接下來的問題是:h 和 n 是什麼關係?這要看樹長成什麼形狀,而形狀取決於插入的順序。下圖用同樣 7 個鍵值,只改變插入順序:
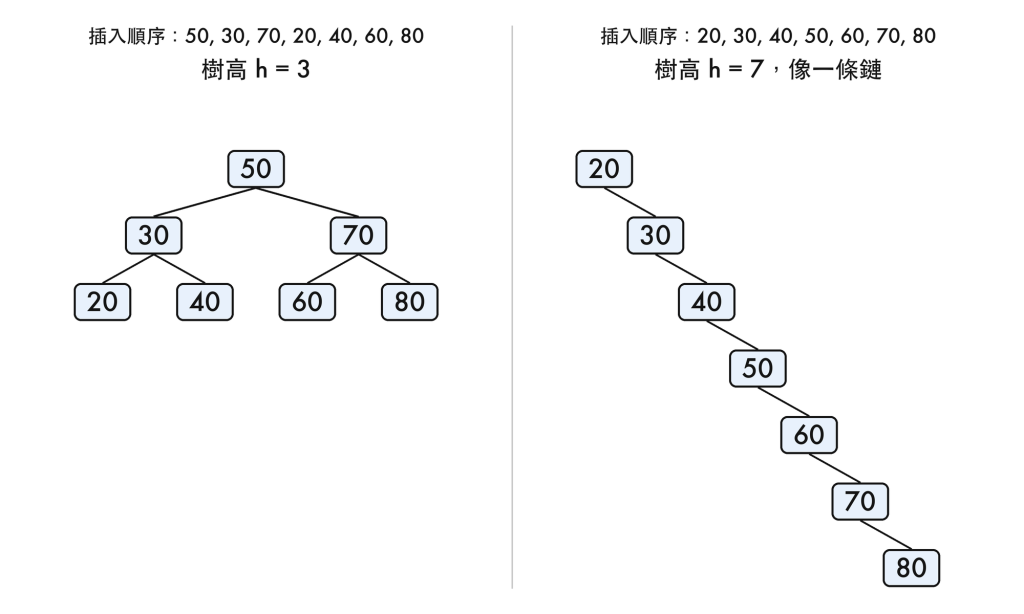
左邊每一層都盡量填滿,搜尋任何一個值最多比較 3 次。右邊是資料已經排好序再依序插入的結果:每個新鍵值都比之前所有鍵值大,只能一路接在最右邊,變成 Day 14 學過的右斜樹,形狀就像鏈結串列,要找 80 得從 20 一路比到 80,共 7 次。
| 樹的形狀 | 樹高 h | 搜尋、插入、刪除 |
|---|---|---|
| 接近每層填滿的樹 | 約 log₂ n | O(log n) |
| 傾斜樹(像一條鏈) | n | O(n) |
樹最矮的時候,h 大約是 log₂ n。這和 Day 14 的公式有關:高度 h 的二元樹最多放得下 2^h − 1 個節點,所以要放下 n 個節點,必須滿足 2^h − 1 ≥ n,也就是 h 至少約為 log₂ n。相反地,如果每一層只有一個節點,n 個節點就要排成 n 層,h 就等於 n。
那前面表格的「平均 O(log n)」是怎麼來的?假設先把資料打亂,而且每種插入順序出現的機會都一樣。把這些順序得到的樹高取平均,結果是 O(log n),這個平均樹高在數學上叫做「樹高的期望值」。但這不保證每一棵樹都矮:如果照由小到大的順序插入,就會長成一條鏈,操作時間變成 O(n)。
想避免樹長成一條鏈,可以使用平衡二元搜尋樹:插入、刪除後會調整形狀,避免樹高變得太高。經典的 AVL 樹和紅黑樹就是這類結構,後面有機會可以聊到。
樹本身要存放 n 個節點,占用的空間是 O(n)。另外,搜尋與插入如果用迴圈寫,只需要幾個指標變數,樹變大時也不需要增加變數的數量,所以額外空間是 O(1)。如果用遞迴寫,就像 Day 15 的走訪,每往下一層,都要記住上一層尚未完成的函式呼叫。最多同時記住 h 層,所以額外空間是 O(h)。
二元搜尋樹靠「左小右大」決定搜尋方向,所以不用把每個節點都找一遍。插入時,把新節點接到搜尋找到的空位;刪除時,先看它有幾個子節點,再決定直接移除、由子節點頂替,或用前驅的值替補。這些操作最多走樹高那麼多層,因此樹的形狀很重要:樹矮時找得快,長成一條鏈時,就會和鏈結串列一樣,需要一路往下找。
今日重點:
我們現在學會了樹,樹只能一路往下長,像家譜。下一篇將進入的圖形結構(graph),則像社群網路,每個人都可以跟任何人連在一起。


 iThome鐵人賽
 看影片追技術