
上一篇我們調整了 Learning Rate,發現每次更新參數時「走多大步」會影響模型的訓練結果。
但還有另一個問題:
知道要走多大步之後,模型到底要怎麼更新 Weight?
這就和今天要介紹的 Optimizer(最佳化器) 有關。
模型訓練時會不斷重複:
模型預測
↓
計算 Loss
↓
計算 Gradient
↓
Optimizer 更新 Weight
↓
再次預測
其中 Gradient(梯度) 可以幫助模型判斷參數應該往哪個方向調整,而 Optimizer 則負責根據這些資訊實際更新模型參數。
簡單來說:
Learning Rate 決定「一步走多大」,Optimizer 則決定「參數要怎麼走」!
模型的目標之一,就是找到能讓 Loss 降低的參數,可以想像我們站在山坡上:
目前位置
   ●
    ↘
      ↘
        ●  Loss 較低
Gradient 可以提供目前位置的變化方向,而我們希望往能降低 Loss 的方向更新參數。
這種利用梯度逐步降低 Loss 的概念,就是 Gradient Descent(梯度下降)。
SGD(Stochastic Gradient Descent) 是常見的 Optimizer。
在使用 Mini-batch 訓練時,它會根據每個 Batch 計算出的 Gradient 更新模型參數。
optimizer = tf.keras.optimizers.SGD(learning_rate=0.001)
SGD 的更新方式相對直接,因此很適合拿來理解最基本的梯度下降概念。
前面的 CNN 我們一直使用:
optimizer="adam"
Adam 也是一種 Optimizer。
它會根據訓練過程中的梯度資訊,自動調整不同參數的更新方式,因此在深度學習中非常常見。
optimizer = tf.keras.optimizers.Adam(learning_rate=0.001)
不過 Adam 很常用,不代表它在所有模型中一定最好,所以今天直接來實驗看看。
這次我們固定其他條件,只改變 Adam、vs.、SGD,這樣比較容易觀察 Optimizer 本身造成的差異。
讓 create_model() 可以接收不同的 Optimizer:
import tensorflow as tf

def create_model(optimizer):

    model = tf.keras.Sequential([

        tf.keras.layers.Input(shape=(64, 64, 3)),

        tf.keras.layers.Conv2D(32,kernel_size=(3, 3),activation="relu",padding="same"),
        tf.keras.layers.MaxPooling2D((2, 2)),
        tf.keras.layers.Conv2D(64,kernel_size=(3, 3),activation="relu",padding="same"),
        tf.keras.layers.MaxPooling2D((2, 2)),
        tf.keras.layers.Flatten(),
        tf.keras.layers.Dense(128,activation="relu"),
        tf.keras.layers.Dense(7,activation="softmax")
    ])

    model.compile(optimizer=optimizer,loss="sparse_categorical_crossentropy",metrics=["accuracy"])

    return model
adam = tf.keras.optimizers.Adam(learning_rate=0.001)

model_adam = create_model(adam)

early_stopping_adam = tf.keras.callbacks.EarlyStopping(monitor="val_loss",patience=3,restore_best_weights=True)

history_adam = model_adam.fit(X_train,y_train,validation_data=(X_val, y_val),epochs=50,batch_size=32,callbacks=[early_stopping_adam])
sgd = tf.keras.optimizers.SGD(learning_rate=0.001)

model_sgd = create_model(sgd)

early_stopping_sgd = tf.keras.callbacks.EarlyStopping(monitor="val_loss",patience=3,restore_best_weights=True)

history_sgd = model_sgd.fit(X_train,y_train,validation_data=(X_val, y_val),epochs=50,batch_size=32,callbacks=[early_stopping_sgd])
從 Validation Loss 可以看到,Adam 的 Loss 在前幾個 Epoch 就快速下降,最低約來到 0.74;SGD 雖然也有逐漸下降,但速度明顯比較慢,到後期仍接近 1.0。
這次兩種 Optimizer 的學習速度有很明顯的差異,Adam Loss 下降較快,較早停止訓練,而 SGD的 Loss 下降較慢,經過較多 Epoch 後仍持續緩慢下降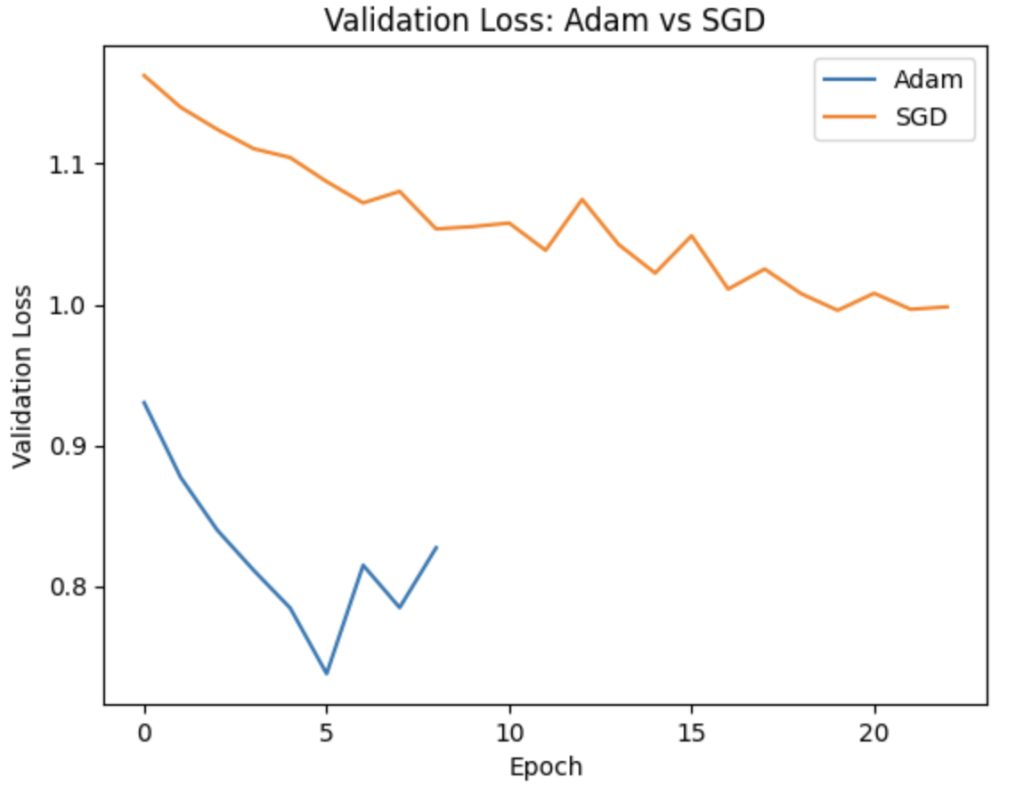
而在這次實驗中,Adam 的 Test Accuracy 約為 74.30%,高於 SGD 的 66.93%,Test Loss 也比較低。
因此可以看到,即使使用相同的 CNN、Learning Rate 和 Batch Size,更換 Optimizer 也會影響模型的學習速度與最後結果。
不過這次只能說 Adam 在目前的實驗設定下表現較好,並不代表 Adam 在所有模型與資料集上都一定比 SGD 好。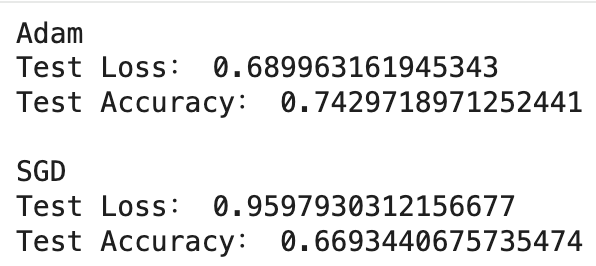
今天認識了 Optimizer 在模型訓練中的角色,而 Learning Rate 和 Optimizer 雖然都會影響參數更新,但負責的事情並不完全相同。Learning Rate 控制更新的步伐大小,而 Optimizer 則決定如何利用 Gradient 更新參數
這次我們實際比較 Adam 與 SGD,接下來就可以從 Validation Loss 和 Test Accuracy 看看,同一個 CNN 換掉 Optimizer 後,訓練結果會產生什麼變化。


 iThome鐵人賽
 看影片追技術