
上一篇我們認識了 Loss,也知道模型在訓練過程中,會透過 Loss 判斷預測結果和正確答案之間的差距,再不斷調整 Weight 和 Bias,不過,在前面訓練 CNN Baseline Model 時,我們其實已經看到一個很有趣的現象
Training Accuracy 一直上升,但 Validation Accuracy 到後面卻沒有跟著上升
為什麼模型明明在 Training Data 上越來越厲害,面對 Validation Data 時卻沒有一起進步?
這就和今天要介紹的 Generalization、Overfitting 與 Underfitting 有關
我們訓練模型的目的,並不是希望它只會回答看過的圖片,真正希望的是模型學到可以應用在新資料上的規律
假設模型在 Training Data 有 Training Accuracy = 99%,看起來好像非常厲害,但到了沒參與訓練的資料卻只有 Validation Accuracy = 60%,那麼即使 Training Accuracy 很高,也不能代表模型真的學得很好
因為真正重要的是,模型面對沒有看過的新圖片時,能不能仍然做出合理的預測,這種能力就稱為 Generalization(泛化能力)
Overfitting(過擬合)可以簡單理解成模型太熟悉 Training Data,甚至學到了只適用於訓練資料的細節,但無法很好地應用到新的資料
例如考試前,如果不是理解題目的觀念,而是直接把練習題答案全部背起來,在做練習題時幾乎全部答對,而在做新題目時則因為換個方式就不會了,這就很像 Overfitting
模型可能會出現 Training Accuracy 很高,但是 Validation Accuracy 明顯較低的狀況,或者從 Loss 觀察,當 Training Loss 持續下降,而 Validation Loss 下降一段時間後開始上升,這些都可能是 Overfitting 的訊號
回到 Day15 的 CNN Baseline Model,我們實際跑出的 Accuracy 曲線中: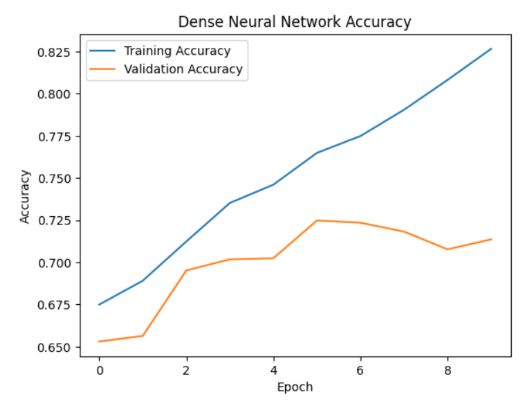
Training Accuracy 隨 Epoch 持續上升,最後約 82.7%,而 Validation Accuracy 前期上升 約 72.5% 後開始停滯、波動,最後大約落在 71%
這表示模型持續提升在 Training Data 上的表現,但這些進步沒有完全反映在 Validation Data 上,因此,我們的 Baseline CNN 已經出現值得注意的泛化落差,也有過擬合的跡象,這也告訴我們 Epoch 越多,不一定代表模型越好
Overfitting 是「學得太貼近 Training Data」,另一個相反的問題則是,Underfitting(欠擬合),我們可以把它理解成模型連 Training Data 中的重要規律都還沒有學好
例如考試前只讀了課本第一頁,所以練習題不太會,在做新題目時也不太會
通常可能看到 Training Accuracy 低、Validation Accuracy 也低,或 Training Loss 高、Validation Loss 也高,代表模型目前的學習能力或訓練程度不足
可以整理成:
| 狀況 | Training 表現 | Validation 表現 | 說明 |
|---|---|---|---|
| Underfitting | 差 | 差 | 模型連訓練資料都還沒學好 |
| 適當學習 | 好 | 好 | 能將學到的規律應用到新資料 |
| Overfitting | 很好 | 明顯較差 | 太貼近 Training Data,泛化能力下降 |
我們真正想要的不是 Training Accuracy = 100%,而是希望 Training 和 Validation 表現良好,並具有較好的 Generalization
Overfitting 並不是只有一個原因
1. 模型太複雜:模型的參數很多,相對於資料量可能有能力記住大量訓練資料中的細節
2. 訓練太久:Epoch 持續增加後,模型可能繼續改善 Training Data,但 Validation Data 已經不再進步
訓練資料不足或變化不夠:模型看到的情況有限,就比較難學到可以泛化到不同圖片的規律
所以之後我們會慢慢接觸不同的方法,例如 Early Stopping、Data Augmentation、Dropout,它們都可以從不同角度幫助我們處理模型的泛化問題
假設我們訓練 20 個 Epoch,可能在第 8 個 Epoch 時,Validation Loss 最低
但我們還是繼續往後訓練,結果可能變成 Training Loss 繼續下降、Validation Loss 反而開始上升,那我們是不是可以在 Validation Loss 不再改善時,就透過某些方法讓它不要繼續訓練了呢?
答案就是後面會介紹的:Early Stopping
它可以在模型訓練過程中監控 Validation Loss,當一段時間沒有改善時停止訓練
到這裡會發現,我們前面一直觀察 Training Accuracy,但它其實不是最終目的,因為真正使用模型時,遇到的通常不是 Training Data 裡那些已經看過的圖片,而是新的資料
因此我們希望模型做到的是 從 Training Data 學習,找到具有代表性的規律,遇到沒看過的資料時,仍然可以合理預測
所以之後我們調整模型時,也不能只問 Training Accuracy 有沒有變高?而應該一起觀察 Validation 表現有沒有改善?Training 和 Validation 之間的差距有沒有縮小?


 iThome鐵人賽
 看影片追技術