
🔌 接得下去,但不能只交一段摘要給新模型。Harness 要把確認過的結果直接交過去,例如哪些檔案改好了、diff 是什麼;舊模型的工具呼叫和供應商專屬的狀態搬不過去,就用新模型自己的 prompt 和工具開新的一輪。
昨天在 Day 18|Timeout 之後,可以直接重試嗎?,我們從「做哪一件事」算出 Operation ID,重送時下游認得出是同一件事;結果未知就先查,不要再送。今天接著看:任務做到一半換了模型,已經確認的事還接得上嗎?
快速回顧一下:Day 11 看過摘要會寫錯、寫漏。
假設團隊自己寫的 Coding Agent 接了兩家的模型,照 Cursor 公開的做法,每顆模型配自己的編輯工具:平常用模型 A(Claude),編輯工具是字串替換,指定要換掉的舊文字和新文字;A 回 overloaded(服務滿載、暫時不收請求)時,自動改用模型 B(OpenAI 的模型),B 的編輯工具是 OpenAI 模型習慣的 patch 格式,一次描述一段修改前後的差異。
這次的任務借用 Day 17 實驗過的開源專案 Open WebUI(聊天介面,後端是 Python):後端送到 OpenAI 的請求都要帶 X-Client-Request-Id header,也就是請求自己帶的編號,拿不到回應時可以請 OpenAI 用它查。聊天走的共用函式已經改好,剩下三個地方各自組 header:文件搜尋、圖片、語音,各在一個檔案。
A 用字串替換改好文件搜尋和圖片,每次編輯都回成功,結果在 Harness 手上。要改語音那個檔案時,呼叫 A 回了 overloaded,Harness 換成 B。A 的對話裡都是 B 沒有的字串替換呼叫;換了模型,供應商替前面對話存的 prompt cache(讀過的對話先存起來,下一輪就不用重讀)也用不上:cache 只認同一家、同一顆模型,換過去的第一輪要把整段對話從頭讀一遍,又慢又貴。Harness 就把對話壓成一段摘要交給 B,Cursor 說他們也試過這樣,讓這一輪少花一點。摘要寫了任務、讀過哪三個檔案、打算怎麼改,沒寫哪兩個已經改完。
B 照摘要從頭改三個檔案,送出 patch。前兩個檔案要換掉的舊內容已經被 A 改掉,patch 都套不上;B 只好重讀三個檔案、自己比對哪些改過,多花好幾輪才接回第三個。這次還算好,patch 套不上會報錯;Cursor 自己也寫了,任務做得深的時候,摘要可能丟掉重要細節。
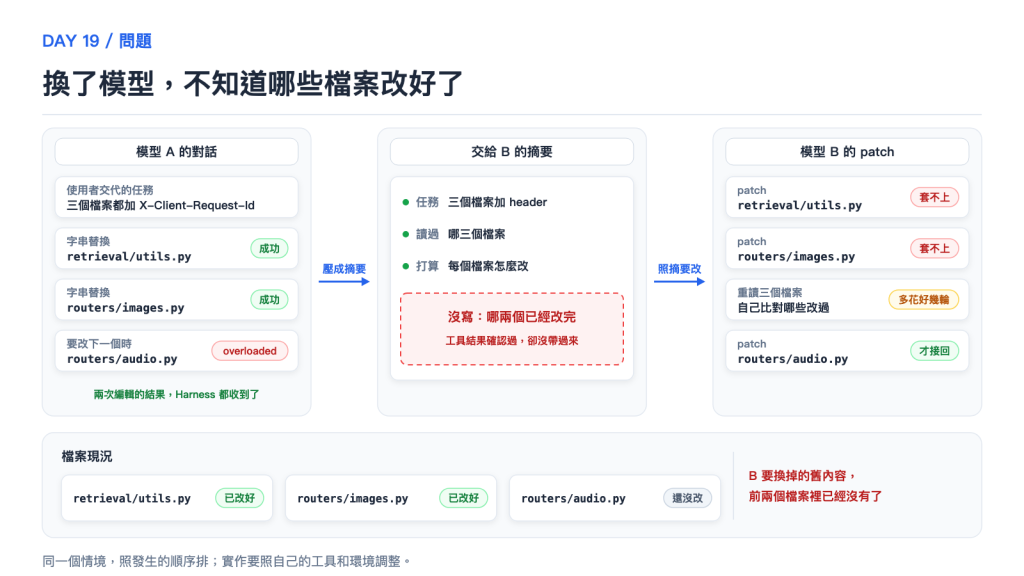
圖:左邊是 A 的對話,兩次字串替換都成功,要改語音那個檔案時回 overloaded → 中間是交給 B 的摘要,有任務、讀過哪三個檔案、打算怎麼改,沒寫哪兩個已經改完 → 右邊是 B 照摘要送的 patch,前兩個套不上,重讀比對多花好幾輪才接回 → 下方是檔案現況:前兩個已改好,B 要換掉的舊內容已經不在檔案裡。這是示意,實作要照自己的工具和環境調整。
哪兩個檔案改好了,Harness 手上有結果,卻只留在 A 的對話裡,摘要沒帶過去。下面先看 A 的對話為什麼不能直接交給 B、現有產品怎麼換模型,再把這次交接改成交確認過的結果走一遍,最後看什麼時候不能直接接。
A 的對話裡除了一問一答的文字,還有 A 發出的工具呼叫:叫哪支工具、帶什麼參數,用的是 A 那套字串替換工具的名稱和格式;每個工具結果還靠一個呼叫編號(call ID)接回原本的呼叫。B 的工具集裡沒有字串替換這支,這些呼叫原封不動交過去,B 也接不下去。
有些內容連看都看不懂。OpenAI 的 Codex Agent Loop 文章說明,它的 Responses API 把對話存成一個個不同類型的 Item,工具結果靠 call_id 配對;壓縮對話(Compaction)時還可能產生含加密內容的 Item。這種 Harness 看不懂、只能原樣交回同一家 API 的加密內容,不能假設它翻得成另一家的等價內容。
丟掉這些狀態也有代價。Cursor 另一篇談 Codex 模型的文章自報,在他們的 Cursor Bench 和 GPT-5-Codex 設定裡,把 Reasoning trace(模型推理過程的紀錄)拿掉,效能下降 30%。這是那次評測的相對變化,不代表每顆模型都會掉這麼多。
還有一種丟法比較難發現:adapter(把各家 API 包成同一個呼叫介面的那層程式)把所有內容壓成 {role, content} 交給 B,畫面上看起來還是一段完整對話,Item 類型、順序和 call_id 卻已經不見了。B 照樣能回答,只證明 API 收得下這些訊息,不代表任務接上了:沒有解析錯誤,也沒有任何提示,B 只是在缺資料的情況下繼續猜。
現成的做法分兩種:同一份請求照原樣改送給下一個模型,或換上新模型自己的 prompt 和工具再接。
| 產品 | 做法 | 換過去之後 |
|---|---|---|
| Claude Code 的 fallback model | 照原樣改送 | 主模型 overloaded 時改送名單上的下一個模型,只維持這一輪;換過去的還是 Claude,工具和對話照舊,碰不到開頭那種交接,但那一輪一樣沒有 cache 可用 |
OpenRouter 的 models 參數 |
照原樣改送,可以跨家 | 碰到 rate limit、停機就改送下一個;工具定義原樣過去,不會換成下一顆模型習慣的格式,Harness 要看回應的 model 欄位才知道換過 |
| Cursor | 換上新模型的 prompt 和工具 | 再加一段指示,告訴新模型它是接手的、別呼叫自己沒有的工具;A 的歷史怎麼交過去,要另外決定 |
開頭的情境用的是 Cursor 這種:換上 B 的 prompt 和工具,A 的歷史改交一段摘要。問題出在交的內容,下一節把它換掉。
摘要的問題在於,「哪兩個檔案改好了」是工具結果確認過的事,卻要靠寫摘要的模型記得提。我會把這種事從對話裡拿出來,由 Harness 自己存、自己交給 B。開頭那次交接,前後並排:
改前:交一段摘要
  A 改好文件搜尋、圖片 → 改語音時 overloaded
  Harness 把對話壓成摘要交給 B(沒寫哪兩個改好了)
  B 用 patch 從頭改三個檔案 → 前兩個套不上 → 重讀比對,多花好幾輪

改後:交確認過的結果
  A 改好文件搜尋、圖片 → 改語音時 overloaded
  Harness 從工具結果整理:兩個檔案的 diff 和雜湊、語音還沒動
  用 B 自己的 prompt 和 patch 工具開新的一輪,附上這些結果
  B 看 diff,只替語音產生 patch
改後的第二步,Harness 從 A 的工具結果整理出:retrieval/utils.py(文件搜尋)和 routers/images.py(圖片)已經改好,附上 diff 和改完之後的檔案雜湊,用來確認檔案之後沒再被動過;routers/audio.py(語音)還沒動。這些存在 Harness 自己的紀錄裡,不靠摘要轉述。A 的工具呼叫和結果是 A 那套工具的格式,不塞進 B 的訊息,也不偽裝成 B 發過的呼叫。
第三步,組 B 的新一輪:B 自己的 system prompt、patch 格式的編輯工具,加上任務、目前的 commit、兩個檔案的 diff 和還沒改的那一個。摘要可以附上,當成 A 當時怎麼想的參考,檔案現況以 diff 為準。B 讀完 diff,只替語音那個檔案產生 patch,不用先撞兩次套不上的錯誤、再重讀檔案比對。反正換了模型 cache 就沒了,交給 B 多少字,B 就要從頭讀多少字。改後只交兩個 diff 和一個檔名,跟摘要差不多短,原本壓摘要想省的錢一樣省得到。
每顆模型各自用的 prompt 和工具,至少要固定這幾樣,也記下是哪一版:
call_id、reasoning、壓縮內容這些能不能原樣送回去;實際能力要照各家 API 和版本確認。只寫 provider=openai 太粗了,模型版本、工具格式和 API 協定都可能變。這些東西改了也要重跑評測,它跟換模型一樣,可能改變工具選擇和任務路徑。cache 也會跟著沒掉。Day 8 講過,Anthropic 的 cache 是從頭開始比:先比工具定義,再比 system prompt,最後比對話,哪裡開始不一樣,從那裡往後就全部重算。所以就算是同一顆模型,換了 prompt 或工具,下一輪一樣又慢又貴。
以前連調 effort 都會讓 cache 沒掉。effort 是調模型要想多久、做多細的設定,看起來只是 API 的一個參數,其實供應商會把它寫進模型讀到的 prompt 裡,而且寫在對話前面。前面的字一變,後面整段對話就比不上了。Anthropic 同一份文件寫,改了 effort,對話那段的 cache 一定沒了,有些模型連工具定義和 system prompt 也要重算;OpenAI 的文件寫,改 reasoning.effort 可能會改到開頭那段看不到的系統指示。
最近兩家都換了做法:新的 effort 不去改前面,改成接在對話最後面。Anthropic 是在對話裡加一則只寫新 effort 的 system 訊息(Opus 5.5、Sonnet 5.5、Fable 5.1 這些新模型可以用,還在 beta);OpenAI 是在 GPT-6 以後的模型,在 input 最後加一個 configuration_update。前面的內容一個字都沒變,cache 就還在。Claude Code 從 2.1.260 開始,在 Fable 5.1 上打 /effort 也不會讓 cache 沒掉了。
換模型就沒辦法這樣接。cache 是原本那顆模型算出來的,別顆模型用不了;Claude Code 的 /model 在換模型前也會跳警告,說下一輪要整段對話重讀、沒有 cache。
除了檔案,換模型時要交給 B、至少要讓 Harness 查得到的,還有這幾類:
| 類型 | 存什麼 | 換模型時的用途 |
|---|---|---|
| 確認過的事實 | 工具或來源確認過的結果,和出處 | 讓新模型知道哪些可以直接用 |
| 產出的檔案(artifact) | 有版本的檔案、patch、報告或查詢結果 | 讓新模型回頭讀完整內容 |
| 外部操作(Operation) | Day 18 的 Operation ID、送出狀態和對帳結果 | 換模型後不重送結果未知的操作 |
| 核准(Approval) | 核准了哪個動作、哪些資源、參數範圍和期限 | 判斷換了工具之後,還在不在核准範圍內 |
代價是要決定什麼時候把模型的輸出當成確認過的事實;沒驗證過的推論,不能寫進去。
開頭那次比較單純:A 被打斷時,沒有發出去還沒回結果的工具呼叫,也沒有結果未知的外部操作。換模型前要先確認這兩件事。有工具呼叫還在等結果,B 不知道它存在,可能再發一次;有外部操作結果未知,要先照 Day 18 的做法查清楚,不能讓 B 自己重送。
另外兩件是交接本身要處理的:A 那邊有沒有只存在原供應商的狀態,像加密內容和 reasoning;有沒有重要結論還只寫在對話裡,沒存進 Harness 的紀錄。
四件都處理得了,B 的 API 和工具也接得住,才試著接下去。有一件處理不了,就不要硬接,改成明確地重新開始:
摘要可以讓新模型很快知道前面在做什麼,但會丟細節;哪些檔案改好了這種事,不要只靠它。
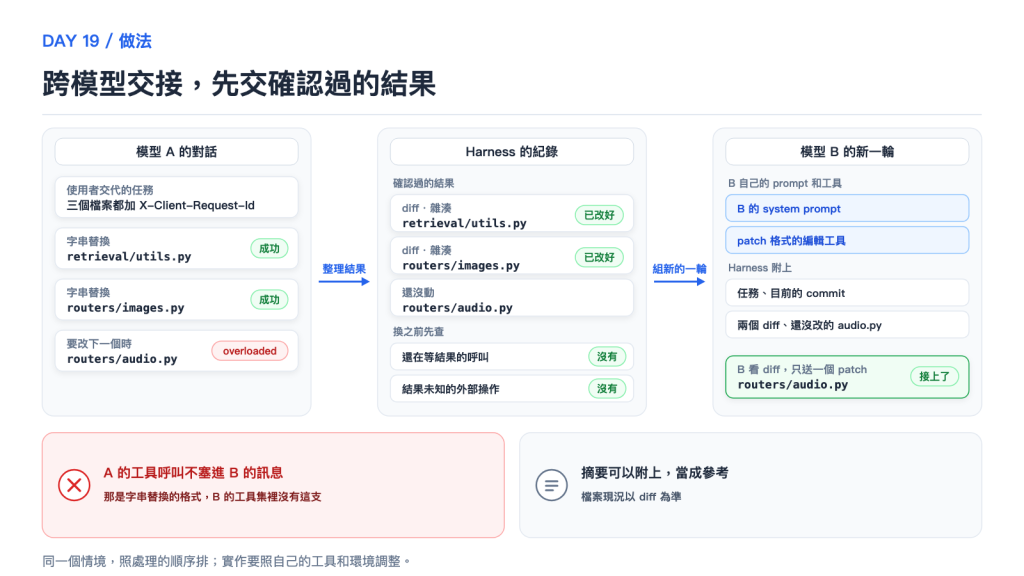
圖:左邊是 A 的對話 → 中間是 Harness 從工具結果整理的紀錄:兩個已改好的檔案附 diff 和雜湊、語音那個還沒動,也查過沒有還在等結果的呼叫和結果未知的外部操作 → 右邊是 B 的新一輪:B 自己的 prompt 和工具(system prompt、patch 工具)加上 Harness 附的任務、commit 和 diff,B 只替語音那個檔案送 patch → 下方兩條:A 的工具呼叫不塞進 B 的訊息;摘要可以附上當參考,檔案現況以 diff 為準。這是示意,實作要照自己的工具和環境調整。
這段放在 Harness 決定換模型的地方,讀的是 Harness 自己存的工具和操作紀錄。build_fresh_input 照新模型 API 的訊息格式組新的一輪,不把另一家的加密內容假裝轉成等價內容。
| 欄位 | 這個情境的值或用途 | 誰讀寫 |
|---|---|---|
| pending_operations | 還沒有結果的呼叫、結果未知的外部操作;開頭那次是空的 | 切換入口先處理 |
| confirmed_facts | 兩個已改好的檔案和 diff、檔案雜湊,還沒改的 routers/audio.py |
新模型輸入使用 |
| target_model | B 和它的 prompt、patch 格式的編輯工具,附版本 | 模型 adapter 讀取 |
def switch_model(pending_operations, confirmed_facts, target_model,
                 build_fresh_input):
    if pending_operations:
        return {"status": "reconcile_first"}
    request = build_fresh_input(confirmed_facts, target_model)
    return {"status": "ready", "request": request}
| 誰呼叫 | 什麼時候 | 結果 |
|---|---|---|
| Harness 的模型路由 | 呼叫 A 回 overloaded、決定改用 B 時 | pending_operations 是空的,用兩個檔案的 diff 和還沒改的語音檔案組 B 的第一輪 |
| Harness 的模型路由 | 換模型時還有結果未知的外部操作 | 回 reconcile_first,先照 Day 18 查原操作,查清楚再交給 B |
假設你已經做到 Day 18:每個外部操作都有自己的 Operation ID,結果未知的不會被當成新操作。先替每顆模型固定 prompt、工具格式和 API 協定版本,並把這次用的是哪一版記進 Run。用了 OpenRouter 這類跨家 fallback 的,至少把回應裡實際用的模型記下來。
沒有中途切換的需求,我會先只在新的 Run 選模型,沿用 SDK 的訊息和工具協定,不為了「將來可能換模型」先蓋一套通用的歷史轉譯平台。Cursor 也建議一段對話盡量用同一個模型。
真的需要中途交接時,再依序補上:Harness 自己存一份確認過的結果,不把供應商的對話當成唯一的紀錄;工具呼叫、結果、產出的檔案和外部操作都有固定的編號;adapter 遇到不認識的供應商 Item 先原樣存下,不要直接丟掉。加密內容能不能保存,照各家 API 實測;保存不了的時候,先支援明確的重新開始,會比宣稱可以無縫切換可靠。
換模型或改了 prompt、工具之後要重跑評測。Day 2 談過的 Databricks 私有評測顯示,同一顆模型換了 Harness,任務成本可能差兩倍以上,所以模型和 Harness 要一起測。測切換時還要故意放進改到一半的檔案、還在等的呼叫和結果未知的操作;只測乾淨的新 Session,等於沒驗過今天的交接。
Day 20–23 會補齊模型切換也不能帶走的權限和核准邊界;Day 29–30 再把模型和 Harness 的組合一起放進評測和發布流程。
回到 A 交給 B 的例子,可以試著問自己:換模型的時候兩個檔案的編輯都已經有結果,B 為什麼還會去改已經改好的檔案?把 A 的整段對話原封不動轉給 B,就解決了嗎?
第一題,結果在 Harness 手上,交接時只給了摘要,摘要沒寫哪兩個已經改完。要把確認過的結果(哪些檔案、diff、目前版本)當事實交過去,B 先看 diff 再接第三個。第二題沒有:A 的歷史是字串替換的呼叫,B 的工具集裡沒有這支;供應商的加密內容搬不過去,cache 也用不上。接得下去,但不能只交一段摘要給新模型。Harness 要把確認過的結果直接交過去,例如哪些檔案改好了、diff 是什麼;舊模型的工具呼叫和供應商專屬的狀態搬不過去,就用新模型自己的 prompt 和工具開新的一輪。 支援多模型,不代表所有模型都能用同一份 prompt、工具格式和續接資料。
這接回 Day 5 的送達區分、Day 11 的摘要限制,和 Day 18 的操作識別。
今天把模型之間的交接講完了。接下來換個方向看:不管換成哪顆模型,它提出了一個動作,究竟由誰決定能不能真的做?
models 陣列可以放不同家的模型,rate limit、停機、Context 長度等錯誤都可能觸發改送下一個;回應的 model 欄位是實際用的模型,照它計費。reasoning.effort 可能改寫隱藏的系統指示;GPT-6 以後支援的模型可以接 configuration_update 換 effort,保住前面的 cache。/effort 不再讓 cache 失效;/model 換模型前會警告下一輪要沒有 cache 地重讀整段對話(2.1.108 加入)。

 iThome鐵人賽
 看影片追技術