
🧭 Agentic search 搜什麼、搜到哪裡停,都由 Agent 自己決定,從改了哪些檔案看不出漏了什麼。要判斷找齊沒,交回時得附上它用哪些線索搜、排除了什麼、哪些還沒驗證。
昨天在 Day 16,我們讓截斷的工具回傳交代讀到哪裡、為什麼只有這些,和下一段怎麼拿。
快速回顧一下:Day 16 答錯的那兩次,是把「讀到的部分裡沒有」說成了「沒有」。今天換成 agentic search:Agent 自己搜程式碼、改完交回,審查的人怎麼知道它找齊了。
假設你的團隊在後端接 OpenAI,某天有幾個請求 timeout,想問 OpenAI 有沒有收到。OpenAI 的文件寫了做法:每個請求自己帶一個 X-Client-Request-Id header,值自己定;拿不到回應時,把這個編號給 OpenAI 的支援團隊去查。後端送到 OpenAI 的每個請求都得加上。
這種「改所有送到某個地方的請求」的任務,容易漏的是各自組請求、沒走共用函式的路。我想看 Agent 怎麼找、交回的說明能不能讓人判斷找齊了,所以做了一次實驗:
8bd8b4f)。我們要跟 OpenAI 對問題:後端送到 OpenAI 的每一個請求都要帶 X-Client-Request-Id header,值是每次請求新產生的 UUID。請直接改好,改完跟我說改了哪些地方。
我事先找出的答案:送到 OpenAI 的路不只一條。聊天、列模型清單、聊天時用的 embedding(把文字轉成向量),這些請求的 header 都由 routers/openai.py 裡同一個函式 get_headers_and_cookies 組好。文字轉語音和語音轉文字、產生和編輯圖片,還有文件搜尋要用的 embedding,則各自組 header,直接送給 OpenAI。
如果從第一個找到的函式下手:改 get_headers_and_cookies,再往外查誰呼叫它。呼叫它的有 10 處,全部在 routers/openai.py,改完的 diff 看起來很完整;語音、圖片、文件搜尋卻一個都沒出現,因為它們不用這個函式。
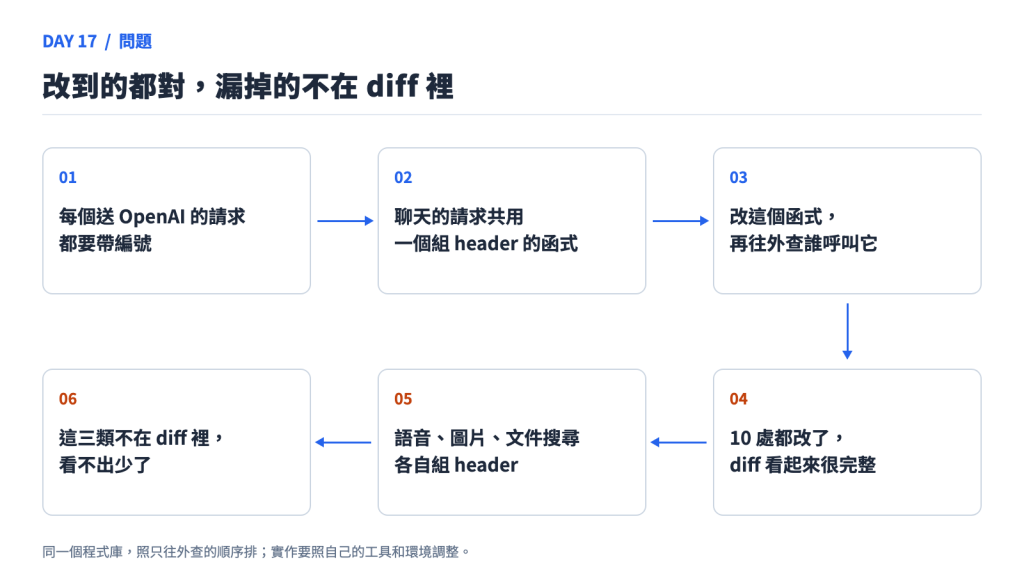
圖:每個送 OpenAI 的請求都要帶編號 → 聊天的請求共用一個組 header 的函式 → 改這個函式,再往外查誰呼叫它 → 10 處都改了,diff 看起來很完整 → 語音、圖片、文件搜尋各自組 header → 這三類不在 diff 裡,看不出少了。這是示意,實作要照自己的工具和環境調整。
這次 Claude 五個檔案都改到了,可是光看它交回的東西,判斷不出有沒有第六個。 我是事先找過答案、事後又重搜一遍,才敢這樣說。它的說明列了改了哪些、刻意沒動哪些,沒寫用哪些線索搜。下面先講 agentic search,再看 Claude 怎麼搜、交回時該交代什麼。
Agentic search 指的是模型手上有搜尋工具,自己決定下一次搜什麼:搜一次、看結果,再換個關鍵字或打開某個檔案,覺得夠了就停。另一種常見做法是先把整個程式庫切成一段一段,轉成向量(一串代表意思的數字)存起來,問題進來時一次撈出意思最接近的幾段,也就是向量檢索(下面也叫語意搜尋),RAG 多半這樣做。
Claude Code 走的是前者。它的作者 Boris Cherny 在 X 上說過,早期版本用過 RAG 加本機的向量資料庫,很快發現 agentic search 通常效果比較好,也比較簡單,沒有安全、隱私、資料過期和可靠度那些問題。Anthropic 介紹 Agent SDK 的文章也寫,語意搜尋通常比 agentic search 快,但比較不準、比較難維護,也比較難看出它為什麼找到這些;建議先用 agentic search,需要更快或更多變化時再加語意搜尋。
每種搜法都有它找不到的地方:
| 搜法 | 怎麼找 | 找得到 | 找不到 |
|---|---|---|---|
| 文字比對(grep、find) | 比對檔名或內容裡的字 | 寫出這個字的每個地方 | 名字猜錯、沒寫出這個字的 |
| 查引用(LSP) | 問語言伺服器誰引用了某個函式 | 跟它有程式關係的地方 | 沒用它、各寫各的程式 |
| 語意搜尋(向量) | 拿問題去比對預先轉好的向量 | 意思相近、排在前面的幾段 | 排名後面的,和索引建好之後才改的程式 |
照 Claude Code 的工具文件,在 macOS 和 Linux 上,它預設不給 Grep、Glob 這兩支獨立工具,改用 Bash 跑 find 和 grep(內建的 bfs、ugrep),所以實驗紀錄裡的搜尋都是 Bash 呼叫。查引用的 LSP 工具要先裝對應語言的 code intelligence plugin 才會啟用,這次沒用到。
Agentic search 也不只用在程式碼。財報、法規這類長文件,可以先替文件建一份目錄,再讓模型照目錄翻,後面「要搜的是長文件呢?」那節再看。
兩種做法也可以合用。Cursor 的文章寫,他們的 Agent 同時大量用 grep 和語意搜尋,兩者合用效果最好;在自家的 Cursor Context Bench 上,加了語意搜尋,回答程式庫問題的準確率平均高 12.5%(依模型 6.5%–23.5%)。
這幾種做法放在 Agent 上用,每一步搜什麼、搜到哪裡停,都是模型當下決定的。好處是每一步都是一次看得到的工具呼叫:語意搜尋難看出為什麼找到這些,agentic search 下過哪些 grep 都留在紀錄裡。Claude Code 把每個 session 存成一個 JSONL 檔,這次實驗的 45 次工具呼叫都在裡面。只是審查的人不會逐筆翻 45 次呼叫。
這個 session 一共呼叫了 45 次工具,第 23 次才第一次改檔,前面都在搜和讀。照紀錄排出來是這樣:
1. grep OpenAI 的名字:OPENAI_API_BASE_URL、api.openai.com、AsyncOpenAI、OpenAI(
2. grep 整個後端的 "Bearer",找自己組認證 header 的地方
3. 逐一讀命中的那幾段:openai.py、圖片、語音、文件搜尋
4. 開始改:在 utils/headers.py 加一個產生編號的小函式,改共用函式
5. grep 誰呼叫共用函式,確認每處只送一個請求
6. 改文件搜尋、圖片、語音三個檔案
第一步搜的是請求最後送去的地方(下面叫目的地),也就是 OpenAI 本身:設定名、預設網址、SDK 的 class 名。結果大半落在設定檔 config.py,裡面每個功能都有一個自己的 OpenAI 網址設定。拿它跟從共用函式往外查的結果並排:
從共用函式往外查(誰呼叫它)
  routers/openai.py               10 處
  其他檔案                          0 處

從目的地往回搜(config.py 裡的設定名)
  OPENAI_API_BASE_URL              聊天(走共用函式)
  RAG_OPENAI_API_BASE_URL          文件搜尋的 embedding
  IMAGES_OPENAI_API_BASE_URL       產生圖片
  IMAGES_EDIT_OPENAI_API_BASE_URL  編輯圖片
  AUDIO_STT_OPENAI_API_BASE_URL    語音轉文字
  AUDIO_TTS_OPENAI_API_BASE_URL    文字轉語音
每個設定名都指向一個會讀它、再把請求送出去的地方,順著讀下去就是一條路。
第二步換一條線索搜同一個目的地:送到 OpenAI 的請求都要帶 API key,放在 Authorization: Bearer … 裡。這次回來一百多行,混著登入、帳號同步這些跟 OpenAI 無關的結果,其中有圖片那幾行:它們把圖片專用的 OpenAI key 自己放進 header。
第三步是讀。同一個檔案裡常常不只接一家:圖片那支還有 Gemini、ComfyUI 的分支,語音那支還有 Mistral、ElevenLabs。它只改送 OpenAI 的分支,其他沒動。
第五步才往外查誰呼叫共用函式,但問的是另一件事。編號要每個請求一個,如果某個呼叫端拿同一組 header 連送好幾個請求,這些請求就會共用同一個編號。它查完確認共用函式的 10 個呼叫端都只送一個;圖片和語音轉文字那幾段會拿同一組 header 送好幾次,它就改成在送出那一刻才產生編號。
找到語音、圖片、文件搜尋的,是第一、二步往回搜;第五步往外查只是確認細節。這是一次的結果,而且 Open WebUI 每個功能都把 OpenAI 的網址寫成一個設定,目的地很好搜。網址存在資料庫、或由管理頁面設定的專案,搜設定名能找到的就少;我會改搜 SDK 的 class 名、API key 的變數名,或請求路徑(/embeddings、/audio/speech)。這部分我沒有測過。
一次找齊,下次也不一定。2025 年 11 月一篇研究讓 Claude Code、Codex 等四個 coding agent 修 404 個要改好幾處的 bug,看 patch 有沒有改到所有該改的檔案:最高的 Codex 是 75.3%,最低的 40.4%;要改的位置越分散,修好的比例越低。
審查的人手上通常只有 diff 和 Agent 最後那段說明。這次的說明,除了改了哪些地方,還有兩段讓人能檢查。
一段是「刻意沒動的地方」。Azure 專用的 embedding 沒加,因為那是送到 Azure,OpenAI 查不到;查語音模型和語音清單的請求沒加,因為程式只在網址不是 api.openai.com 時才會去查。它也講了兩個會影響行為的決定:使用者自己加的 OpenAI 相容連線(例如本機模型)走同一段程式,也會帶這個 header;管理員自訂了同名 header 的話,會被新產生的編號蓋掉。(列成表格,是我的全域 CLAUDE.md 要求的。)
另一段在說明的第一句:「程式改好了,但我沒能驗證」。我這次只開放它跑 grep、ls 這類搜尋指令,語法檢查和實際呼叫新函式都被權限擋下來,它照實講了。它還多指出一件事:編號送出去了,後端卻沒記在任何地方,日後要找 OpenAI 對問題時,手上拿不出這個編號。要不要記進 log,它留給我們決定。OpenAI 的文件建議正式環境把回應裡附的 request ID 記下來;拿不到回應的時候,就只剩自己帶的這個編號能對。
我自己另外核對了一次:把後端每個發 HTTP 請求的地方列出來,逐一看送去哪裡。送到 OpenAI 的都改到了,沒找到漏掉的。倒是有一處說明沒寫:語音那支的 Mistral 分支,它沒改是對的(那是送到 Mistral),但「沒動的地方」沒列。審查的人沒看到這行,就得自己再查一次才敢確定。
說明裡完全沒提的,是它用哪些線索搜。改了哪些、沒動哪些都列了,審查的人還是不知道它有沒有少搜一類;要知道,只能打開 session 紀錄翻那 45 次呼叫,或像我一樣自己重搜。
GitHub 的 Copilot cloud agent 是把整份紀錄附上:每個 commit 訊息都有 session log 的連結,code review 或稽核時查得到為什麼這樣改;session log 裡有它的推理,和它用哪些工具理解程式庫、改程式、驗證。Anthropic 的 Building effective agents 也把「明確呈現 Agent 的規劃步驟」列為做 Agent 的三個原則之一。紀錄附上了,還是要有人讀,所以我會要 Agent 自己整理成幾行。
交回的東西至少要說得出:目的地是什麼、用哪些線索搜、找到哪些路、排除了哪些和理由、哪些還沒驗證。
線索清單交回來之後,審查的人要看它有沒有對上任務的範圍:
這次是第二種,Claude 用的設定名、網址、SDK 的 class 名和 Bearer 都屬於目的地這一類。如果清單上只有 get_headers_and_cookies,一眼就看得出少了一整類。這是我的歸納,第一、三種這次沒有實測。
程式碼沒有現成的目錄,Claude 只能靠搜字一路找。財報、法規、技術手冊這類長文件本來就有章節,PageIndex 利用的就是這點。它的 README 說,向量檢索找的是「意思相近」,回答問題要的是「相關」,兩者不一定重疊;所以它不做向量比對,改讓模型像人翻書一樣照目錄找。做法分兩段:建目錄樹,每份文件建一次;在樹上找,每次提問都跑一次。
建樹這段,每個節點有標題、編號和起訖頁碼,可以再加一段摘要。樹的骨架是從 PDF 版面抓出來的,不靠模型,模型只負責補摘要和修整。README 自報,在本機建樹每頁約 0.001 美元,9 到 1,098 頁的文件花 13 秒到 4.5 分鐘,建好之後每個問題都重複用。下面是 repo 附的範例,美國聯準會(Fed)2023 年報建出來的樹,節錄兩章:
[0006] Financial Stability                              p.21
  [0007] Monitoring Financial Vulnerabilities           p.22–28
  [0008] Domestic and International Cooperation and …   p.28–31
[0009] Supervision and Regulation                       p.31
  [0010] Supervised and Regulated Institutions          p.32–35
  [0011] Supervisory Developments                       p.35–54
搜這段,開源版給 Agent 四支唯讀工具,主要用到兩支:get_document_structure 讀整棵樹,節點的內文會被拿掉,只剩標題、頁碼和摘要;get_page_content 讀指定頁碼的內文。一次提問大致這樣跑:
1. get_document_structure   讀整棵樹,看全貌
2. 照標題挑一節             例如 [0007] Monitoring Financial Vulnerabilities
3. get_page_content         pages="22-28",只讀這幾頁
4. 判斷夠不夠               不夠就回到樹上挑下一節;夠了就回答,附上頁碼
工具說明裡寫了幾條規則:文件超過 20 頁,一定要先讀樹、挑好章節,再拿頁碼讀內文;頁碼範圍要窄,不准一次讀整份;樹太大一次回不完,用 part 參數分段讀。他們 2025 年 9 月的介紹文把這個循環寫成五步:讀目錄、挑章節、取資訊、判斷夠不夠、回答。
成效的數字都是他們自己量的。FinanceBench(財報問答測驗)準確率 98.7%,向量 RAG 是 50%。跟每次把整份 PDF 丟給模型比,在兩種做法都答對的文件上,52 頁的文件整份丟貴 2.1 倍,420 頁貴 16.6 倍,805 頁直接塞不進 context window。
要接到自己的 Agent 上,SDK 的 as_claude_mcp() 會把這些工具包成 MCP server 交給 Claude Agent SDK;雲端版另有現成的 MCP server。本機版只處理文字型 PDF,掃描檔要用雲端版做 OCR(把圖片裡的字辨識出來)。
放回今天的主題,這種搜法留下的紀錄很好讀:打開了哪幾個節點、讀了哪幾頁,都在每次呼叫的參數裡,拿去對目錄樹,沒打開的章節一眼就看得出來。要小心的是章節標題沒反映內容的時候,模型照標題挑,那一節可能根本沒被打開,所以交回時一樣要列出讀了哪些章節、跳過哪些。這點是我的推論;這一節是讀它的文件和原始碼整理的,沒有實際跑。
Open WebUI 的後端用 grep 搜得動。程式庫大到 grep 和逐檔讀撐不住時,同樣的步驟要換工具。Sourcegraph 的分析舉了 Kubernetes 的例子:只能用本機 Grep、Glob 和讀檔的 Agent,在 6,000 秒上限內沒交出結果;同一個模型拿到索引式關鍵字搜尋、語意搜尋和找引用之後,89 秒完成,那次得分是 0.90(Sourcegraph 自己的 benchmark)。我覺得可以參考的是,工具換了,要搜的東西沒變:目的地的名字、網址和 API key,交回時也一樣要列出來。
我會讓 Agent 交回時附一份範圍說明,跟 patch 放在一起。下面的值是這次實驗的:
| 欄位 | 這次的值 | 誰寫、誰讀 |
|---|---|---|
target |
OpenAI API(目的地) | 交代任務的人寫,Agent 照它搜 |
revision |
Open WebUI commit 8bd8b4f |
Agent 寫,審查的人和 CI 對版本 |
signals |
*OPENAI_API_BASE_URL、api.openai.com、OpenAI(、Bearer |
Agent 寫,審查的人看少了哪一類 |
found |
聊天的共用函式、語音、圖片、文件搜尋 | Agent 寫,驗證流程讀 |
excluded |
Azure embedding(送到 Azure)、語音清單查詢(只在不是 OpenAI 時才查) | Agent 寫,審查的人判斷理由站不站得住 |
verified |
空的:語法檢查和測試都沒跑,沒有權限 | 跑過測試的流程寫 |
def check_scope_report(report):
    if not report["signals"]:
        return {"status": "incomplete", "reason": "沒寫用哪些線索搜目的地"}
    no_reason = [p for p in report["excluded"] if not p.get("reason")]
    if no_reason:
        return {"status": "incomplete", "reason": "排除了卻沒寫理由", "paths": no_reason}
    unverified = [p for p in report["found"] if p not in report["verified"]]
    if unverified:
        return {"status": "needs_verification", "paths": unverified}
    return {"status": "ready_for_review"}
| 誰呼叫 | 什麼時候 | 這次的結果 |
|---|---|---|
| Claude Code 的 Stop hook | Claude 要結束這一輪回覆時 | 從最後一則回覆取出範圍說明跑這個函式;沒附或 incomplete 就擋下,附上原因要 Claude 補。這次的說明沒附,會被擋下 |
| CI | 開 PR、跑完測試之後 | 測試涵蓋到的路徑加進 verified,四類都有就變 ready_for_review |
| 審查的人 | review 時 | 看 signals 有沒有少一類、excluded 的理由站不站得住;函式只檢查列出來的,沒列的(像這次的 Mistral)還是要從目的地再搜一次 |
Stop hook 是 Day 10 提過的 hook 的一種:Claude 每次結束回覆前會先跑它,拿到的資料裡有最後那則回覆的全文;hook 回 decision: "block" 加上原因,Claude 會看到原因接著做(hooks 文件)。我拿這次實驗的最後一則回覆測過這支檢查,回的是 block;接進 Claude Code 後 Claude 怎麼補,這次沒跑。文件提醒一直擋會無限循環,所以 stop_hook_active 為真時我直接放行,最多擋一次。
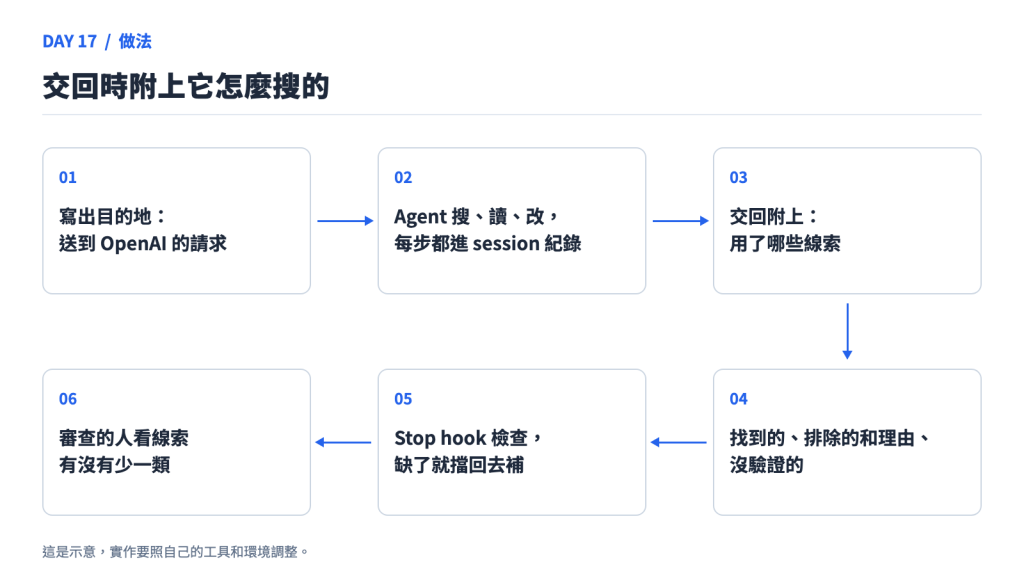
圖:寫出目的地:送到 OpenAI 的請求 → Agent 搜、讀、改,每步都進 session 紀錄 → 交回附上用了哪些線索 → 找到的、排除的和理由、沒驗證的 → Stop hook 檢查,缺了就擋回去補 → 審查的人看線索有沒有少一類。這是示意,實作要照自己的工具和環境調整。
假設你已經做到 Day 16:工具截斷時會說讀到哪裡、怎麼續讀。接下來讓 Agent 搜程式時交得清楚、看得出找齊沒,我會照這個順序:
第一步,交代任務時寫出目的地。 我會寫「送到 OpenAI 的每一個請求」,不寫「改一下 OpenAI 的 client」。前者講的是請求送去哪裡,後者講的是一個函式,照字面做,查完誰呼叫它就可以交差了。
第二步,要求交回時附上範圍說明。 用哪些線索搜、找到的路徑、排除的和理由、哪些還沒驗證,寫進專案的 CLAUDE.md,每次都會帶到。要確定每次都有,再加上面那個 Stop hook,沒附就擋回去補。
第三步,讓它跑得了驗證。 這次我只開放搜尋指令,它改完只能照實說沒驗證。給它跑測試的權限,或交給 CI 跑,verified 才填得進東西。
第四步,補上別的搜法。 常要查引用的話,裝對應語言的 code intelligence plugin,讓 LSP 工具能用;程式庫大到 grep 搜不動,再接 Sourcegraph 這類有索引的工具。線索還是照任務的範圍挑。
只有一個 client、所有請求都從同一處送出的小專案,做到第一步就夠了。路徑多、又牽涉付款或權限的修改,才值得做後面的範圍說明和驗證。Day 18 接著看 timeout 拿不到回應時怎麼辦,也就是今天這個編號派上用場的時候;Day 29 再看 Agent 說做完了,要怎麼確認。
回到 Open WebUI 的例子,可以試著問自己:如果 Claude 只改了共用函式,再查誰呼叫它,10 處都帶上了新 header,審查的人從 diff 看得出漏了嗎?它交回的「沒動的地方」沒提 Mistral 語音,算漏了嗎?
第一題看不出來。10 處改的都對,漏掉的三類根本不在 diff 裡。要它附上線索清單才看得出來:清單上只有 get_headers_and_cookies,沒有任何 OpenAI 的設定名、網址或 API key,少了目的地這一整類。
第二題程式沒漏,Mistral 本來就不送 OpenAI,不改是對的。但說明沒寫,審查的人就得自己再搜一次才敢確定;排除清單寫得越齊,審查的人越不用重做一遍。
Agentic search 搜什麼、搜到哪裡停,都由 Agent 自己決定,從改了哪些檔案看不出漏了什麼;要判斷找齊沒,交回時得附上它用哪些線索搜、排除了什麼、哪些還沒驗證。
今天加的編號,是為了拿不到回應的時候,還能問 OpenAI 有沒有收到。接下來就是那個情況:呼叫已經送到外部服務,卻沒拿到回應。這時候再試一次,會不會把同一件事做兩遍?
X-Client-Request-Id 要自己加、格式自訂(只能用 ASCII、最多 512 字元),timeout 拿不到回應時可以用它請支援團隊查有沒有收到;也建議正式環境把 OpenAI 回應裡的 request ID(x-request-id)記進 log。8bd8b4f。正文的檔案名、設定名和呼叫端數量都是照這個版本查的,之後改版會變。find、grep 取代 Glob、Grep;LSP 工具能查定義和引用,要先裝 code intelligence plugin。examples/results/2023-annual-report_structure.json。STRUCTURE_FIRST_PAGE_THRESHOLD)、讀頁要用窄範圍、樹太大用 part 分段,_format_structure() 把節點內文拿掉。這是我讀原始碼看到的,沒有實際跑。as_claude_mcp() 在雲端版回傳遠端 MCP server 的設定,在本機版回傳跑在同一個 process 裡的 MCP server,接 Claude Agent SDK 用。last_assistant_message 和 stop_hook_active;回 decision: "block" 加 reason 會讓 Claude 繼續,並提醒一直擋會無限循環。

 iThome鐵人賽
 看影片追技術