
🗃️ Compaction 把舊對話壓短,Agent 才跑得下去;壓完原文通常還在,摘要要記下出處,才找得回去。
昨天在 Day 10,我們確認了必要的內容有沒有進到模型輸入。今天往下問:內容進去過了,對話被壓成摘要之後,原本的證據和意思還在嗎?
快速回顧一下:Day 7 把可恢復的進度存在 process 外面,Day 9 讓留在 Context 外的資料查得回原文。
假設一個 Agent 在查跨服務的延遲,已經跑了二十輪。trace 會列出一筆請求經過哪些步驟、各花多久;它看了幾筆慢請求,資料庫那一步都很短,在 queue 裡等的時間卻很長,所以決定先查 queue。
這時 Context 快滿了,Harness 把前面二十輪壓成一段摘要,摘要卻寫成「資料庫查詢很慢,下一步查資料庫」。之後每一輪,模型只讀得到這段摘要,就照著去查資料庫。原本的 trace 還存著,只是模型已經看不到,也沒有東西提醒它回去對。
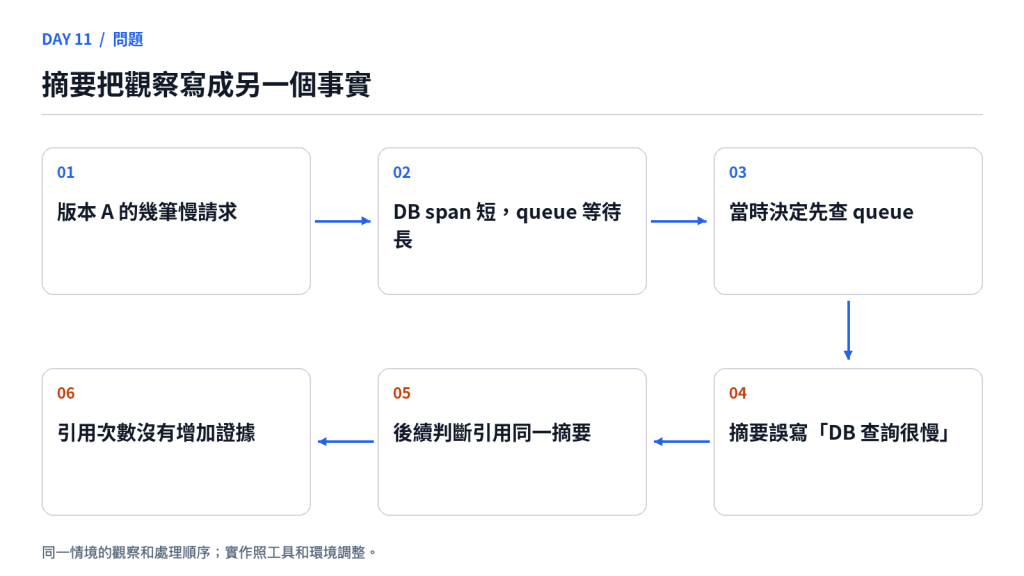
圖:版本 A 的幾筆慢請求 → DB span 短,queue 等待長 → 當時決定先查 queue → 摘要誤寫「DB 查詢很慢」 → 後續判斷引用同一摘要 → 引用次數沒有增加證據。這是示意,實作要照自己的工具和環境調整。
下面先看 compaction 是什麼、各家怎麼做,再看摘要怎麼記住自己的來源、什麼時候該回去讀原文、讀回來之後怎麼修,最後是錯誤已經擴散時怎麼重來。
模型一次讀得下的長度有上限,也就是 context window。沒塞滿之前,內容多了一樣有代價:Day 8 引過 Chroma 的測試,輸入越長,模型表現越往下掉,各家掉的幅度不一樣,這個現象叫 context rot。所以 Agent 跑久了,不能讓對話和工具結果一直往上疊,Harness 得讓下一輪送出去的內容變短,這件事叫 compaction。做法大致有三種:請模型把舊對話寫成摘要、交給模型供應商在伺服器端壓,或是不寫摘要,只把舊的工具結果換掉。
這是最常見的做法。用量到了門檻,Harness 把比較舊的那段對話,連同一段「請整理成摘要」的指示送給模型,多花一次呼叫;拿回摘要之後,下一輪送出去的就變成「規則+摘要+原樣保留的最近幾則」。從這一輪起,模型只讀得到摘要,摘要漏掉或寫錯的地方,它自己不會知道。開頭情境裡,摘要就是在這一步把 queue 等待寫成了資料庫很慢。
Claude Code 就是這樣做:快滿時自動壓縮,也可以自己打 /compact,後面加一句要摘要特別保留什麼。我翻了自己電腦上 Claude Code 的紀錄檔(~/.claude/projects/ 底下,每個 session 一個 .jsonl),29 個 session 裡有 74 次壓縮,每次都留一筆紀錄,寫著自動還是手動、壓縮前後各幾個 token。74 次的中位數是壓縮前約 41.8 萬 token、壓縮後約 1.4 萬,剩原本的 3% 左右。
摘要是看得懂的文字,大多分成使用者的要求、改過的檔案、遇到的錯誤、待辦、目前進度幾節,後面接最近幾則原樣保留的訊息。最後一句會提醒模型:需要壓縮前的程式碼或錯誤訊息,就去讀完整的紀錄檔,後面附上路徑。壓完之後,Claude Code 會重新載入 system prompt、CLAUDE.md 和 memory,重讀最近改過的最多五個檔案,用過的 skill 也放回去,這幾樣不靠摘要記得。
Codex CLI 預設用到 context window 九成時壓縮。它給模型的指示是寫一份交接摘要給接手的模型,內容包括目前進度和做過的決定、重要的限制和使用者偏好、還剩什麼要做、接下來會用到的資料。摘要前面會加一段話,告訴模型這是另一個模型留下的進度,接著做、不要重做。
新的歷史只留使用者講過的話,從最近的往回留,最多約兩萬 token;模型自己的回覆和工具結果,都只剩摘要裡寫到的部分。每次壓完,Codex 還會發一則警告:對話太長、壓縮太多次,模型可能變得比較不準,能開新 thread 就開。
這樣壓完,prompt cache 會斷一次。Day 8 講過 cache 是照前綴比對:規則和工具沒變,還能命中;從摘要開始內容換了,後面都要重新寫入。
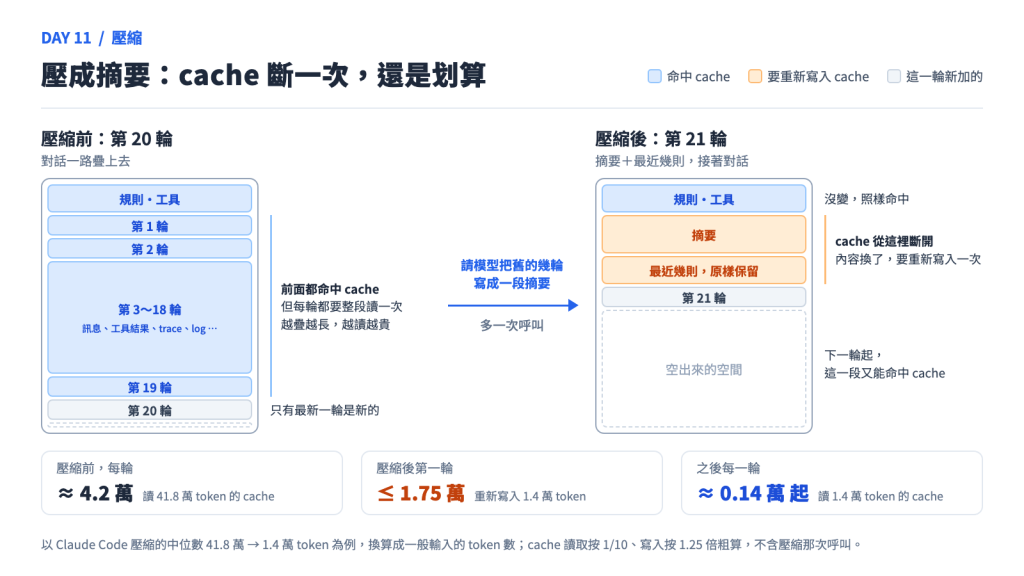
圖:左邊是壓縮前的第 20 輪,規則、工具和前 19 輪都命中 cache,只有最新一輪是新的,但每輪都要整段讀一次;中間請模型把舊的幾輪寫成一段摘要,多一次呼叫;右邊是壓縮後的第 21 輪,規則和工具沒變照樣命中,摘要和原樣保留的最近幾則要重新寫入,後面空出一大截;最下面三格是照 cache 價格粗算的每輪成本。這是示意,區塊大小沒有照實際比例畫。
斷一次還是划算。照 Day 8 價格表裡多數模型的比例,cache 讀取是一般輸入的 1/10,保存 5 分鐘的寫入是 1.25 倍,輸出是 5 倍。拿我電腦上 Claude Code 壓縮的中位數,41.8 萬壓到 1.4 萬來算,全部換成一般輸入的 token 數:壓縮前每輪光讀 cache 就要約 4.2 萬;壓縮後第一輪最多 1.75 萬,之後每輪從 0.14 萬起跳。壓縮那次呼叫要把舊對話讀一遍、再按輸出價寫摘要,就算摘要把 1.4 萬整個佔滿,大約四輪也攤回來了。這還沒算 context rot 的影響。
第二種是把壓縮交給模型供應商的 API:你照常送 request,API 寫好壓縮結果回傳,下一輪你把它放在舊訊息的位置送回去。OpenAI 和 Anthropic 都有兩種用法:在一般 request 設一個門檻,超過就自動壓;或另外發一次專門壓縮的請求,自己決定什麼時候壓。
OpenAI Responses API 的 compaction 回傳的是加密項目,文件明寫它不是給人讀的。另外發請求壓的話,回傳的整個 window 就是下一輪的輸入,不要再自己刪;讓伺服器自動壓的話,最新一個壓縮項目之前的內容可以拿掉,由伺服器幫你串接對話的除外。Codex 接的是 OpenAI 自己的 API 時,就改用這種壓法。摘要有沒有寫錯,沒辦法打開來看。這份狀態也不能直接搬到別家模型。
Claude API 的 compaction(目前是 beta)由 Claude 在伺服器端寫摘要。回傳的摘要是看得懂的文字,另外附一段簽章,內容被改過 API 就拒收。下一輪把它放在最前面,取代被摘要的那些訊息;那段範圍裡的圖片、文件和抓過的網頁,壓完就不見,還要用就得重新附上。摘要的指示可以自己寫,會整份換掉預設的那份。
兩家的文件都沒提怎麼從壓縮結果找回被取代的原文,要查得回,就得自己存。套到開頭的情境,Claude API 的摘要至少讀得到「資料庫很慢」這句,拿去跟自己存的 trace 一比就對得出來;OpenAI 的連這句都看不到。
第三種完全不寫摘要:把一部分舊的工具呼叫和結果刪掉,或換成一行短說明,其他原封不動。要動哪幾段有兩種挑法,照固定規則挑的,就是 Day 9 提過的 context editing;請另一個模型判斷的,最近很紅的是開源的 fast-jev-compaction,九月開源,八天就有六千多顆星。它請 TypeSafe 做的 Jev 模型來挑,Jev 專門回答打分數、選擇、是非這類問題。
它是 Claude Code 的外掛,接在壓縮那一步,拿來取代內建的摘要。每一次工具呼叫,它問 Jev 兩題:這次呼叫本身還要不要留、結果要不要原封不動留著。Jev 看得到整段對話,但每段工具結果都先換成「成功,4,213 字,已省略」這種一行註記。結果那題過門檻(預設 0.5)就整段留;只有呼叫那題過,結果砍到剩開頭 300 字;兩題都沒過,呼叫和結果一起刪。
第一則和最新 6 則訊息不碰,使用者和模型寫的文字都原樣留著。沒有任何字被改寫,開頭那種「摘要把觀察寫反」的錯就不會發生。
LiteLLM(一個幫你轉接各家模型 API 的 proxy)九月也加上了同一個 Jev 的 compaction,做法更簡單:每次 request 送出前,拿最新一則使用者訊息當題目,每段結果最多給 Jev 看 4,000 字,分數低於 0.2 的整段換成一行「已移除」的通知。
我自己不太認同這個做法。第一是擔心掉資料:Jev 決定一段結果要不要留的時候,看不到結果內容,只知道呼叫了什麼、結果多長;LiteLLM 版則只看跟最新一個問題有沒有關。被刪掉之後,模型只剩一行說明或開頭 300 字。專案說明給的辦法是模型可以再跑一次工具,但重跑拿到的是現在的結果,不一定是當時那份。現在用不到的結果,幾輪之後也可能又需要。
第二是壓縮率可能不高:能刪的只有工具呼叫和結果,使用者和模型自己寫的文字都留著;一段很長的測試 log,有用的那行不在開頭,砍到剩 300 字也留不住。專案自己也備了退路:字數省不到 25% 就退回 Claude Code 內建的摘要。LiteLLM 的介紹文也寫,開了 compaction 不保證每個 request 都會變小。跟內建摘要壓到 3% 左右比,我猜差距不小,但兩邊的工作不一樣,要用自己的任務量過才算數。
是。Claude Code 和 Codex 壓縮都不會另開一個新的對話,只是在同一個紀錄檔後面多記幾筆。我電腦上 Claude Code 的每一筆壓縮紀錄,都是這個樣子:
同一個 .jsonl,session ID 不變
訊息 1 … 訊息 N    ← 壓縮前的原文,都還在
壓縮分界           ← 「上一則」留空,另一欄記著壓縮前最後一則是 N
摘要
最近幾則,原樣保留
壓縮後的新訊息 …
每則訊息都記著自己的上一則是誰。分界那筆的上一則是空的,從最新的訊息往回串,串到分界就停,所以模型讀到的是摘要加上後面的訊息;另一欄記著壓縮前最後一則,前後的關係沒斷。「串到分界就停」是我從欄位推的,官方文件說這個檔案的格式是內部的、每一版都可能變,所以我只拿它看壓縮做了什麼,不把裡面的欄位當規格。
講 checkpoint 的文件倒是有一句明寫:從 /rewind 選單挑一段來摘要,還是同一個 session,原本的訊息也留在紀錄檔裡,Claude 還查得到細節。
Codex 也是同一個 thread、同一個紀錄檔:壓縮時在檔案後面加一筆,放摘要和整份新的歷史。之後重新打開這個 thread,程式從檔尾往回找最新一筆壓縮當起點,再補上它後面的紀錄,更早的就不再放回模型輸入。只是這筆紀錄沒寫它取代了哪些訊息,要找原文只能從它在檔案裡的位置往前找。
OpenHands(一個開源的 coding agent 專案)也是請模型寫摘要,多做了這一步:另外記一筆「這段摘要取代了哪些事件」,原事件留在紀錄裡,只是不再送給模型。
回到之前的某一則重來,也沒有刪紀錄。Codex 回到舊訊息重寫時,會開一個新的紀錄檔,只引用舊檔要保留的前半段,再把這個 thread 改指到新檔,舊檔一個字都不動。Claude Code 的 /rewind 怎麼用,Day 7 講過;它的紀錄檔每則都記著上一則,所以一則訊息後面可以分出兩條後續,我在自己的紀錄檔裡看到十幾處這種分岔,兩條都還在。
所以壓縮和退回,動的都是「這一輪讀哪一段」,原始紀錄一直在檔案裡。開頭那份 trace 也一樣還在,差在模型不知道要回去找。
放在一起看,這幾家差在兩件事:原始紀錄還在不在,從摘要找不找得回原文。
| 怎麼變短 | 模型看到的 | 原始紀錄 | 找得回原文嗎 | |
|---|---|---|---|---|
| Claude Code | 模型寫摘要 | 看得懂的摘要+最近幾則訊息 | 留在同一個紀錄檔 | 摘要附紀錄檔路徑,沒標是哪一段 |
| Codex CLI | 模型寫摘要(接 OpenAI API 時改用伺服器端) | 摘要+最近的使用者訊息 | 留在 session 紀錄檔 | 只能看位置往前找 |
| OpenHands | 模型寫摘要 | 開頭幾個事件+摘要+最近事件 | 事件紀錄只增不刪 | 記下被取代的事件 |
| OpenAI Responses API | 伺服器端壓縮 | 加密項目,人讀不懂 | 自己決定留不留 | 文件沒提 |
| Claude API | 伺服器端寫摘要 | 看得懂的摘要,附簽章不能改 | 自己決定留不留 | 文件沒提 |
| fast-jev-compaction | 刪掉或截短用不到的工具呼叫和結果 | 原文,被動過的剩一行說明或開頭 300 字 | 外掛不改紀錄檔 | 說明只寫可以重跑工具 |
| LiteLLM+Jev | 整段換掉用不到的工具結果 | 原文,被刪的剩一行通知 | 只改送出的 request,自己存的歷史不動 | 通知沒有指回原文 |
我會把三種資料分開:
這三個名字是我為了討論取的。Shopify 的 Aquifer 也是這樣分:Session 歷史存在 Postgres,Harness 和 sandbox 都可以重建,保存下來的歷史跟送給模型的內容是兩回事。只剩一份的工具結果,不能被摘要悄悄蓋掉。摘要本身也記成一筆,跟原事件分開存。
我會學 OpenHands,讓每段摘要旁邊多記幾樣東西:它取代了哪些原事件、什麼時候產生、用哪一版摘要規則。發現摘要不對時,靠事件範圍知道回哪裡找原文;同一段歷史換個 prompt 整理,取捨可能就不同,記下規則版本,出問題時才知道是哪一份摘要。這些紀錄保證不了摘要正確,只是讓錯誤查得到。
至於哪些東西要留著查得回原文的位置:已經送出去的外部操作、使用者的更正、還有效的 policy、核准、待辦、資源 ID,還有會推翻主要假設的證據。很長的安裝 log、重複的搜尋結果,只帶摘要就好,甚至可以先不放進下一輪。
每輪都把原文讀回來,壓縮就白做了。我會在這幾種情況要求回頭確認:摘要裡的結論找不到來源、新的工具結果跟摘要對不上、準備做高風險的動作卻只有摘要當依據,或是壓縮幾次之後,待辦、核准和資源 ID 兜不起來。
開頭的情境如果繼續下去,模型照摘要查了資料庫,結果跟摘要對不上,就是第二種。這時用摘要記下的來源範圍,把當時那段 trace、查詢結果和判斷紀錄讀回來,確認「為什麼當時先查 queue」;要引用某次測試,就讀那份測試報告。這個動作也常叫 rehydration,就是按需要把原始資料取回來,跟 Day 9 讀留在外面的資料是同一套做法,不用把整段歷史全部放回去。回讀會多花工具呼叫和時間,換來的是重要結論能再對一次來源。
這一段要自己接,SDK 不會替你判斷誰對誰錯。前提是當時的調查紀錄本來就寫清楚範圍:「在版本 A、10:00–10:05、已經看過的這幾筆慢請求裡,資料庫 span 很短,先查 queue 等待。」把它縮成「永遠不是資料庫」,一樣會錯。
讀回來確認摘要真的寫反了,就另外產生一份更正過的模型輸入:保留觀察範圍、原證據的位置和下一步查 queue,標明舊摘要已經更正。舊摘要和它的產生紀錄照樣留著,回讀本身也記一筆:查了哪些事件和報告、哪些地方改了。之後才查得出當初怎麼錯的,摘要方式也才有辦法改。
新結果跟舊摘要不一樣,也不一定是摘要錯了。先對時間、版本和範圍,兩邊可能在回答不同的問題,原始觀測也未必完整。新 trace 如果來自版本 B、另一個時段,而且顯示資料庫變慢,那要更新的是假設:先前「這幾筆請求的資料庫 span 很短」只說明當時看到的範圍,沒有排除其他請求或時段。查回原文是為了重新判斷證據,第一次的結論也可能要改。
Anthropic 的 Context engineering 文章 建議 Coding Agent 優先保留架構決定、還沒解的 bug 和必要的細節,重複的工具輸出可以拿掉;它也提醒,壓得太兇,可能丟掉後來才發現重要的資訊。留太多,Context 很快又滿;刪太多,限制、資源 ID 或沒做完的工作可能不見。這個取捨沒有哪一份摘要 prompt 能一次解決。
資料大致正確、只是太長,繼續 compaction 就好。錯的前提已經混進摘要、計畫和待辦,再摘要一次,可能只是把錯誤寫短。這時可以考慮 context reset:清掉舊的模型輸入,從已經確認的進度和資料重新組一份來接手。Anthropic 的長任務 Harness 文章 比較過 compaction 和 reset,也交代 reset 會多花編排、token 和延遲;案例用的是 Sonnet 4.5、Opus 4.5 和當時的 Harness,不能說換成任何模型 reset 都比較好。
能不能 reset,要看任務規格、checkpoint、待辦和產物位置有沒有像 Day 7 那樣另外存起來。全部只留在舊對話裡,清掉就找不回來。需要強制的限制,照樣由 policy 和權限檢查來擋,摘要本身擋不住違規。
這是我會接在摘要儲存上的最小做法:read_range 照版本和事件範圍把原事件讀出來,save_summary 把摘要另外存一份,兩個都用既有的儲存,原事件一筆都不改。
| 欄位 | 這個情境的值或用途 | 誰讀寫 |
|---|---|---|
| source_version/event_range | 版本 A、摘要實際讀過的事件範圍 | 摘要產生器讀取 |
| summary_id/text | 另存的新摘要和文字 | 輸入組裝處使用 |
| source_ref | 原 trace 的版本和位置 | 發現矛盾時回讀 |
def compact(read_range, summarize, save_summary, source_version, event_range):
    events = read_range(source_version, event_range)
    text = summarize(events)
    return save_summary(text, source_version, event_range)
摘要讀的範圍要先固定下來。摘要還在產生時如果有新訊息進來,就留在範圍外,下一輪另外加進去,不要把還沒讀到的事件也標成已經濃縮。
| 誰呼叫 | 什麼時候 | 結果 |
|---|---|---|
| 摘要元件 | 輸入需要縮短時 | 另存摘要和來源;範圍之外的新訊息下一輪另外加入 |
| 輸入組裝處 | 每一輪送出前 | 放最新的摘要,再接上範圍之後的事件 |
| 查證工具 | 新結果跟摘要對不上時 | 照 source_ref 讀回原 trace |
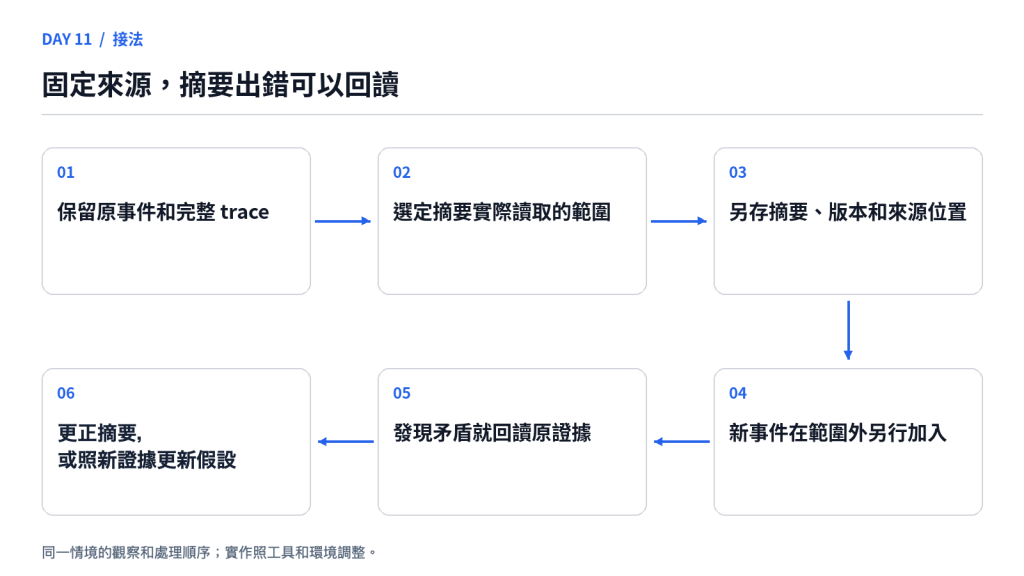
圖:保留原事件和完整 trace → 選定摘要實際讀取的範圍 → 另存摘要、版本和來源位置 → 新事件在範圍外另行加入 → 發現矛盾就回讀原證據 → 更正摘要,或照新證據更新假設。這是示意,實作要照自己的工具和環境調整。
假設你已經做到 Day 10:看得到每一輪實際送進模型的是哪些來源、哪個版本。下一步可以拿同一個調查比較壓縮前後,看「實際看到什麼、範圍多大、接著查什麼」有沒有被寫反,再照這個順序補:
先把原始資料和這輪輸入分開存。 壓縮只動這輪輸入,原始歷史照舊保留。已經有 SDK、資料庫或產物儲存的,就用它們,不用為了這幾個名詞另外搭一套。
再讓摘要帶著來源範圍。 每段摘要記下涵蓋哪些事件、用哪一版規則產生,完整報告放在讀得回來的固定位置。
最後,壓縮或 reset 之後由 Harness 重新帶入規則、核准和進度,不靠摘要剛好記得。
保存多久、隱私刪除和權限,照原本的規則處理,這裡沒有要所有資料永久保存;只是在資料還留著的期間,不要把摘要當成比原始結果更可靠的依據。
一段摘要加上回讀就接得下去的話,做到這三步就夠,不用急著做自動 reset。反覆壓縮之後還是出現矛盾、重要的任務狀態跟錯的前提纏在一起,再考慮從存好的進度重建輸入。Day 12 會談哪些資訊能帶到下一次互動;Day 19 再談換模型時,哪些供應商的狀態不能直接搬過去。
回到查延遲的例子,可以試著問自己:摘要寫著「資料庫查詢很慢」,原 trace 卻只顯示 queue 等待很長,能直接照摘要繼續查嗎?同一段摘要被引用三次,會變成三份互相支持的證據嗎?
第一題不行,衝突時要先回原始紀錄,核對當時的版本和時間範圍;第二題也不行,三次引用的是同一份摘要,來源只有一個,引用次數多不會多出證據。
摘要可以讓模型少讀一點,原始紀錄則讓錯誤還有機會被查出來。
今天看的是同一項任務裡的摘要。明天把時間拉長:哪些資訊值得帶到下次互動?曾經記住的偏好,過了三個月還該照做嗎?
Claude Code 的壓縮次數和 token 數,是 2026-09-25 從我電腦上的紀錄檔取的快照,取每次壓縮紀錄上的壓縮前後 token 數算中位數;壓縮分界的樣子和對話分岔,也是同一天從這些紀錄檔看的。
/compact 可以加指示決定摘要保留什麼;壓縮後重新載入 system prompt、CLAUDE.md 和 memory,重讀最近改過的最多五個檔案,放回用過的 skill。core/src/compact.rs 的摘要加最近使用者訊息(上限 20,000 token)和壓完的警告、prompts/templates/compact/ 的交接摘要指示和摘要前面那段話、protocol/src/openai_models.rs 的預設門檻 context window 九成、model-provider/src/provider.rs 接 OpenAI API 時改走伺服器端壓縮、core/src/session/mod.rs 把摘要和新歷史記成一筆壓縮、core/src/session/rollout_reconstruction.rs 從最新一筆壓縮接回、rollout/src/recorder.rs 的 session 紀錄檔只往後追加、thread-store/src/local/revert_thread.rs 回到舊訊息時開新紀錄檔、舊檔不動。讀的是原始碼,沒有實際跑過。hooks/fast-jev.ts、src/state.ts 和 src/compact.ts,沒有實際跑過。/rewind 選單挑一段摘要時還是同一個 session、原本的訊息留在紀錄檔;/rewind 的用法 Day 7 講過。View、Condensation 和 forgotten_event_ids 如何記錄摘要和被隱藏的來源事件。

 iThome鐵人賽
 看影片追技術