
🧾 模型讀的那份對話只有 loop 能寫,順序就是寫入順序。loop 忙著的時候進來的東西先進收件匣,收下記一筆、送達記一筆;「模型讀到了沒」不能從順序猜。
昨天在 Day 4|running 轉了一整天,是在等人還是掛了:任務狀態要記到別人接得下去,我們看了任務跑到一半要記什麼。快速回顧一下:worker 是跑 Day 1 那個 loop 的 process,跑一圈算一輪;Run 狀態和 checkpoint 記下任務做到哪、在等誰、等到了從哪裡繼續。今天看 loop 正在忙的時候進來的東西。
你在 Claude Code 跑到一半想到要補一句,打完按 Enter。那句話什麼時候到模型面前?
不是馬上。官方文件寫得很清楚:按 Enter 的時候 Claude 正在忙,它會把訊息排進佇列而不是打斷這一輪,列在輸入框上方;當下正在跑工具的話,要等那些工具跑完才在同一輪裡送進去。
差多久?自己量一次最快。挑一個會跑久一點的工具,中途補一句話,再打開那個 session 的紀錄檔對時間。我這次量到的是:按 Enter 09:41:09,模型那一輪的決定 09:41:13 送出去,裡面沒有那句話;09:41:14 工具結果回來,它才跟著一起進模型。
那句話的時間戳比模型那一輪早,模型卻沒讀到它。
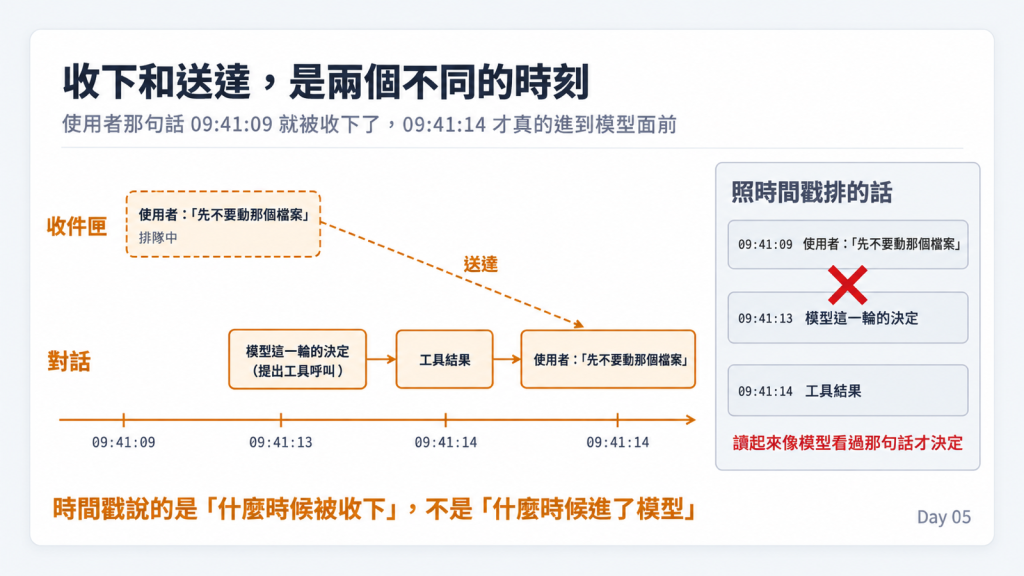
圖:那句話 09:41:09 被收下,09:41:14 才進對話。照寫入順序,它在模型那一輪後面;照時間戳排,它會跑到前面。
問題就在這五秒。假設你補的那句是「先不要 commit」,模型那一輪還是 commit 了。你打開紀錄想知道怎麼回事,看到 09:41:09 你說先不要 commit、09:41:13 模型決定跑 git commit——照這個順序讀,它是收到了還照做。於是你往 prompt 去找原因,加一條「使用者中途的指示優先」,下次還是一樣。那句話在模型做那個決定的時候還沒到它面前,規則加在哪裡都救不到。
會被這個順序騙到的不只是事後翻紀錄的人。畫面照時間戳排、你寫的分析腳本照時間戳排,結果都一樣。
所以這兩件事要分開記。模型讀的那份對話只有 loop 寫得進去,誰先被寫進去就排在前面,不看時間戳。訊息被收下的時候記一筆,真的被放進對話的時候再記一筆;想知道模型那一輪裡到底有沒有這句話,就去翻後面那一筆,不要用先後去猜。按停止走的是另一條路,不排隊,Day 6 講;換 process 之後怎麼接,Day 7 講。
所以整篇要回答的就一個問題:那句話什麼時候到了模型面前,事後要怎麼答得出來? 下面先分清楚有哪幾種順序、為什麼別人不能直接寫進對話,再看各家怎麼接、最少要存什麼,最後是畫面斷線和換 process 之後怎麼接回來。
同一句話,至少有三種順序:
開頭那個問題問的是第二種。收下順序只說明誰先被系統收下,畫面順序是給人看的,兩個都不告訴你模型讀到了沒。後面每一節都回到同一件事:這裡用的是哪一種順序?
時間戳幫得上忙的地方是找大約什麼時候發生。不同機器的時鐘可能不一樣,兩件事也可能同一毫秒,拿它排序遲早出事。這不是理論。剛才那個紀錄檔整個照時間戳重排一次,一千兩百多筆裡有七十幾筆會跑到前面去——同一台機器、同一個 session,還沒牽涉到跨機器的時鐘偏差。
這些問題沒有一個是 Agent 才有的。多個來源同時寫、時鐘不同步、從歷史重建狀態,《Designing Data-Intensive Applications》(下面簡稱 DDIA)整本都在處理。換到 Agent 上面,變的只是產生訊息的東西:模型、工具、使用者、通知。這邊提到只是想要表達 Harness Engineering 其實底層還是跟原本的系統設計密不可分,沒有憑空太多甚麼的新技術,而是一種新型態的軟體而已,針對系統類的知識大部分都可以沿用。
| 這篇講的 | DDIA 的說法 | 在哪一章 |
|---|---|---|
| 模型讀的對話是權威的那一份,畫面照它算出來 | system of record 和 derived data:權威來源只有一份,其他都能刪掉重算 | 第三部開頭 |
| 時間戳只拿來查大約時間 | 時鐘會偏,拿它決定先後會丟資料 | 分散式系統那章的 Unreliable Clocks |
| 照時間戳排也說不出誰影響了誰 | 全序和因果是兩件事,全序不告訴你誰依賴誰 | Consistency and Consensus 的 Ordering Guarantees |
要答得出「什麼時候到模型面前」,得先知道它為什麼不能一收到就進去。最直覺的做法是:API server 收到使用者的訊息,直接 append 到模型讀的那份對話後面。這條路走不通,而且擋住它的是 API 的規定。
模型那一輪如果提出了工具呼叫,Anthropic 的文件規定下一則訊息必須先帶著對應的結果回去,中間不能插別的訊息;而且在那則訊息裡,結果要排在最前面,文字只能接在所有結果後面。
所以位置只有一個:跟工具結果擠在同一則訊息裡,排在它們後面。使用者那句話有位置可去,只是那則訊息是 loop 在組的。API server 手上沒有那一輪的工具結果,組不出那則訊息;自己在後面 append 一則,下一次請求就打不出去。
這也解釋了 Claude Code 為什麼是「工具跑完才在同一輪裡送進去」:那個時間點,正好就是那則訊息在組的時候。OpenClaw 的文件把這條規則的代價寫得更明白——插話不會打斷已經在跑的工具,至於那些模型要求了、還沒開始跑的呼叫,它補一個「為了處理新進訊息而跳過」的假結果上去,讓每個呼叫都配得到一個結果,然後才把使用者那句話接在後面。
順便把幾個混著用的詞定一次,照 DDIA 的講法:
事件是一件已經發生、寫下來就不改的事。拿開頭那句話來說:你按下 Enter 的那一刻它還只是個請求,系統可以擋掉、可以叫它先排隊;等它被收下、寫進收件匣,才變成一件發生過的事。DDIA 在 Stream Processing 那章用 command 和 event 分這兩者,這篇講的「收下了才算數」就是它。
Event Log 是把這些事件留著、可以從任一個位置重讀的做法。DDIA 比較的兩種訊息傳遞方式,差別在訊息被讀走之後還在不在:傳統的 message broker,消費者說一聲收到了就把它刪掉,適合把工作分給誰做;log-based 那種是一直 append 進檔案不刪,誰讀到哪自己記,同一個 partition 裡順序不會亂。收件匣和對話都要能從中間某個位置再讀一次,所以走的是後面這種。
這件事沒有標準答案,但各家的選項是同一組:
前三種都是先把訊息留著、等 loop 回頭看一眼,差在什麼時候送、一次送幾則。佇列本身只是個放東西的地方,那句話會落在對話的哪個位置,是 loop 在哪幾個時間點回頭看它決定的。時間點挑在哪,跟上一節那條規則有關:要送進同一輪,loop 得先把工具呼叫都配好結果,才輪得到把新訊息接在後面。
順便提醒一句:網路上有一批分析 Claude Code 內部佇列的文章,會給你一個 class 名字和每秒幾萬則的吞吐量數字。那個名字是打包壓縮之後產生的變數名,可能隨版本改變,拿它當技術名詞搜不到能對照的東西;那些數字則沒有交代測的是哪個版本、哪一份程式。送達行為我以官方那一頁為準。
OpenClaw 的佇列文件把前三種列成可以選的模式,還講了一句很值得抄下來的話:使用者看到訊息送出、系統也回了 ack,不代表正在跑的那一輪已經吃到它。
這幾種選法會讓那句話落在對話的不同位置。共通的地方是:會排隊的 harness,通常把「收進佇列」和「交給模型」當成兩個不同的狀態在管,收下不等於算數。OpenClaw 甚至有一支只在送達開始前有效的撤回 API,送達開始之後就不保證撤得掉——分不出這兩個狀態,這種 API 根本寫不出來。
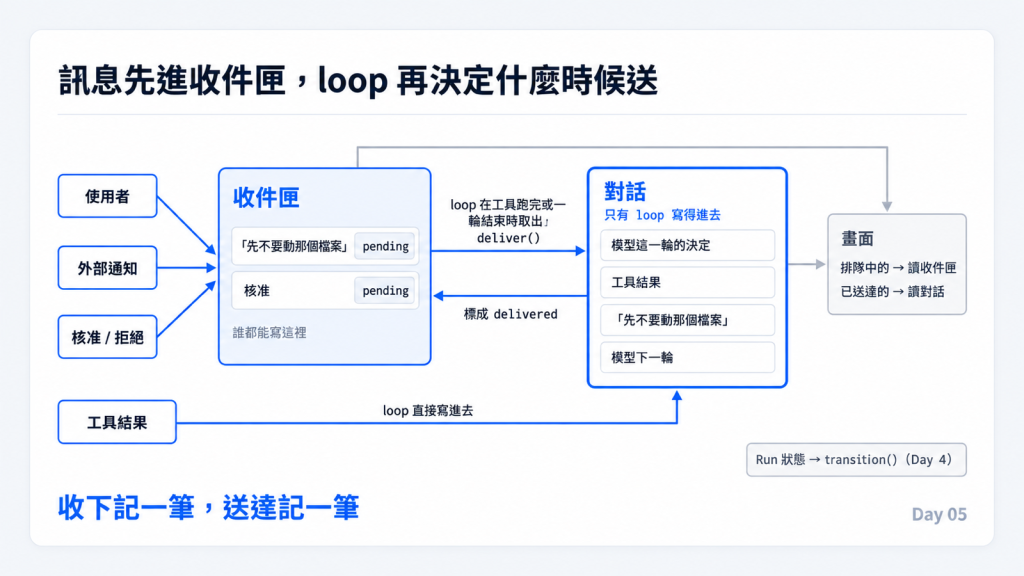
圖:使用者、通知和核准都只能寫收件匣,畫面照收件匣顯示「排隊中」;loop 在工具跑完或一輪結束時取出來寫進對話,同時把那一筆標成已送達。工具結果由 loop 直接寫進對話。
我會讓路線只有一條:
收下 → 進收件匣(畫面顯示排隊中)→ loop 在邊界取出 → 寫進對話(標記已送達)→ 下一次呼叫模型
不用把模型每個 token 都存成正式紀錄。但使用者的訊息、核准或拒絕、外部通知,這些會改變下一步的東西,一定要走這條路收下、存起來。
收下成功,不代表送達了。 收件匣寫進去之後,process 可能在 loop 取出它之前就沒了。訊息還在收件匣、狀態還是待送達,新的 process 才有辦法知道它存在。反過來說,如果收下的時候只留在記憶體裡,那句話就跟著 process 一起消失,使用者以為講了,模型永遠不知道。
寫進對話、把收件匣那一筆標成已送達,這兩個動作我會放在同一筆 transaction 裡:要嘛一起成功,要嘛當作都沒發生。分開做,中間掛掉就有兩種下場:對話裡有了、收件匣還寫著待送達,下次又送一次;或是標成送達了、對話裡根本沒有,那句話就這樣沒了。這招的前提是兩份紀錄在同一個資料庫。收件匣如果是另外一套 queue,一筆 transaction 管不到它,那就要走下一段講的 outbox。
不過同一筆 transaction 只保證這兩個動作一起成功,管不到這句話會不會被送第二次。舊的 process 其實還沒死透、或是呼叫的人沒收到回應又試了一次,都會讓同一句話再 append 一遍。所以取出來的時候要先看它還是不是 pending,這個檢查跟改狀態一起做,第二次來就拿不到東西了。
還有一層要講明白:這一筆記下的只是「loop 把它寫進對話了」。寫完之後到真的打出下一次請求,中間還是可能掛掉,請求本身也可能失敗。要連模型那邊收到沒有都答得出來,得另外記請求的結果。
通知要不要另外發,是同一個老問題。讓接收端自己照編號去讀最省事;不然就用 outbox,把要發的通知跟資料寫在同一筆 transaction 裡,另一個工作再送出去,AWS 的 outbox 文件和 CDC(change data capture,盯著資料庫的變更紀錄把事件撈出來發)都是這個路數。送出去可能重複,接收端要能去重。
把上面講的落成東西,我的最小版本是兩份紀錄,加一個收下、一個送達的 function。
對話,只有 loop 會寫。每一則要有的欄位:
| 欄位 | 這則的值 | 誰讀、拿來做什麼 |
|---|---|---|
id |
寫進去時給的 | 下一則的 parent;畫面續讀記到哪 |
parent |
上一則的 id | loop 組模型輸入時往回走;同一則後面長出第二條(重試、換個答案)時,分得出誰接在誰後面 |
role |
assistant | 決定放在 API 的哪一邊、畫面怎麼渲染 |
content |
模型提出的工具呼叫 | 模型輸入 |
at |
09:41:13 | 查大約時間,不拿來排序 |
收件匣,使用者、通知、核准都只能寫這裡:
| 欄位 | 那句話的值 | 誰讀、拿來做什麼 |
|---|---|---|
id |
收下時給的 | 畫面顯示排隊中;loop 送達時指名要送哪一筆 |
dedupe_key |
client 送出那一刻帶上的編號 | ack 掉在路上、client 又送一次同一句時,認得出是同一筆,不會收兩次 |
content |
使用者打的那句話 | 送達時複製進對話 |
accepted_at |
09:41:09 | 畫面顯示;事後查它什麼時候被收下 |
state |
pending / delivered / withdrawn | 接手的 process 判斷要不要送 |
delivered_at |
09:41:14 | 事後查它什麼時候被放進模型輸入 |
delivered_how |
同一輪塞入 / 下一輪 / 打斷 | 三種進法模型讀到的東西不一樣,查問題要分得出來 |
delivered_entry |
對話裡那一則的 id | 兩份紀錄對得起來 |
# pseudocode:收下。API server、通知、核准都走這裡,不碰對話
def accept(session_id, content, dedupe_key=None):
    with store.transaction():
        if dedupe_key and (old := inbox.find(session_id, dedupe_key)):
            return already_have(old.id)              # 重送:回原本那筆
        item = inbox.append(session_id, content=content,
                            accepted_at=now(), state="pending")
    return ack(item.id)                              # ack 只代表收下

# pseudocode:送達。只有 loop 呼叫,兩件事在同一筆 transaction 裡
def deliver(session_id, item_id, parent_id, how):    # how = same_turn / next_turn / interrupt
    with store.transaction():
        item = inbox.get_pending(item_id)            # 已經送過就拿不到,這次不做事
        if not item:
            return None
        entry = chain.append(session_id, parent=parent_id, role="user",
                             content=item.content, at=now())
        inbox.mark(item_id, state="delivered", delivered_at=now(),
                   how=how, entry=entry.id)
    return entry
誰在什麼時候呼叫,用開頭那五秒走一遍:
| 誰 | 什麼時候 | 做什麼 | 結果 |
|---|---|---|---|
| API server | 使用者按 Enter | accept() |
09:41:09 進收件匣,畫面列在輸入框上方 |
| loop | 這一輪的工具跑完、還沒打下一次模型 | deliver(how="same_turn") |
09:41:14 進對話,接在工具結果後面 |
| loop | 這一輪結束、收件匣還有 | deliver(how="next_turn"),只送最舊一則 |
成為新一輪的開頭,其他繼續排 |
| loop | 收到使用者按 Esc | deliver(how="interrupt") |
打斷這一輪,排隊的馬上進對話 |
| 畫面 | 重連 | 從記住的位置往後讀 | 補完再接即時的 |
| 接手的 process | 重啟 | 載入對話,看收件匣還有沒有 pending | 照政策重送或顯示成待處理 |
把兩份東西擺在一起就看得出差在哪:
照時間戳排
  09:41:09  使用者那句話
  09:41:13  模型提出工具呼叫
  → 讀起來像模型看過才決定

照對話的寫入順序排
  09:41:13  模型提出工具呼叫
  09:41:14  使用者那句話(跟工具結果一起進去)
  → 模型是下一次呼叫才讀到
至少要有的就這幾樣:對話每一則有 id、只有 loop 寫得進去,順序就是寫入順序;收件匣每一筆有收下時間、狀態、送達時間和送達方式。少一樣,前面某個讀取端就做不了下一步——少了送達時間,事後查不出它什麼時候被放進模型輸入;少了狀態,接手的 process 不知道該不該重送。
前面兩節答的是模型那一邊。畫面是另一半:它斷線重連之後,也要接回同一份先後,不然使用者看到的順序又是一套。
重連要從一個位置接著讀,最順手的就是拿資料庫的自增主鍵來當這個位置:上次讀到 42,下次跟 server 要 42 以後的。
聽起來沒問題,可是這樣會漏訊息,而且漏掉的時候畫面不會報錯,你只會看到少了一句話。
為什麼?先把這個「號碼」拆開看。拿 PostgreSQL 當例子:你在表格上開一個會自己長大的 id 欄位(serial、identity 都是),背後是一個叫 sequence 的東西——資料庫裡專門發號碼的計數器。誰要新增一筆,就跟它要一個號碼(nextval()),它把手上的數字加一,把新號碼給那個人。官方文件說這個動作不會被插隊,好幾個連線同時要,每個人拿到的號碼都不一樣。
還有一個詞後面會一直用:transaction。它是一組綁在一起的動作,中間可以寫好幾筆,最後 commit(提交)才一起生效,別人這時候才看得到;中途放棄叫 rollback,那一組動作就當作沒發生過。
所以自增主鍵給你的保證只有兩個:號碼不重複、後拿到的比較大。它沒保證號碼是連著的,也沒保證號碼小的那筆你會先讀到。續讀偏偏就是靠後面這件事。
先說號碼連不連得起來,這個好解決。同一份文件寫著:transaction 中途放棄的時候,它已經拿走的號碼不會還回去。理由也講了——要是每次放棄都把號碼收回來重排,其他同時在要號碼的 transaction 就得停下來等。文件自己下的結論是:PostgreSQL 的 sequence 不能拿來做「保證不跳號」的編號。所以看到 41 後面直接跳 43,中間那個 42 多半是某個 transaction 放棄掉了,資料沒漏,不用回頭去追。
會害你漏掉訊息的是另一件事:號碼是進 transaction 的時候就拿走的,資料卻要等 commit 之後別人才看得到。這兩個時間點中間隔多久,由那個 transaction 自己決定,中間可能還要寫別的表、呼叫別的服務。看這條假設的時間線:
T1 取得 id 41,還沒提交
T2 取得 id 42,先提交
讀取端看到 42,記下次從 id > 42 繼續
T1 接著提交 41
結果:下次讀取跳過了 41
關鍵在讀取端看得到什麼。PostgreSQL 預設的讀取規則叫 Read Committed,一句話:一個查詢只看得到「查詢開始之前就已經 commit」的資料,還沒 commit 的它看不到。所以畫面 server 跑那次查詢的時候,41 還躺在 T1 那個沒提交的 transaction 裡,在它眼裡等於不存在;它看到最大的是 42,就把位置記成 42。等 T1 提交、41 冒出來,它已經走過那個位置,往後只會要 42 以後的東西。41 就這樣被跳過去,沒有人會報錯。
這條時間線是我照那份文件推出來的反例,前提是寫入端沒有另外控制提交順序,不是真的發生過的事故。
對話那一份剛好不會踩到這個坑。只有 loop 一個寫入者,它寫完一則才寫下一則,編號自然就是提交順序。收件匣不一樣:使用者、通知、核准都在寫,同時開著好幾個 transaction,上面那個情況隨時會發生。所以畫面要續讀的那個編號,得自己另外保證。
保證的做法是在拿號碼到提交之間把計數器鎖住,中間不讓別人拿走下一個號。PostgreSQL 的 CREATE SEQUENCE 文件提到這種做法要鎖住放計數器的那張表,成本比一般 sequence 高。不過把範圍限制在一個 Session 裡,搶那個計數器的就只有這一個 Session,不會拖到全系統;划不划得來還是要看自己的量。DDIA 講 Partitioned Logs 是同一個結論:offset 只在一個 partition 內保證順序,跨 partition 沒有,不要想替整個系統排一條總順序。
畫面只更新到某一則就斷線,重連時要從下一則繼續。如果改成按時間戳抓整段歷史,同一毫秒的兩筆可能對調;即時訊息又剛好到,還會跟補送的重複。
這裡有個容易漏掉的地方:畫面上那一長條,其實是兩份東西拼起來的。已經進對話的那幾則是一份,收件匣裡還標著「排隊中」的那幾筆是另一份。兩份分開存,位置也就有兩個。所以重連的時候,要嘛兩邊各記一個位置,要嘛乾脆給推到畫面上的每一筆事件一個共用編號(同一個 Session 內編號不重複),client 只要記那一個。只記其中一份的位置,另一份就補不回來。
我會讓 client 記住最後套用到哪一則,server 在同一條連線上先補上之後的,再接著送即時的。先查一次歷史、另外開一個訂閱,兩者中間進來的就會漏掉。重複收到的要去重。LangChain 的 thread streaming 範例用 Last-Event-ID 續接,就是這種做法。
接手的 process 不一樣,它不需要「從哪一則開始讀」——對話整條載進來就是模型的輸入,這是單一寫入者換來的。它要處理的是收件匣裡還是 pending 的那幾筆:重送一次,或是顯示成待處理、要使用者自己再送一次。兩種都行,但要先知道它存在,所以收下那一刻就得落地。
工具跑到一半 process 就沒了怎麼辦?不用重建模型當時讀了什麼。Claude Code 的官方說明是:上一個 process 結束時還在跑的工具,resume 之後不會補跑也不會完成,Claude 就在沒有那個輸出的情況下繼續。顯示失敗、讓模型接著判斷,比硬要重現當時的輸入實在得多。
Cursor 的回顧提到另一種情況:有些輸出已經串流到畫面,那一步失敗後重跑,畫面需要 rewind,也就是收回先前那段暫時輸出,再顯示新的。所以逐字輸出和已經寫進對話的內容,不能用同一種方式追加。
假設你已經做到 Day 4:對話用 session id 存起來、有 Run 表和 transition()。現在那份對話是一個 list,誰都能往裡面 append。照這個順序加:
先把對話變成只有 loop 能寫。 每一則加上 id、parent 和 role,寫入只走一個 function。API server 拿不到那個 function,它只能呼叫 accept()。做完這步,模型輸入照什麼順序組出來就固定了,也不會再撞到工具結果那條規則。
再加收件匣。 收下一筆、送達一筆,狀態從 pending 變 delivered。Day 2 講過要留下「這輪輸入與資料來源」,送達那一筆就是它在這裡的具體樣子。做完這步,「它什麼時候進了模型輸入」有地方查了。
一次一個 process、使用者就坐在螢幕前的話,收件匣可以先只是一個 list 加一個「正在等的讀取端」:有人在等就直接交給他,沒人等就先放進 list。這樣夠用,但有幾個地方會咬人。一個是 list 沒有上限,哪天生產端換成另一支程式、不再是人的手速,得自己設一個。另一個是這種寫法只留得住一個正在等的讀取端,前一個還在等的時候後一個進來會把它蓋掉,前一個就再也等不到東西,所以要擋住第二個還沒做完的讀取。最後一個上面講過:東西只在記憶體裡,process 一沒,那句話就跟著沒了。
然後讓畫面照位置續讀。 client 記最後套用到哪一則,重連時補送、再接即時的,交接處去重。
loop 跑的時候如果根本不會有東西進來,做到第一步就夠,三種順序本來就一樣。那是指:一次一個 request、使用者不中途補話、沒有外部通知、也沒有即時畫面。破掉一條就往下加:會有東西中途進來,加第二步;有串流畫面、會斷線重連,加第三步。要讓使用者按得了停止,那是另外一條訊號路徑,明天講。
用現成框架的話,先看它有沒有替你做收件匣。多數只做到對話:Vercel AI SDK 的範例是 loop 沒跑完就把送出鈕鎖起來,LangGraph 那套 double texting 排的是整個 run,不是單一訊息的兩個狀態。中途進來的訊息怎麼存、怎麼標送達,還是你自己的事。已經有 queue 的,讓它管收下和去重,Harness 只管送達那一筆。
後面幾天會繼續往這裡加:Day 6 接上取消那條路,看取消先被收下還是工具結果先回來;Day 7 講這兩份紀錄和 checkpoint 存在哪裡、process 消失後怎麼接回來;Day 11 講 Context 太長要摘要時,模型實際讀到的跟對話裡存的就不再是同一份。今天先把「對話只有 loop 寫,收下和送達分開記」定下來。
回到開頭那五秒:那句話身上的時間戳比模型那一輪早,能不能因此說模型是看過它才做決定的?畫面重連的時候,能不能按時間戳把歷史重排一次?
第一題不能。時間戳只說明它比較早被收下,要看送達那一筆——09:41:14 才進對話,比模型那一輪晚。第二題也不行,同一毫秒的兩筆會對調,前面那個紀錄檔光是一個 session 就有七十幾筆會跑掉,要用 client 記住的位置續讀。
收下和到模型面前,是兩件事。 對話只有 loop 寫得進去,順序就是寫入順序;收下記一筆、送達記一筆。這樣畫面、接手的 process 和事後翻紀錄的人,問的雖然是不同問題,拿到的答案都對得起來。
今天講的是「loop 忙著的時候,東西要先放哪裡」。明天換一個角度:使用者按了停止。取消走的是另一條路,不排隊,收下那一筆還是要記。畫面不再更新,跟工作真的停下來,還有一段距離。
~/.claude/projects/<專案>/<session-id>.jsonl;文件自己註明這個檔案的格式是內部的、會隨版本改變,所以我只拿它看時間、不拿欄位名當規格。上一個 process 結束時還在跑的工具,resume 之後不補跑也不完成。Last-Event-ID 的續接方式。

 iThome鐵人賽
 看影片追技術