
Amazon Kinesis 是 AWS 處理串流資料的服務。串流資料指的是持續不斷產生的資料,例如感測器每秒回報的讀數、網站上的每一次點擊、應用程式持續寫出的日誌。這類資料沒有「一批處理完就結束」的時間點,需要有服務一邊接收、一邊交給後續的系統處理或存放。
資料從產生到被分析,會經過四個階段:
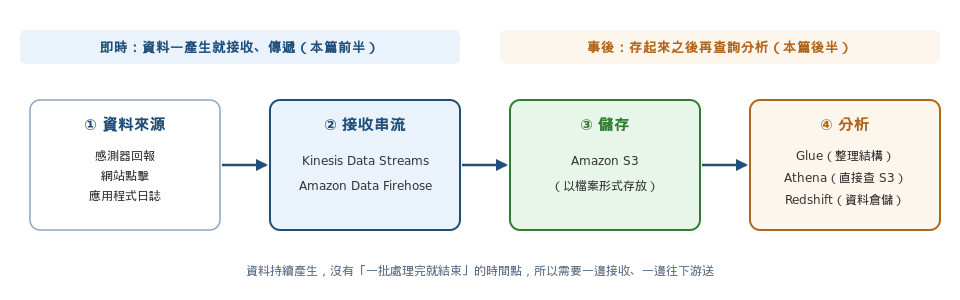
| 階段 | 負責的服務 | 本篇對應章節 |
|---|---|---|
| ① 資料來源 | 感測器、網站、應用程式 | — |
| ② 接收串流 | Kinesis Data Streams、Amazon Data Firehose | Data Streams、Firehose |
| ③ 儲存 | Amazon S3 | — |
| ④ 分析 | Glue、Athena、Redshift | 資料存進 S3 之後 |
| 名詞 | 意思 |
|---|---|
| Producer | 寫入資料的一方,例如感測器、網站後端 |
| Record(記錄) | 寫入的一筆資料 |
| Shard | 串流內部的分區。一個串流由一個或多個 shard 組成,每個 shard 的處理能力固定 |
| Partition key | 每筆記錄附帶的一個值,Kinesis 依它決定這筆記錄進哪個 shard |
| Consumer | 讀取資料的一方,可以是自己撰寫的程式,也可以是 Lambda |
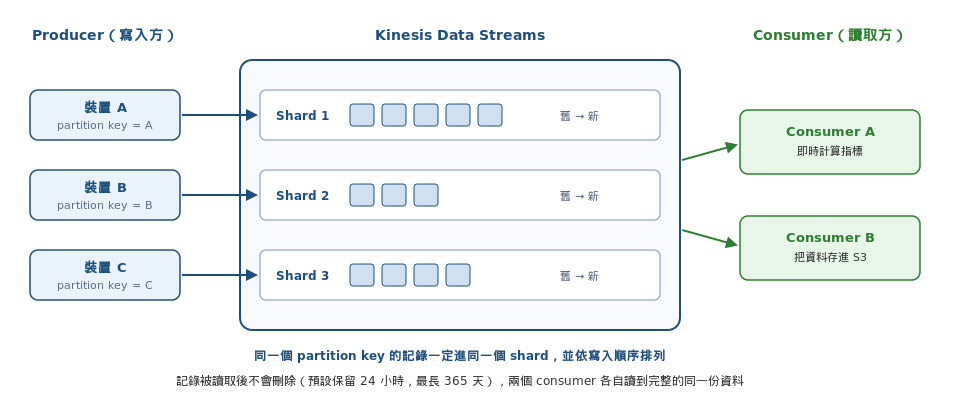
Producer 寫入記錄時附上 partition key,Kinesis 依這個值把記錄分配到某一個 shard。同一個 partition key 的記錄一定進同一個 shard,並依寫入順序排列,所以同一個 key 的資料讀出來時順序不會亂。
每個 shard 的處理能力固定:
| 方向 | 單一 shard 的上限 |
|---|---|
| 寫入 | 每秒 1 MB 或 1,000 筆記錄 |
| 讀取 | 每秒 2 MB |
整個串流的處理能力,等於 shard 數量乘上單一 shard 的上限。Partition key 的值如果種類太少,記錄會集中在少數幾個 shard,其他 shard 閒置;集中的那幾個 shard 一旦超過寫入上限,寫入就會被拒絕(ProvisionedThroughputExceededException)。因此 partition key 應選用值多、分布平均的欄位,例如使用者 ID、裝置 ID。
Consumer 讀取記錄後,記錄仍留在串流中,預設保留 24 小時,可以延長到 365 天。這帶來兩個特性:
| 設定 | 說明 |
|---|---|
| Enhanced fan-out | 一般情況下,一個 shard 每秒 2 MB 的讀取額度由所有 consumer 共用。啟用 enhanced fan-out 後,每個註冊的 consumer 各自擁有每秒 2 MB,consumer 之間的讀取速度互不影響 |
| 容量模式 | Provisioned:自己指定 shard 數量。On-demand:依流量自動調整 shard 數量。兩種模式下,單一 partition key 的寫入都仍受單一 shard 的上限限制 |
原名 Kinesis Data Firehose,2024 年 2 月改名為 Amazon Data Firehose,功能不變;舊教材和考古題常看到舊名,指的是同一個服務。
Amazon Data Firehose 是把串流資料送到指定目的地的服務。使用者不需要撰寫 consumer,也不需要設定 shard,容量依流量自動調整。
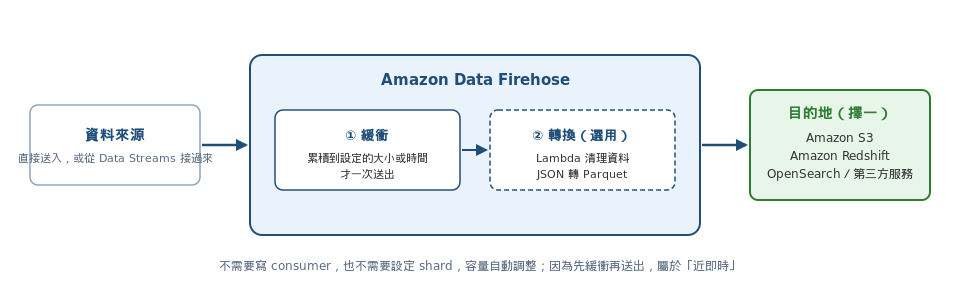
資料進入 Firehose 後,依序經過:
| 步驟 | 說明 |
|---|---|
| 緩衝 | 資料先累積到設定的大小或時間,再一次送出。因為有這段等待,Firehose 屬於「近即時」,不是毫秒級 |
| 轉換(選用) | 可以掛一個 Lambda 清理或改寫資料;也可以依 Glue Data Catalog 的資料表結構,把 JSON 轉成 Parquet 等欄式格式,減少之後 Athena 查詢時掃描的資料量 |
| 送達 | 每個 Firehose 串流設定一個目的地:S3、Redshift、OpenSearch,或第三方服務 |
| Kinesis Data Streams | Amazon Data Firehose | |
|---|---|---|
| 誰讀資料 | 自己的 consumer 讀取 | Firehose 自動送到目的地 |
| 即時性 | 毫秒級 | 近即時(依緩衝設定) |
| 資料是否保留 | 保留 24 小時~365 天,可重新讀取 | 送達後不保留在 Firehose |
| 管理負擔 | 要決定 shard 數量(或使用 on-demand) | 不用管容量 |
選擇依據:多個系統要各自即時處理同一份資料,或需要重新讀取時,用 Data Streams;只需要把資料送進 S3、Redshift 這類目的地存放時,用 Firehose。兩者也可以串接:Data Streams 給即時處理的 consumer 讀取,同時接一個 Firehose 把同一份資料存進 S3。
SQS、SNS(Day 16)與 Kinesis 都能在系統之間傳遞資料,差別在讀取方式與資料是否保留:
| SQS | SNS | Kinesis Data Streams | |
|---|---|---|---|
| 資料怎麼送到讀取方 | 讀取方自己拉取 | SNS 主動推送 | 讀取方自己拉取 |
| 一筆資料給幾個讀取方 | 一個(處理完即刪除) | 所有訂閱者 | 多個 consumer 各自讀取 |
| 讀取後是否保留 | 不保留 | 不保留 | 保留 24 小時~365 天 |
| 適合用途 | 工作佇列、緩衝尖峰流量 | 通知、一對多推送 | 即時串流、多個系統分析同一份資料 |
串流資料存進 S3 後,通常需要用 SQL 查詢分析。這一段涉及三個服務:
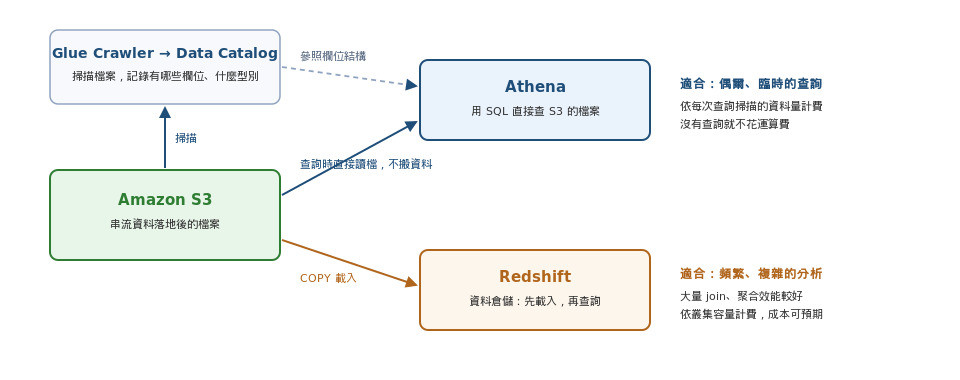
| 服務 | 作用 | 計費方式 | 適合情境 |
|---|---|---|---|
| Glue | Crawler 掃描 S3 裡的檔案,推斷有哪些欄位、什麼型別,記錄到 Data Catalog(資料表結構的目錄);另外提供 ETL job 做格式清理與轉換 | 依執行時間 | 讓 Athena、Redshift 知道檔案的欄位結構;資料需要先轉換格式時 |
| Athena | 用 SQL 直接查詢 S3 裡的檔案,參照 Data Catalog 的資料表結構,不需要先把資料搬進資料庫 | 依每次查詢掃描的資料量 | 偶爾、臨時的查詢 |
| Redshift | 資料倉儲。資料先載入(COPY)到 Redshift 自己的儲存,以欄式儲存、平行運算執行查詢 |
依叢集容量(Serverless 依運算用量) | 頻繁、複雜的分析,例如大量的 join 與聚合 |
Athena 的費用取決於掃描量,因此兩個做法能直接降低成本:資料依日期等條件分區存放,查詢時只掃需要的部分;改用 Parquet 等欄式格式,查詢時只讀需要的欄位。
選擇依據:偶爾查詢、不想維護任何資料庫,用 Athena;同一批資料每天被大量、反覆地做複雜查詢,載入 Redshift。
| 主題 | 說明 |
|---|---|
| Redshift Spectrum | 讓 Redshift 直接查詢 S3 上的資料而不載入,依掃描量另外計費;效能不如載入 Redshift 本身的資料 |
| OpenSearch | 全文檢索與日誌分析,例如搜尋應用程式日誌、建立視覺化儀表板;不用於關聯式查詢 |
| EMR | 受管的 Hadoop/Spark 叢集,需要自行控制運算框架、執行大規模平行運算時使用 |
| QuickSight | AWS 的 BI 視覺化工具,連接 Athena、Redshift,把查詢結果做成儀表板 |
| MSK | 受管的 Apache Kafka;團隊已經在使用 Kafka、要保留 Kafka 的 API 與工具時選用,功能與 Kinesis Data Streams 重疊 |
摘要:串流資料由 Kinesis 接收。多個系統要各自即時讀取或需要重播時,用 Data Streams;只需要把資料送去存放時,用 Firehose。資料存進 S3 後,臨時查詢用 Athena,頻繁的複雜分析用 Redshift,Glue 負責提供兩者需要的資料表結構。
某電商要把網站的點擊事件(JSON,每秒數千筆)存到 S3,給分析團隊用 Athena 查詢。分析團隊要求資料在 5 分鐘內就能查到,並以 Parquet 格式存放,以降低 Athena 掃描的資料量。資料工程團隊只有兩個人,公司希望以維運負擔最低(LEAST operational overhead)的方式建置。
哪一個方案的維運負擔最低?
某支付公司每秒有上萬筆交易事件,目前由應用程式直接寫進資料庫,兩個下游系統每分鐘輪詢資料庫取得新交易,已經拖慢了資料庫。詐欺偵測系統和即時營收儀表板都要各自即時讀取同一份完整的交易資料,而且兩邊的讀取速度不能互相影響。風控團隊另外要求:偵測模型更新後,要能把過去 3 天的交易重新跑一次。
哪兩項做法的組合最符合需求?(選擇兩項)
MessageGroupId 讀取訊息某車隊管理公司讓 8,000 台車輛每秒回報一次位置,寫進一個有 20 個 shard 的 Kinesis Data Streams,partition key 是車型(目前只有 3 種)。每台車的資料必須依時間順序處理。監控顯示整體寫入量遠低於 20 個 shard 的總額度,producer 卻頻繁收到
ProvisionedThroughputExceededException。公司希望在不增加成本的前提下解決這個問題。
解決方案架構師應該怎麼做?
某公司每天把約 50 GB 的應用程式日誌以 JSON 格式存進 S3,已經累積兩年。資安團隊每週會做幾次臨時的調查查詢,每次只看特定幾天、特定幾個欄位;日誌格式偶爾會新增欄位。公司目前沒有任何資料庫或分析叢集,希望讓資安團隊能用 SQL 查詢這些日誌。
哪一個方案最符合成本效益(MOST cost-effective)?
COPY 載入前一天的日誌,資安團隊在 Redshift 中查詢某零售公司的 BI 團隊以 Amazon QuickSight 儀表板分析 5 年的銷售資料(約 30 TB,存在 S3)。儀表板每天被 200 位主管開啟數千次,每次都要跨多張大表做複雜的 join 與聚合。目前直接以 Athena 查詢,常要等數十秒,查詢費用也隨使用量持續上升。公司希望大幅提高查詢效能,並讓頻繁查詢的成本變得可預期。
解決方案架構師應該怎麼做?
Amazon Data Firehose(前身是 Kinesis Data Firehose)可以直接把串流資料送到 S3,而且內建記錄格式轉換:參照 Glue Data Catalog 裡的資料表結構,在寫入前把 JSON 轉成 Parquet。把緩衝時間設在 5 分鐘以內,就能滿足「5 分鐘內可查」。容量自動擴展,不用管 shard,也不用寫任何轉換程式,維運負擔最低。
A 能做到,但要自己寫 consumer、管理 EC2 和 shard 數量,對兩人的團隊來說負擔最重。B 也能做到,但轉換和寫檔的程式要自己寫;Lambda 每批只處理少量訊息,會在 S3 產生大量小檔案,反而拖慢 Athena 查詢。D 每天才轉換一次,違反「5 分鐘內可查」。
Kinesis Data Streams 的記錄被讀走後不會消失,多個 consumer 可以各自讀取同一份資料。把保留期間延長到 7 天,模型更新後就能從 3 天前的位置重新讀一次。enhanced fan-out 讓每個註冊的 consumer 在每個 shard 上都有專屬的每秒 2 MB 讀取吞吐量,詐欺系統和儀表板的讀取互不影響。兩項合起來,三個需求都滿足了。
B 能讓兩個系統各收一份,但 SQS 的訊息被處理並刪除後就沒了,沒辦法把 3 天前已經處理過的交易重新跑一次。C 是誤解:一個 Firehose 串流只能設定一個傳送目的地,而且它是用來把資料送進 S3、Redshift 這類儲存,不是給應用程式即時讀取的。E 是誤解:一則 SQS 訊息只會被一個 consumer 取走,MessageGroupId 是用來分組排序的,不能讓兩個系統各自讀到完整的資料。
每個 shard 的寫入上限是每秒 1,000 筆或 1 MB,而同一個 partition key 的記錄都會進同一個 shard。partition key 只有 3 種車型,8,000 台車的寫入最多只會集中在 3 個 shard 上,平均每個 key 每秒約 2,700 筆,遠超過單一 shard 的上限,其他 17 個 shard 幾乎閒置。改用車輛 ID 當 partition key,8,000 個值會平均散到 20 個 shard;同一台車永遠進同一個 shard,依時間的順序也保留下來,而且不增加任何成本。
A 是最直覺的做法,但 key 只有 3 種,再多的 shard 也只會用到其中 3 個,熱點依舊,費用卻加倍。C 解的是讀取端,這裡的錯誤發生在寫入端。D 也是誤解:on-demand 模式會自動分割熱的 shard,但單一 partition key 的寫入仍然受單一 shard 每秒 1,000 筆的上限限制,同一個 key 的流量沒辦法再分下去。
Athena 直接查 S3 裡的檔案,不用架任何伺服器或叢集,只依每次查詢掃描的資料量計費;每週只有幾次臨時查詢,這是最省的方式。Glue crawler 會掃描 S3 建立並更新 Data Catalog 的資料表結構,日誌新增欄位時也能跟著更新;日誌依日期分區存放,查詢指定日期時 Athena 只掃那幾天的資料,成本會再大幅降低。
A 是最有誘惑力的干擾項:Redshift Serverless 不用管叢集,只在查詢時計算運算費用;但兩年約 36 TB 的日誌都要載入 Redshift 的受管儲存、按月付儲存費,每天還要跑一次載入作業。對每週幾次、只看幾天資料的查詢來說,這些成本都比直接用 Athena 查 S3 高。B 的常駐 EMR 叢集一樣要持續付費,還要自己維護叢集。C 要把兩年、約 36 TB 的日誌匯入關聯式資料庫並維護 schema;日誌格式一改就要調整資料表,成本和維運負擔都最高。
Redshift 是資料倉儲,專為大量資料上頻繁、複雜的 join 與聚合設計:資料載入後以欄式儲存,並依叢集的運算資源平行執行查詢。儀表板每天查詢數千次,由 Redshift 處理的效能遠比每次都去 S3 掃描檔案的 Athena 好;而且以 provisioned 叢集(可再搭配 reserved nodes)計費時,費用依叢集的容量計算,不會隨查詢次數增加,成本可以預期。
B 多了一個 Redshift 叢集,資料卻仍留在 S3:Spectrum 每次查詢都要掃描 S3 上的檔案,並依掃描量另外計費,效能和成本的可預期性都不如把資料載入 Redshift 本身。C 能降低 Athena 的掃描量和費用,是好的最佳化;但每天數千次跨大表的複雜 join,仍然要每次從 S3 讀檔計算,延遲很難大幅下降,費用也還是跟著查詢次數增加。D 對完全相同的查詢有幫助,但主管們的篩選條件各不相同,能沿用的結果有限;複雜查詢本身的效能也沒有改善,費用還是跟著掃描量增加。


 iThome鐵人賽
 看影片追技術