
AWS Lambda 是 AWS 的 serverless(無伺服器)運算服務:使用者只需要上傳程式碼,並設定在什麼情況下執行它;執行程式碼所需的伺服器,由 AWS 負責準備、維護和擴展。
Lambda 裡的一段程式碼稱為一個函式(function)。函式平常不執行,也不計費;只有在指定的事件發生時(例如 S3 有新檔案上傳、API 收到請求),Lambda 才執行它,並依實際執行的時間計費。
無伺服器並非指不存在伺服器,而是指伺服器的佈建、維護與擴展皆由 AWS 負責,使用者無須、也無法直接管理底層伺服器。
這篇依序整理 Lambda 的運作方式與限制:
| 段落 | 內容 |
|---|---|
| 🆚 Lambda 與 EC2 | 兩種執行程式的方式差在哪裡 |
| ⚡ 呼叫方式 | 函式怎麼被執行:同步、非同步、event source mapping |
| 🧱 執行環境 | 函式實際在哪裡執行,執行完之後會怎樣 |
| 📈 併發 | 很多請求同時進來時,Lambda 怎麼處理,上限是多少 |
| 🥶 Cold start | 為什麼有些請求的回應特別慢,怎麼改善 |
| ⚙️ 記憶體與限制 | 函式能使用多少資源,最久能執行多久 |
| 💰 計費 | 費用怎麼計算 |
| 🌐 VPC | 函式怎麼連到 VPC 裡的資源 |
| 🌍 邊緣 | 在 CloudFront 邊緣節點執行程式:Lambda@Edge 與 CloudFront Functions |
Day 8 的 EC2 也能用來執行程式。兩者的差別在於誰管理伺服器,以及費用怎麼計算:
| EC2 | Lambda | |
|---|---|---|
| 使用者要管理的 | instance type、作業系統、修補程式 | 程式碼與設定 |
| 沒有請求時 | 執行個體持續運作並持續計費 | 不佔用資源,不計費 |
| 請求變多時 | 自己設定 Auto Scaling(Day 14)增加機器 | 自動增加執行環境 |
| 單次執行時間 | 不限 | 最長 15 分鐘 |
Lambda 免除了伺服器管理的工作,代價是存在若干使用限制,例如單次執行時間最長 15 分鐘。相關限制整理於後文的記憶體與限制一節。
讓 Lambda 執行一次函式,稱為一次呼叫(invoke)。發出呼叫的一方稱為呼叫端,可能是 API Gateway、S3 這類 AWS 服務,也可能是自己寫的程式。
函式的程式碼裡,必須有一個指定的 function 作為入口,稱為 handler。每次呼叫,Lambda 就執行一次 handler:
def handler(event, context):
    # event:呼叫端傳進來的資料,內容依呼叫端而不同
    #        例如 S3 會傳入新增檔案所在的 bucket 名稱與檔案名稱
    # context:這次執行的相關資訊,例如還剩多少可執行時間
    return "處理完成"    # 回傳值:這次執行的結果
呼叫端把事件交給 Lambda 時,有兩件事可能不同:
依這兩點,Lambda 的呼叫分成三種。下圖由上到下,依序是三種呼叫方式的流程:
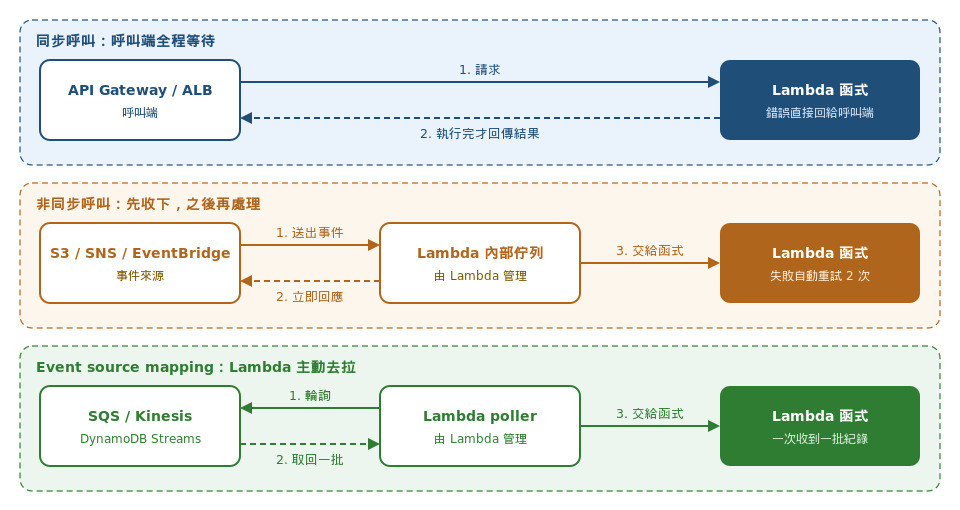
1. 同步呼叫(synchronous)
呼叫端必須等到結果才能繼續,所以同步呼叫用在需要立刻拿到結果的情況。例如 API Gateway 收到使用者的 HTTP 請求後呼叫函式,要拿到函式的執行結果,才能回應使用者。執行失敗時,錯誤直接回給呼叫端,要不要重試由呼叫端決定。
2. 非同步呼叫(asynchronous)
呼叫端在第 2 步就結束了,不會拿到函式的回傳值。S3、SNS、EventBridge(Day 17)都用這種方式呼叫 Lambda:這些服務只負責發出事件通知,不需要取得處理結果。執行失敗時,Lambda 會自動重試 2 次。
3. Event source mapping
前兩種都是呼叫端主動把事件送給 Lambda。但 SQS(Day 16)、Kinesis、DynamoDB Streams 這幾種服務只負責存放資料,不會主動通知任何人,要由使用的一方自己來取。
Event source mapping 是 Lambda 為這類服務提供的功能:
以 SQS 為例,函式處理成功後,Lambda 會替函式把訊息從佇列刪除;處理失敗就不刪除,訊息在 visibility timeout 後重新出現,再被取出處理一次。
三種方式整理如下:
| 呼叫方式 | 呼叫端等不等結果 | 事件怎麼進來 | 典型來源 | 失敗時 |
|---|---|---|---|---|
| 同步 | 等 | 呼叫端送來 | API Gateway、ALB、用 SDK 直接呼叫 | 錯誤回給呼叫端 |
| 非同步 | 不等 | 呼叫端送來 | S3、SNS、EventBridge | Lambda 自動重試 2 次;仍失敗可送到 DLQ 或 Destinations(見補充) |
| Event source mapping | 沒有外部的呼叫端 | Lambda 主動去取 | SQS、Kinesis、DynamoDB Streams | 依來源而定;SQS 的訊息會重新出現 |
**容易混淆的是 SQS:SQS 觸發 Lambda 的實際運作,並非 SQS 將訊息送給 Lambda,而是 Lambda 主動向 SQS 取出訊息。**SNS 觸發 Lambda 則是由 SNS 主動送出事件,屬於非同步呼叫。
另外,非同步呼叫的自動重試、SQS 訊息的重新出現,都可能讓同一個事件被函式處理不只一次。因此函式要設計成同一個事件處理兩次也不會出錯,也就是 Day 16 提過的 idempotent。
程式碼必須在運算資源上才能執行。Lambda 不開放使用者存取或管理底層伺服器,而是在需要執行函式時,為函式配置一個執行環境(execution environment)。
執行環境是 AWS 為函式配置的隔離運算環境,作用相當於一台專供該函式使用的小型虛擬機器,其中包含:
/tmp
每個執行環境彼此獨立,不共享記憶體,也不共享檔案。
一個執行環境從建立到被刪除,會經過三個階段:
| 階段 | 做的事 | 發生幾次 |
|---|---|---|
| Init(初始化) | 建立環境、下載程式碼、啟動 runtime,並執行 handler 以外的程式碼 | 每個環境只有一次 |
| Invoke(執行) | 執行 handler,處理一個請求 | 可以很多次 |
| Shutdown(回收) | 環境被 Lambda 刪除 | 一次 |
這張表有兩個重點:
下圖用時間軸呈現這兩點。橫軸是時間,每一列是一個執行環境:
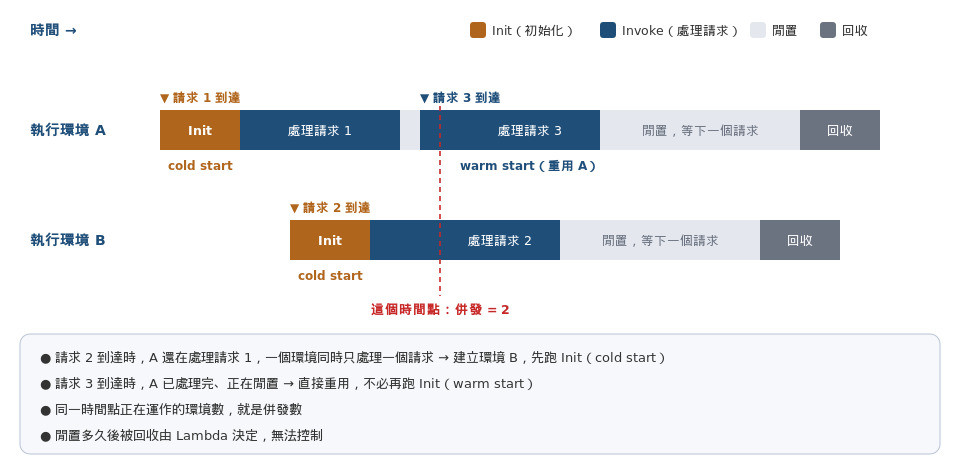
依時間順序看:
請求 1、2 都必須等待 Init 完成才開始處理,請求 3 則不需要;這段等待時間是後文 Cold start 一節的主題。請求 2 使執行環境增加為 A、B 兩個,則是下一節併發的主題。
Init 在每個環境只執行一次,所以 handler 外面的程式碼也只執行一次,之後同一個環境處理的每個請求都能共用它的結果。建立成本較高的東西,例如連線其他 AWS 服務用的 client、資料庫連線,通常放在 handler 外面:
import boto3

s3 = boto3.client("s3")        # 在 Init 執行,每個環境只建立一次

def handler(event, context):
    # 每個請求都會執行這裡,直接使用上面建立好的 s3
    s3.get_object(...)
如果放在 handler 裡面,每處理一個請求就要重新建立一次。
/tmp 的情況類似:寫進 /tmp 的檔案,在同一個環境裡會一直存在。但下一個請求不一定分到同一個環境,環境也隨時可能被回收,所以 /tmp 只能放暫時的檔案,不能用來保存需要留下來的資料。
**併發(concurrency)**是某個時間點上,同時正在處理請求的執行環境數量。
上一段提到,一個環境同一時間只處理一個請求。所以同時有幾個請求正在處理,就需要幾個執行環境,併發數就是多少:
某個時間點,同時有 3 個請求正在處理:
  請求 1 → 執行環境 A
  請求 2 → 執行環境 B
  請求 3 → 執行環境 C
→ 這個時間點的併發數 = 3
執行環境那張圖上的紅色虛線標的也是這件事:在那個時間點,環境 A、B 都在處理請求,併發數是 2。
併發數取決於兩件事:請求進來的速度,以及每個請求要處理多久。
併發數 ≈ 每秒請求數 × 每個請求的執行時間(秒)

例:每秒進來 10 個請求,每個請求要執行 2 秒
    → 任何一個時間點,最近 2 秒內進來的請求都還在處理中
    → 10 × 2 = 20 個請求同時在處理,併發數約 20
同樣的請求量,每個請求執行得越久,需要的併發數就越高。
Lambda 會依請求數自動建立執行環境,不需要像 EC2 那樣自己設定 Auto Scaling。但執行環境的數量不是無限的:
| 上限 | 說明 |
|---|---|
| 帳號併發上限 | 每個 Region 預設 1,000,同一個 Region 裡的所有函式共用,可以申請調高 |
| 擴展速率 | 每個函式每 10 秒最多增加 1,000 個執行環境 |
以上是 AWS 目前公布的數值,之後可能調整。
超過上限的請求,Lambda 不會執行,稱為節流(throttling):同步呼叫的呼叫端會直接收到錯誤(HTTP 429,表示請求太多);非同步呼叫的事件則由 Lambda 稍後自動重試。
帳號的併發上限是同一個 Region 裡所有函式共用的。假設上限是 1,000,函式 A 的請求暴增、用掉 950,函式 B 最多只剩 50 可用;即使函式 B 的流量完全正常,超過 50 的請求也會被節流。
Reserved concurrency 可以替單一函式設定一個固定的併發數。它同時有兩個作用:
| 作用 | 說明 |
|---|---|
| 保證 | 設定的額度專屬於該函式,其他函式無法使用 |
| 上限 | 這個函式的併發數最多只到設定值,超過的請求被節流 |
以上面的例子來說:
**Reserved concurrency 同時是保證,也是上限。**從名稱只能看出保留額度的作用,容易忽略它同時限制了函式本身的併發數。第二個作用常用來保護下游:函式會寫入資料庫時,限制函式的併發數,就等於限制了同時寫入資料庫的數量(VPC 一段會再提到)。
Reserved concurrency 不另外收費。設成 0 時,函式完全不會被執行,可以用來緊急停用一個函式。
回到執行環境那張圖:請求進來時,如果沒有閒置的環境可用,Lambda 必須建立新環境、先跑完 Init,才能開始處理請求。這段多出來的時間稱為 cold start。請求剛好分到一個已經跑過 Init、正在閒置的環境,就是 warm start,沒有這段額外時間。
Cold start 會發生在三種情況:
Cold start 的長短取決於 Init 要做多少事:
**Cold start 的影響程度,取決於呼叫端是否等待結果。**非同步呼叫的呼叫端不等待結果,額外的 Init 時間不影響呼叫端;同步呼叫的呼叫端持續等待,cold start 的時間會直接計入回應時間,例如 API 的回應延遲增加。
| 方式 | 做法 | 代價 |
|---|---|---|
| 精簡套件與初始化 | 減少 Init 本身要做的事 | 要調整程式與相依套件 |
| Provisioned concurrency | 預先建立指定數量的環境並跑完 Init,請求進來直接進入 Invoke | 不管有沒有請求,這些環境都持續計費 |
| SnapStart | 發布版本時先跑完 Init,把記憶體狀態存成快照;新環境直接從快照還原,跳過完整的初始化 | 支援的 runtime 有限(Java、Python、.NET);程式需處理從快照還原所衍生的狀態問題,例如亂數種子、網路連線 |
**Provisioned concurrency 能消除 cold start,但也部分放棄了 Lambda 不呼叫即不計費的特性。**為降低離峰時段的閒置費用,可搭配 Application Auto Scaling,依排程或使用率調整 provisioned concurrency 的數量。
SnapStart 適合 Java 這類初始化特別重的 runtime。依目前公布的計費方式,Java 使用 SnapStart 不另外收費;Python 與 .NET 則要另付快照的儲存與還原費用。
另一種做法是以 EventBridge 排程定時呼叫函式,使執行環境維持在已初始化的狀態,避免被回收。此做法只能維持少數幾個執行環境;當流量上升、需要更多併發時,新增的執行環境仍會發生 cold start。
Lambda 可以設定的運算資源只有一項:記憶體,範圍 128 MB 到 10,240 MB。CPU 不能單獨設定,而是依記憶體大小成比例分配:記憶體約 1,769 MB 時相當於 1 個 vCPU,最高到 6 個 vCPU。網路頻寬也隨記憶體增加。
**Lambda 僅能設定記憶體,CPU 隨記憶體成比例分配。**因此當函式執行緩慢、且瓶頸在 CPU 運算(例如圖片處理、壓縮)時,調高記憶體會同時增加 CPU,執行時間可能隨之縮短,即使原本的記憶體並未用盡。反之,若瓶頸在於等待外部服務回應,調高記憶體並不會縮短執行時間。
| 項目 | 上限 | 說明 |
|---|---|---|
| 執行時間(timeout) | 預設 3 秒,最長 900 秒(15 分鐘) | 超過就被強制終止。長時間的工作要拆成多次呼叫、交給 Step Functions(把多個步驟串成工作流程的服務,Day 17)協調,或改用 ECS/Fargate 這類容器服務 |
| 記憶體 | 128 MB~10,240 MB | CPU 依記憶體成比例分配 |
/tmp |
512 MB~10,240 MB,可以調整 | 只在該執行環境存在期間有效 |
| 部署套件 | zip 直接上傳:壓縮後 50 MB;解壓後(含 Layers)250 MB;container image:10 GB | 相依套件很大時,改用 container image 或 Layers(見補充) |
| 環境變數 | 合計 4 KB | 密碼這類敏感資訊放 Secrets Manager(Day 24) |
| 呼叫的資料大小(payload) | 同步:6 MB;非同步:1 MB | 大檔案放在 S3,事件裡只帶物件位置 |
上表是 AWS 目前公布的數值,之後可能調整,例如非同步的 payload 上限過去長期是 256 KB。
這些限制畫出了 Lambda 適合的工作:時間短、可以拆開、不需要保存狀態,例如檔案上傳後的處理、API 請求、消化佇列裡的訊息。需要長時間連續運算,或要在本機保存狀態的工作,放在 EC2 或容器服務比較合適。
Lambda 的費用分兩部分:
| 項目 | 計算方式 |
|---|---|
| 請求費 | 依呼叫次數計費 |
| 執行時間費 | 依 GB-秒 計費:設定的記憶體(GB)× 執行時間(秒),執行時間以 1 毫秒為單位 |
例:記憶體 512 MB(0.5 GB),每次執行 200 毫秒(0.2 秒),每月呼叫 100 萬次
    執行時間用量 = 0.5 GB × 0.2 秒 × 1,000,000 次 = 100,000 GB-秒
AWS 目前每月提供 100 萬次請求和 400,000 GB-秒的免費額度,以官方公布為準。
執行時間費等於記憶體乘以執行時間,所以調高記憶體不一定比較貴。以一個受 CPU 限制的函式為例:
1,024 MB × 8 秒 = 1 GB × 8 秒 = 8 GB-秒
2,048 MB × 4 秒 = 2 GB × 4 秒 = 8 GB-秒   ← 記憶體加倍、CPU 加倍、時間減半,費用一樣
實際能縮短多少,要看程式能不能用上多出來的 CPU,不一定剛好減半;這個例子要表達的是兩者的計費關係。
Cold start 一節提到的 provisioned concurrency 另行計費:費用依設定的執行環境數量與設定的時間長度計算,與實際是否有請求無關。
函式常常需要讀寫資料庫,例如 RDS;而 RDS 通常放在 VPC 的 private subnet 裡,不對網際網路開放(Day 5、Day 12)。
在沒有額外設定的情況下,Lambda 函式執行在 AWS 管理的網路中,不在使用者的 VPC 裡。這時函式可以連網際網路,也能連 S3、DynamoDB 這類 AWS 服務的公開端點,但連不到使用者 VPC 裡 private subnet 的資源。
要連到 RDS,需要在函式的設定裡指定要連接的 subnet 和 Security Group(Day 6)。Lambda 會在這些 subnet 裡建立 ENI(Elastic Network Interface,VPC 裡的虛擬網路卡),函式透過它和 VPC 內的資源通訊。函式的執行角色要有建立和管理 ENI 的權限,AWS 提供 AWSLambdaVPCAccessExecutionRole 這個受管政策。
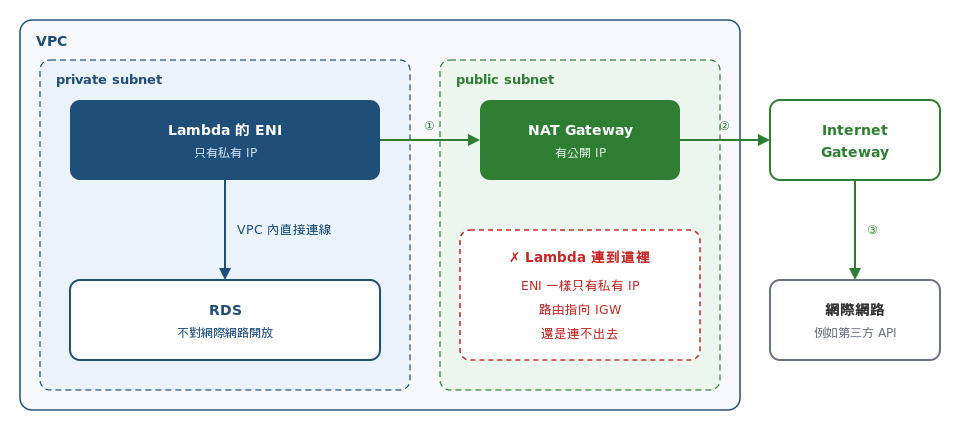
連接 VPC 之後,Lambda 的 ENI 只有私有 IP,這點會影響對外連線:
為了高可用,函式要連接多個 AZ 的 subnet,某個 AZ 出問題時,Lambda 仍然可以在其他 AZ 執行。
連上 RDS 之後,要回頭看併發那一段:每個執行環境各自建立自己的資料庫連線。併發數 400,就可能有 400 條連線同時連到資料庫,超過資料庫能接受的連線數。
常見的處理方式有兩種:
一般的 Lambda 函式執行在指定的某一個 Region。如果想在更靠近使用者的地方處理請求,例如在 CloudFront(Day 15)的邊緣節點改寫網址、加上 header,有兩種選擇。
CloudFront 處理一個請求時,有四個可以插入程式的時機:
使用者 ──viewer request──► CloudFront 邊緣節點 ──origin request──► 源站
使用者 ◄─viewer response── CloudFront 邊緣節點 ◄─origin response── 源站
viewer 事件發生在使用者和 CloudFront 之間,每個請求都會觸發;origin 事件發生在 CloudFront 和源站之間,只有快取沒命中、需要回源時才會觸發。
| CloudFront Functions | Lambda@Edge | |
|---|---|---|
| 可用的時機 | 只有 viewer request/viewer response | 四個都可以 |
| 執行環境 | 輕量的 JavaScript 執行環境 | Node.js 或 Python 的 Lambda runtime |
| 執行時間 | 次毫秒等級 | viewer 事件最長 5 秒,origin 事件最長 30 秒 |
| 呼叫外部服務 | 不行 | 可以 |
| 適合 | 改 header、改寫網址或轉址、簡單的存取控制 | 較複雜的邏輯、要查外部資料、要在 origin 事件處理 |
| 成本 | 極低,適合大量請求 | 較高 |
只是改 header 或網址,用 CloudFront Functions;要呼叫外部服務、邏輯比較完整,或必須在 origin 事件處理,才用 Lambda@Edge。
| 主題 | 說明 |
|---|---|
| Layers | 把共用的程式庫或相依套件包成獨立的 Layer,多個函式共用,不用每個函式各打包一份;一個函式最多 5 個 Layer |
| 版本與別名(Alias) | 函式可以發布多個不可變的版本,Alias 是指向某個版本的名稱。Alias 可以設權重,把部分流量(例如 10%)導向新版本,逐步發布。Provisioned concurrency 和 SnapStart 都設定在版本或 Alias 上 |
| Destinations | 非同步呼叫可以分別指定成功和失敗時,把執行結果送到 SQS、SNS、EventBridge 或另一個 Lambda。DLQ 只接失敗的事件;Destinations 成功、失敗都能處理,附帶的執行資訊也比較完整 |
| 執行角色(Execution role) | 函式執行時使用的 IAM Role(Day 3),決定函式能存取哪些 AWS 資源,例如讀取某個 S3 bucket、從 Secrets Manager 取得資料庫密碼 |
| 段落 | 解決的問題 | 重點 |
|---|---|---|
| 呼叫方式 | 函式怎麼被執行 | 同步呼叫等待結果、非同步呼叫不等待結果、event source mapping 由 Lambda 主動取出資料;同一事件可能處理不只一次 |
| 執行環境 | 程式跑在哪裡 | Init → Invoke → Shutdown;一個環境同時只處理一個請求;Init 的成果可以重用 |
| 併發 | 大量請求同時進入時的處理 | 併發數 ≈ 每秒請求數 × 執行時間;帳號額度共用;reserved concurrency 是保證也是上限 |
| Cold start | 為什麼有些請求慢 | 新環境要先跑 Init;provisioned concurrency 會持續計費,SnapStart 適合 Java |
| 記憶體與限制 | 能給多少資源 | 僅能設定記憶體,CPU 隨記憶體成比例分配;單次最長 15 分鐘 |
| 計費 | 費用怎麼算 | 請求數 + GB-秒;調高記憶體讓時間變短時,費用可能不變 |
| VPC | 怎麼連到私有資源 | 連接 VPC 後 ENI 只有私有 IP,對外要經 NAT Gateway;連線數用 reserved concurrency 或 RDS Proxy 控制 |
| 邊緣 | 程式放到 CloudFront | 簡單、大量用 CloudFront Functions;複雜或 origin 事件用 Lambda@Edge |
摘要:Lambda 只在事件發生時,在臨時的執行環境裡執行程式碼,依請求數和執行時間計費。一個環境同時只處理一個請求,所以請求變多就要增加環境,這就是併發;新環境要先初始化,這就是 cold start。15 分鐘的上限和只能調記憶體,決定了哪些工作適合交給 Lambda。
某公司用 Lambda 為上傳到 S3 的高解析照片產生多種尺寸的縮圖,函式目前配置 512 MB 記憶體。監控顯示每次執行約 40 秒,記憶體實際只用到約 300 MB,但 CPU 使用率始終滿載,使用者抱怨縮圖出來得太慢。公司希望以最少的開發工作縮短處理時間,而且整體費用不要明顯增加。
哪一個做法最符合這些需求?
某公司的帳號裡有兩個 Lambda:負責結帳 API 的
checkout,以及月底產生報表的report,帳號的併發上限是 1,000。每到月底,report被大量觸發,用掉帳號大部分的併發額度,導致checkout被節流、顧客無法結帳;report的大量併發也打爆了它查詢的資料庫,DBA 要求它同時執行數不得超過 50。公司不希望因此增加固定的費用。
哪兩項做法的組合最符合需求?(選擇兩項)
checkout 設定 reserved concurrency 300,保證它隨時能使用這 300 個併發額度checkout 設定 provisioned concurrency 300,讓 300 個執行環境事先熱著等待請求report 設定 reserved concurrency 50,讓它最多只能同時執行 50 個執行環境report 的記憶體調降到 128 MB,讓它每次執行時佔用較少的帳號併發資源checkout 前面加上一個 SQS queue,讓結帳請求先排隊,再交給 Lambda 依序處理某公司的 Lambda 需要讀寫放在 private subnet 的 RDS for PostgreSQL,同時要呼叫網際網路上第三方金流商的 HTTPS API。工程師把 Lambda 連到 VPC 的 public subnet(route table 有指向 Internet Gateway),結果連得到資料庫,但呼叫金流 API 一律逾時。資安規定資料庫不得暴露在網際網路上,公司要求以最安全的方式修正。
解決方案架構師應該怎麼做?
某公司的訂單查詢 API 由 API Gateway 呼叫一個以 Java 撰寫的 Lambda。框架初始化很重,遇到 cold start 時回應會拖到 6~8 秒。流量忽高忽低,一天只有幾個小時比較忙。產品團隊要求大幅縮短 cold start 的延遲,但財務部門不願意為閒置的執行環境持續付費,希望以最符合成本效益(MOST cost-effective)的方式處理。
哪一個做法最符合成本效益?
某媒體網站以 CloudFront 提供服務,每月約 50 億次請求。每個請求都要在邊緣依
User-Agent把網址改寫到行動版或桌面版的路徑,並在回應加上幾個安全相關的 header。這些邏輯都很簡單,執行時間在 1 毫秒以內,也不需要呼叫任何外部服務。公司希望以最符合成本效益的方式實作。
哪一個方案最符合這些需求?
User-Agent 改寫網址並在回應加上 headerLambda 的 CPU 是依記憶體配置比例分配的。這個函式是 CPU 滿載、記憶體用不完,瓶頸在 CPU,不在記憶體。把記憶體調到 2,048 MB,CPU 算力也跟著變成約 4 倍,CPU 受限的工作通常會接近等比例地縮短執行時間;Lambda 按「執行時間 × 記憶體」計費,時間縮短抵銷了單價的上升,總費用大致持平。只改一個設定,完全不用動程式碼。
A 解的是 cold start,但這裡慢的是每次 40 秒的執行本身,不是初始化。C 把工作拆成多個 Lambda 依序執行,總時間不會變短,還要重寫程式和維護工作流程。D 只放寬時間上限,函式本來就沒有逾時,處理速度一點都不會變快。
reserved concurrency 有兩個作用:替函式保留一塊額度,同時也是它的上限。替 checkout 保留 300,report 再怎麼暴增也搶不走這塊,結帳不會再被節流;替 report 設 50,它最多只能同時跑 50 個,資料庫就不會被打爆。reserved concurrency 本身不收費,符合「不增加固定費用」。
B 也能保證 checkout 有 300 個執行環境可用,但 provisioned concurrency 不管有沒有請求都持續計費,違反「不增加固定的費用」。D 是誤解:併發是以同時執行的環境數量計算的,跟記憶體大小無關,調低記憶體不會減少佔用的併發數,反而可能讓每次執行更慢、佔用更久。E 讓結帳請求排隊,但結帳 API 是同步回應的,顧客要等結果;而且只要 report 仍然佔滿額度,排隊的請求也還是等不到執行環境。
連到 VPC 的 Lambda,網路介面只有 private IP,就算放在 public subnet 也拿不到公開 IP,所以經過 Internet Gateway 一樣連不出去。正確做法是把 Lambda 放在 private subnet,讓預設路由指向 public subnet 裡的 NAT Gateway:對外連線經由 NAT 出去,資料庫依然留在 private subnet,不會暴露在網際網路上。
A 是誤解:Lambda 的網路介面由 Lambda 服務管理,不支援自己綁定 Elastic IP。B 方向對了一半:Lambda 確實該放在 private subnet,但它的網路介面沒有公開 IP,預設路由指向 Internet Gateway 一樣連不出去;沒有公開 IP 的資源要上網,必須經過 NAT Gateway。C 能讓 Lambda 同時連到資料庫和網際網路,但資料庫變成 publicly accessible,直接違反資安規定。
SnapStart 會在發布版本時先把執行環境初始化好並做成快照,之後有新的執行環境要啟動時,直接從快照還原,跳過繁重的框架初始化,cold start 可以大幅縮短。Java runtime 使用 SnapStart 不另外收費,沒有請求就不用付錢,符合財務部門的要求。
A 能徹底消除 cold start,但 provisioned concurrency 在設定的時段裡不管有沒有請求都持續計費;流量又忽高忽低,排程很難對準,正是財務部門不想要的「為閒置付費」。B 是常見的土法:定時呼叫只能讓一、兩個環境保持溫熱,流量一上來需要更多並行環境時,新環境還是會 cold start。D 能讓初始化快一些,但每次執行都要按 10 GB 的記憶體計費,成本大幅上升,改善幅度也不如 SnapStart。
CloudFront Functions 是專門為這種高流量、邏輯簡單的邊緣處理設計的:執行時間短、不需要呼叫外部服務,網址改寫和加上 header 都是它的典型用途。它的單價遠低於 Lambda@Edge,在每月 50 億次請求的規模下,費用差距非常明顯。
B 功能上完全做得到,但 Lambda@Edge 的單價和計費方式都比 CloudFront Functions 貴得多,用在這麼簡單的邏輯上是浪費。C 做對了一半:response headers policy 不用寫程式就能加上安全 header,很適合這部分;但 cache behavior 只依網址路徑比對,看不到 User-Agent,沒辦法決定要把請求改寫到行動版還是桌面版。D 把處理搬回源站那一側,每個請求都要多經過 API Gateway 和 Lambda 才能改寫,不只更貴,也失去在邊緣處理的低延遲。


 iThome鐵人賽
 看影片追技術