
Day 15 處理的是使用者怎麼連進系統。連進來之後,系統內部的服務也會互相呼叫,這一篇處理的是這一段。
以電視節目投票為例:前端 EC2 每收到一票,就直接寫入資料庫,等資料庫寫完才回應使用者。幾分鐘內幾十萬張票送進來時,資料庫寫不及,前端的請求等到逾時就失敗,這一票沒有被記錄。增加前端 EC2 也沒有用,前端變多,送到資料庫的寫入只會更多;資料庫本身也無法在幾分鐘內擴充,Day 12 的 read replica 只分擔讀取,不分擔寫入。
問題出在前端必須等資料庫寫完,才能回應使用者。所以資料庫慢,使用者就跟著等;資料庫停擺,前端也跟著停擺。訊息佇列要解決的,就是讓前端不必等資料庫。
訊息佇列是放在兩個服務之間的暫存區:
套回投票:前端 EC2 是 Producer,每一票是一則訊息;另外準備一組 worker EC2 當 Consumer,負責把票寫進資料庫。
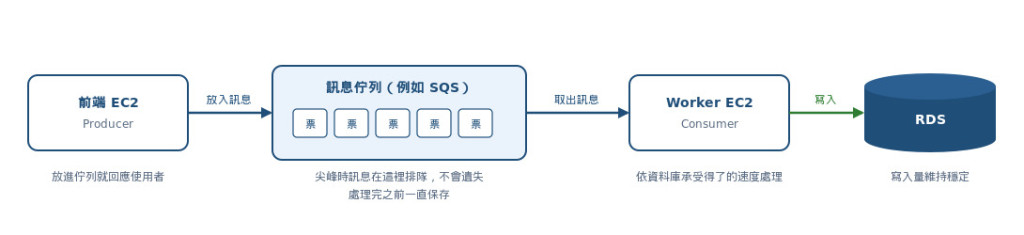
訊息佇列的設計目的有三個:
| 目的 | 說明 | 投票的例子 |
|---|---|---|
| 解耦(decoupling) | Producer 和 Consumer 不直接連線,一方變慢或停機,另一方照常運作 | 資料庫停擺時,前端照常收票;訊息留在佇列裡,等 worker 恢復再寫入 |
| 緩衝尖峰 | 進來的速度超過處理速度時,多出來的訊息在佇列裡排隊,不會遺失 | 幾十萬票在佇列裡排隊,worker 依資料庫承受得了的速度寫入 |
| 非同步處理 | Producer 不用等工作處理完成就能回應 | 票放進佇列就回應使用者,不必等資料庫寫完 |
Amazon SQS(Simple Queue Service)是 AWS 的全受管訊息佇列服務:不需要架設或維護任何伺服器,佇列容量自動擴展,訊息量沒有上限。
SQS 有兩項基本規則:
後面各段依序介紹以下功能:
| 功能 | 適用情境 | 運作方式 |
|---|---|---|
| ⏱️ visibility timeout | worker 處理到一半停機,訊息不能遺失,也不能被同時重複處理 | 訊息被取出後先隱藏,處理完主動刪除;沒刪除就重新出現 |
| 📬 Standard 與 FIFO | 有些工作要求照順序處理、不能重複 | 兩種佇列:Standard 吞吐量高但不保證順序;FIFO 保證順序、不重複 |
| 🔁 Long polling | 佇列常常是空的,worker 一直取到空回應,浪費 API 費用 | worker 取訊息時等待最多 20 秒,有訊息才回應 |
| 📈 自動增加 worker | 尖峰時佇列越排越長,固定數量的 worker 消化不完 | 依佇列長度讓 Auto Scaling 增減 worker |
| 📣 SNS fan-out | 一則訊息要給多個系統各自處理,但 SQS 的訊息被取走就刪除 | SNS 把一則訊息複製給多個 SQS 佇列 |
Worker 從佇列取出一則訊息後,可能在處理途中停機。SQS 必須決定,訊息被取出的當下要怎麼處理它。兩種單純的做法都有問題:
| 做法 | 結果 |
|---|---|
| 取出就刪除 | worker 處理到一半停機,訊息已經不在佇列裡,工作也沒完成,這一票遺失 |
| 取出後照樣留在佇列,其他 worker 也看得到 | 同一則訊息同時被好幾個 worker 取走,一票被算兩次,造成重複處理 |
SQS 採用兩者之間的做法,稱為 visibility timeout:
DeleteMessage,訊息才從佇列刪除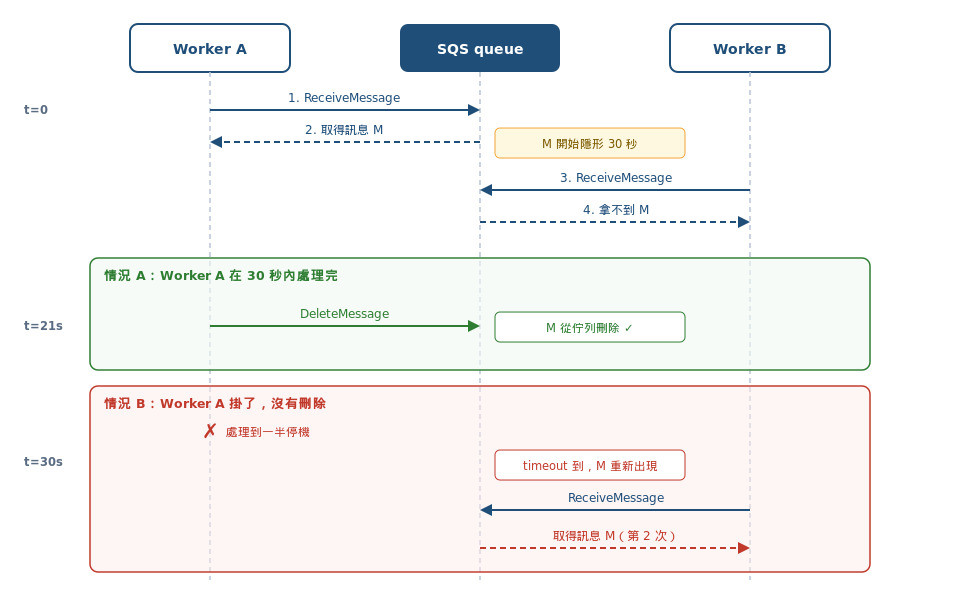
這個設計的取捨是:寧可重複處理,也不要遺失。重新出現的訊息可能已經被處理過一部分,所以 consumer 必須做到同一則訊息處理兩次,結果也不會出錯,稱為 idempotent。例如用每一票的編號當唯一鍵,第二次寫入時發現編號已存在就略過。
另外兩種情況的配套:
| 情況 | 做法 |
|---|---|
| 處理時間本來就比 visibility timeout 長 | 把佇列的 visibility timeout 調到比最長處理時間長;處理時間變化大時,worker 在處理中呼叫 ChangeMessageVisibility 延長。上限都是 12 小時。沒有調整的話,處理還沒完成訊息就重新出現,被其他 worker 重複處理 |
| 一則訊息一直處理失敗、反覆出現 | 設定 maxReceiveCount,被取出的次數超過上限就移到 Dead-Letter Queue(DLQ),留給人工檢查原因,避免無限重試 |
| Standard | FIFO | |
|---|---|---|
| 順序 | 盡量照順序,不保證 | 嚴格照順序(同一個 MessageGroupId 內) |
| 重複 | 至少一次,可能重複 | 剛好一次(5 分鐘內同一個 deduplication ID 會被去重) |
| 吞吐量 | 幾乎無上限 | 每秒 300 則,batch 可到 3,000 |
| 什麼時候用 | 絕大多數情況 | 順序不能錯(同一個帳戶的交易)、或不能重複(扣款) |
預設選 Standard。只有明講「順序」或「不能重複」才換 FIFO,而且要接受吞吐量的天花板。FIFO 佇列的名字一定以 .fifo 結尾。
預設是 short polling:worker 問一次,有就給、沒有就回空的,隔一下再問。佇列常常是空的時候,這樣一直問一直空,白繳 API 費用。
ReceiveMessage(WaitTimeSeconds = 20)
→ 有訊息:立刻回
→ 沒訊息:在那邊等,最多 20 秒,等到有或等到超時才回
空回應少很多,訊息到了也更快被拿走。實務上幾乎都開;「減少 API 呼叫次數、降低成本」指的就是它。
Worker 放在 Auto Scaling group 裡,但用 CPU 當指標不對——worker 在等訊息的時候 CPU 是低的,可是佇列可能已經堆了十萬則。正確的指標是佇列長度:
CloudWatch metric:  ApproximateNumberOfMessagesVisible(佇列裡等著被拉的訊息數)
自訂 metric:        每台積壓 = 訊息數 ÷ 目前 worker 台數
Target tracking:    讓「每台積壓」維持在目標值(例如 100)
→ 佇列變長 → 每台積壓上升 → ASG 加 worker;消化完 → 減回去
SQS 是一對一:一則訊息被一個 worker 拉走、刪掉,就沒了。一筆訂單成立後,庫存、出貨、通知三個系統都要各自處理——SQS 做不到,第一個拉走的就把它刪了。
Amazon SNS 是 pub/sub:發到一個 topic,所有訂閱者各收一份。訂閱者可以是 SQS、Lambda、HTTP endpoint、email。SNS 自己不存訊息,推出去就結束。
兩個接起來就是 fan-out:
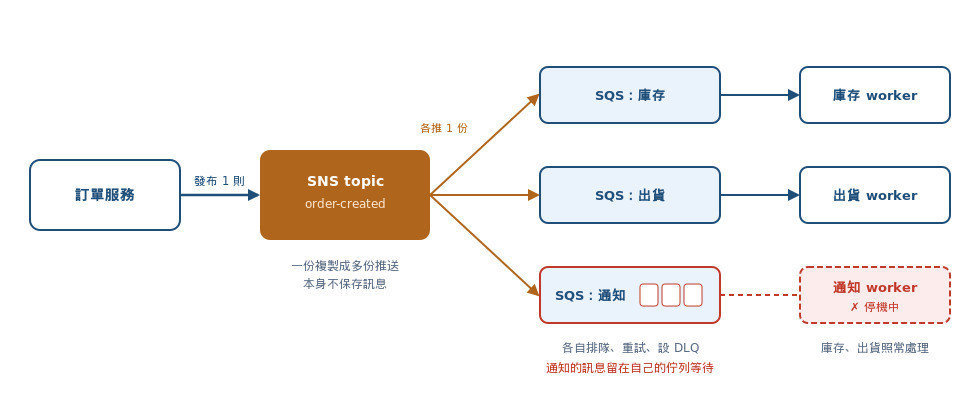
SNS 負責「一份變多份」,每個 SQS 各自排隊、各自重試、各自有 DLQ。哪個下游掛了,訊息在它自己的佇列裡等,不影響別人。SNS 還能設 filter policy,讓某個佇列只收特定屬性的訊息(例如只收金額大於一萬的訂單)。
| 誰去拿 | 一則訊息幾個人收 | 讀過還在嗎 | 用在 | |
|---|---|---|---|---|
| SQS | Consumer 自己拉 | 一個 | 刪了就沒了 | 工作佇列、削峰、解耦 |
| SNS | SNS 推出去 | 全部訂閱者 | 不保存 | 通知、fan-out |
| Kinesis | Consumer 自己拉 | 多個 consumer 各自讀同一份 | 保留 1–365 天,可以重播 | 即時串流、分析(Day 20) |
「多個系統要各自處理同一個事件」是 SNS + SQS;「即時分析」「重播」「順序且高吞吐」是 Kinesis;其他大多是 SQS。
| 主題 | 說明 |
|---|---|
| 訊息大小 | 上限 1 MiB(2025 年 8 月從 256 KB 調高,舊教材和考古題還常寫 256 KB)。更大的(例如圖片、影片)放 S3,訊息裡只帶 S3 的路徑 |
| 誰能送、誰能拉 | 靠 SQS 的 access policy(resource-based)。SNS 要能送進 SQS,佇列的 policy 要允許那個 topic |
| FIFO 配 FIFO | SNS 也有 FIFO topic,fan-out 要保順序時,FIFO topic 接 FIFO queue |
| Amazon MQ | 給已經在用 RabbitMQ、ActiveMQ 的既有系統搬上雲,不想改程式碼時用。新系統直接用 SQS/SNS |
| Lambda 當 consumer | 不用自己開 worker,Lambda 直接接 SQS 當觸發來源,處理完自動刪(Day 18) |
| 概念 | 說明 |
|---|---|
| 解耦 | 佇列放中間,producer 和 consumer 各跑各的速度,尖峰堆在佇列裡不遺失 |
| Visibility timeout | 訊息被拉走後先隱形,處理完要主動刪;沒刪就重新出現給別人拉 |
| Idempotent | 至少一次的代價:同一則處理兩次不能出事 |
| DLQ | 反覆失敗的訊息丟進去,不卡住主佇列 |
| Standard vs FIFO | 預設 Standard;要順序或去重才 FIFO,吞吐量有天花板 |
| Fan-out | SNS 一份變多份,每個下游各自一個 SQS |
摘要:SQS 把「來的速度」和「處理的速度」拆開。訊息被拉走不會消失,要主動刪,沒刪就會再出現——所以 consumer 要 idempotent。一則訊息要給多個系統,前面加 SNS 做 fan-out。
某影音平台用 Amazon SQS standard queue 派送轉檔工作,worker 是 Auto Scaling group 裡的 EC2。每個轉檔工作需要 8~12 分鐘,queue 的 visibility timeout 維持預設的 30 秒。最近發現同一支影片常被轉檔 3~4 次,運算費用明顯上升,但沒有任何 worker 當機或回報錯誤。公司希望以維運負擔最低(LEAST operational overhead)的方式解決這個問題。
解決方案架構師應該怎麼做?
WaitTimeSeconds 設為 20 秒,減少重複收到同一則訊息maxReceiveCount 設為 1,讓訊息第二次被收到時直接移走某電商的訂單服務每成立一筆訂單,就要通知庫存、出貨與詐欺偵測三個系統各自處理。任何一個下游系統停機維護數小時的期間,它的訊息都必須保留,恢復後再補處理,而且不能影響其他系統;詐欺偵測系統只需要處理金額超過 NT$30,000 的訂單。公司希望以維運負擔最低(LEAST operational overhead)的方式設計。
哪一個方案最符合需求?
某公司的報表服務由 SQS queue 接收產生報表的請求,worker 放在 Auto Scaling group 中,目前以平均 CPU 70% 為目標做 target tracking。請求量難以預測,常在幾分鐘內湧入上萬筆。每台 worker 一次處理一則,每則約 2 秒,大部分時間在等資料庫查詢,所以 CPU 一直很低,queue 積壓了數十分鐘都沒有加機器。公司要求每則請求在 10 分鐘內處理完,同時不讓 worker 在閒時空轉。
哪一個做法最符合成本效益(MOST cost-effective)?
某網路銀行把帳戶交易事件送進 SQS,由 worker 寫入帳務系統。同一個帳戶的交易必須嚴格依照發生順序處理,而且不能重複入帳;不同帳戶之間沒有順序要求。系統約有 50 萬個帳戶,尖峰時每秒約 2,000 筆交易,以 batch 方式送出。公司希望在滿足上述要求的前提下,讓多個 worker 盡量平行處理,縮短整體延遲。
解決方案架構師應該怎麼設計?
MessageGroupId,確保全部交易嚴格依序處理MessageGroupId、交易 ID 作為去重 ID某物流公司的 SQS standard queue 偶爾會收到格式錯誤的訊息。worker 每次處理都失敗、不會刪除它,訊息就在 visibility timeout 到期後反覆出現,連續好幾天佔用 worker 的處理時間。公司要求:這類訊息重試數次後就不要再佔用 worker;失敗的訊息要保留下來供工程師調查;出現這類訊息時要即時通知值班人員。
哪兩項做法的組合最符合需求?(選擇兩項)
maxReceiveCount 設為 5DeleteMessage 刪除訊息,並把錯誤內容與訊息本文寫進應用程式日誌visibility timeout 只有 30 秒,但轉檔要 8~12 分鐘:worker A 還在處理,30 秒一到訊息就重新出現,被 worker B 拉走,再過 30 秒又被 worker C 拉走……所以同一支影片被轉好幾次,而且沒有任何錯誤。把 visibility timeout 調到比最長處理時間多一些,處理中的訊息就不會重新出現。只要改一個 queue 屬性,維運負擔最低。如果處理時間的變化很大,也可以讓 worker 在處理過程中定期呼叫 ChangeMessageVisibility 延長期限。
A 是最常見的誤解:FIFO 的去重只針對「發送端在 5 分鐘內重複送出同一則訊息」,被接收後逾時重新出現的訊息,一樣會再被處理一次。C 的 long polling 減少的是空回應和 API 呼叫次數,跟訊息逾時後重新出現無關。D 會讓每一則訊息在 30 秒後被當成失敗,直接移到 DLQ,連正常的工作都沒辦法重試。
這是 SNS 加 SQS 的 fan-out:SNS 把每筆訂單事件複製給三個 SQS queue,每個系統有自己的 queue。某個系統停機時,訊息就在它自己的 queue 裡等(預設保留 4 天),恢復後再補處理,不影響其他系統。詐欺偵測 queue 的訂閱上設定 filter policy,只有金額超過 30,000 的訂單會送進去,詐欺系統不用自己過濾。全部都是受管服務的設定,維運負擔最低。
A 是誤解:一則 SQS 訊息只會被一個 consumer 拉走並刪除,三個系統會互相搶訊息,每筆訂單只有一個系統處理到。B 的問題在停機期間:SNS 自己不保存訊息,推送給 HTTPS endpoint 失敗時只能依 delivery policy 重試有限的次數,重試用完就丟棄(除非另外替訂閱設定 DLQ);系統恢復後也沒辦法依自己的速度慢慢補處理。C 可以做到多個 consumer 各自讀取,但要自己規劃 shard、管理每個 consumer 的讀取進度,詐欺系統還要自己寫過濾邏輯,維運負擔明顯比 D 高。
這個服務的瓶頸在積壓的訊息,不是 CPU,所以擴展要看「每台 worker 分到多少積壓」。每台一次處理一則、每則 2 秒,一台 10 分鐘能處理 300 則,把目標設為每台 300 則,就能保證積壓的訊息在 10 分鐘內處理完。積壓消化完後這個 metric 會下降,Auto Scaling group 就會縮回去,閒時不會有多餘的 worker 空轉。
B 仍然看 CPU,而這個 worker 大部分時間在等資料庫,積壓再多 CPU 也不會明顯上升,調低目標只會讓擴展時機更不穩定。C 能消化尖峰,但尖峰所需的台數要全天維持,違反「不讓 worker 在閒時空轉」。D 的前提是尖峰有固定時段,但題目說請求量難以預測,排程對不準實際的尖峰。
FIFO queue 的順序保證是以 MessageGroupId 為單位:同一個 group 的訊息嚴格依序交付,前一批還沒處理完(刪除)之前,這個 group 不會再交出新的訊息;不同 group 則可以同時交給不同的 worker。以帳戶 ID 當 group,就是「同一帳戶依序、不同帳戶平行」,完全對應需求;再啟用高吞吐量模式,以提高整個 queue 的吞吐上限。去重 ID 設為交易 ID,5 分鐘內重送的同一筆交易會被丟掉。不過 5 分鐘以外的重複還是要靠入帳程式本身具備冪等性(idempotent)。
A 等於在應用程式裡自己重做 FIFO:standard queue 可能重複交付,也可能晚到,worker 要等多久才能確定前一筆已經到了,很難做對。B 能保證順序,但所有交易都在同一個 group 裡,同一時間只有一個 worker 能拿到訊息,其他 worker 只能等,違反「盡量平行」。D 是誤解:standard queue 的至少一次交付可能讓同一則訊息被送出兩次,拉長 visibility timeout 只能避免逾時重送,沒辦法消除重複,也完全沒有處理順序。
redrive policy 讓一則訊息被接收超過 maxReceiveCount 次後,自動移到 dead-letter queue,不再佔用 worker;訊息在 DLQ 裡保留著,工程師可以慢慢調查,修好後還能 redrive 回原本的 queue。對 DLQ 的可見訊息數設 CloudWatch alarm,只要大於 0 就透過 SNS 通知值班人員。兩項合起來,三個要求都滿足了。
A 會讓所有來不及處理的正常訊息也一起過期,而且失敗的訊息會直接消失,沒辦法調查。C 雖然不再佔用 worker,日誌裡也留下了訊息內容可以調查,但只要失敗一次就刪除,連暫時性的錯誤都沒有重試的機會;修好之後也不能直接 redrive 重新處理,而且沒有人會被即時通知。E 只會讓失敗的訊息更頻繁地回來,更快佔滿 worker,方向相反。


 iThome鐵人賽
 看影片追技術